机器学习核心术语(ML / DL / RL)
1. 机器学习到底是什么?
30 秒先懂
机器学习:不把规则写死在程序里,而是让计算机从数据中自己找出规律,再用规律对新数据做预测或决策。
对比一下就清楚了:
1 | 传统编程: 数据 + 人写的规则 → 结果 |
例子:判断邮件是不是垃圾邮件。传统方法是人工写几百条规则(「包含免费就扣分」「全大写就扣分」……);机器学习是把一万封已标记的邮件喂给算法,让它自己总结出什么样的邮件容易是垃圾邮件。
AI、机器学习、深度学习是什么关系
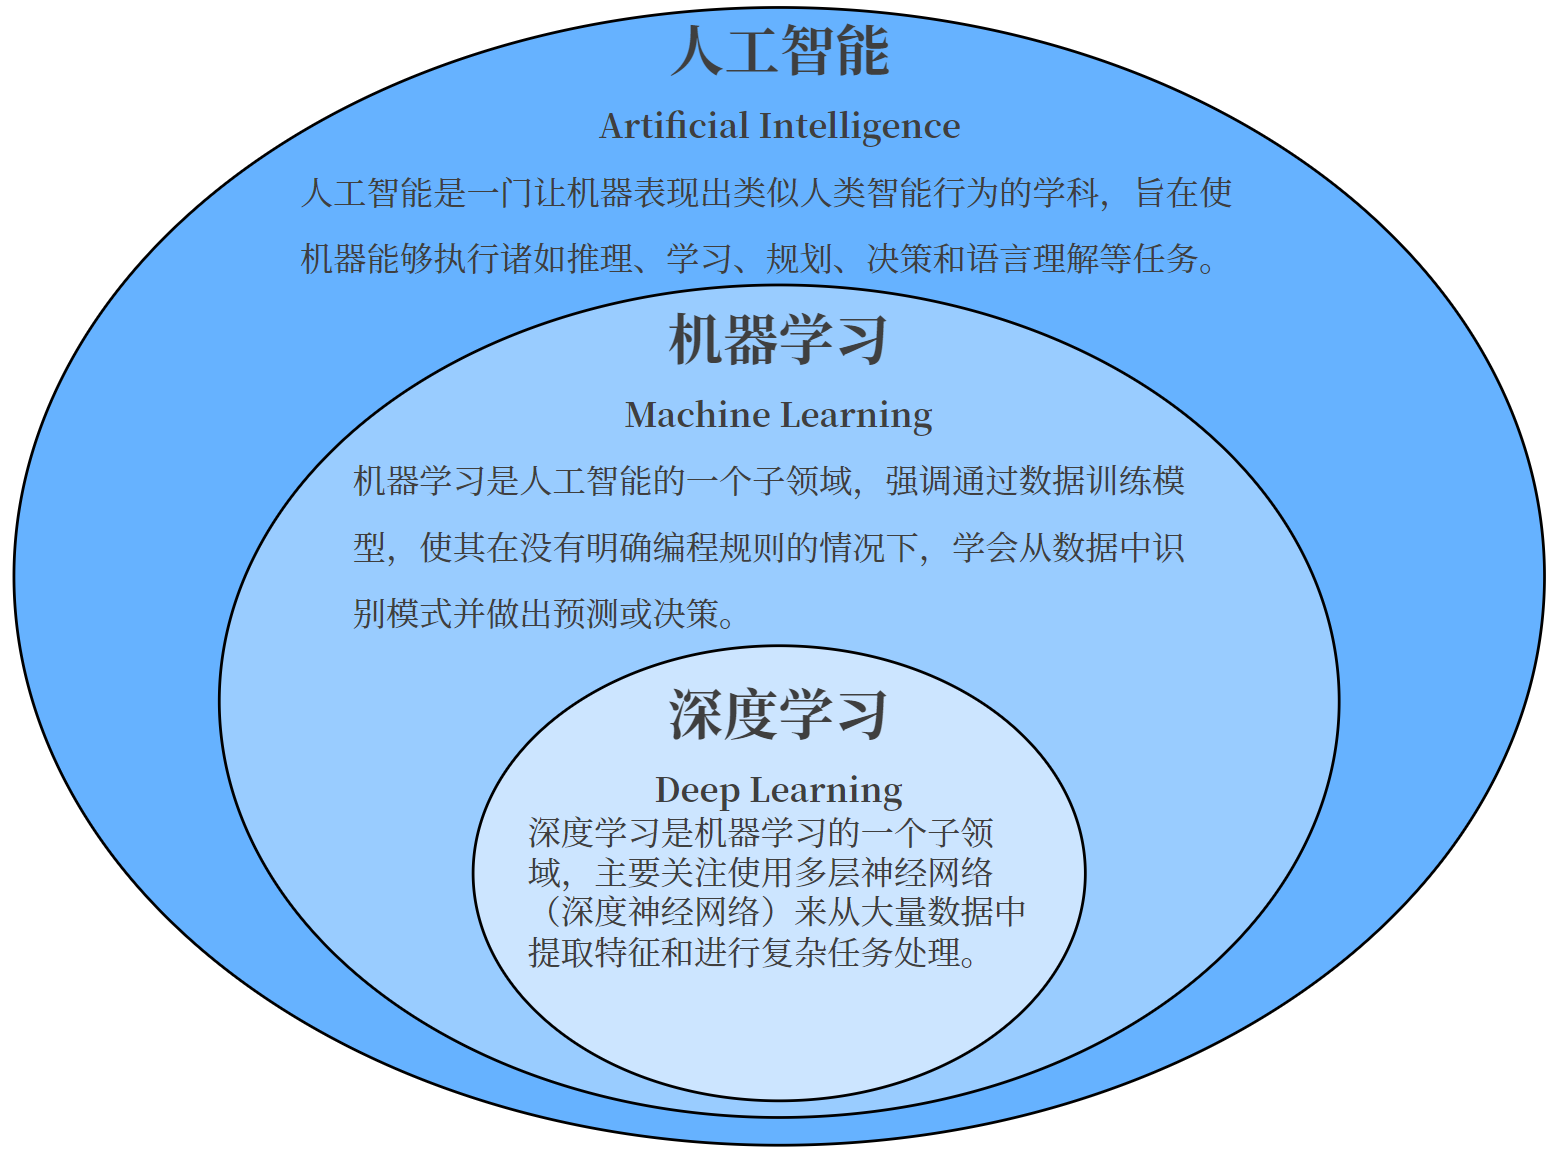
三句话记住包含关系:
- 人工智能(AI):最大的圈。让机器表现出类似人类的智能行为(推理、规划、决策、语言理解),实现手段多种多样——规则系统、符号逻辑、统计方法、机器学习都算。
- 机器学习(ML):AI 的一个子领域,就是上面说的「数据驱动」这条路。
- 深度学习(DL):机器学习的一个子领域,用多层神经网络来学,是当前大模型技术的基石。
机器学习是一门交叉学科,涉及概率论、统计学、逼近论、凸优化、算法复杂度理论等。
2. 机器学习拿什么学习:数据集与样本
机器学习的原材料是数据。以贯穿全篇的心脏病预测任务为例:给定病人的体检信息,预测是否患有心脏病。数据长这样:
| ID | 年龄 | 胸痛类型 | 静息血压 | 胆固醇 | 最大心率 | 主血管数量 | 地中海贫血 | 是否患有心脏病 |
|---|---|---|---|---|---|---|---|---|
| 0 | 52 | 0 | 125 | 212 | 168 | 2 | 3 | 0 |
| 1 | 53 | 0 | 140 | 203 | 155 | 0 | 3 | 0 |
| 5 | 59 | 1 | 140 | 221 | 164 | 0 | 2 | 1 |
- 数据集(Data Set):整张表,多条记录的集合。
- 样本(Sample):其中一行,描述一个对象(这里是一位病人)的完整记录。
记忆:一行一个样本,样本是机器学习的基本单位。
补充 顺便记下 sklearn/NumPy 的数据约定:特征矩阵
X.shape = (样本数, 特征数),标签y.shape = (样本数,)——读任何教程或报错信息,第一件事就是核对 shape。
3. 模型看到了什么:特征与特征向量
为什么需要这两个概念
模型不认识「病人」,只认识数字。所以每一列要有名字(特征),每一行要拼成数字向量(特征向量)才能喂给模型。
- 特征(Feature,也叫属性):一列,描述对象某一方面的性质——年龄、胆固醇、最大心率……
- 特征向量(Feature Vector):把一个样本的所有特征值按顺序排成向量。这才是模型真正的输入,比如 5 号病人:
$$x = (59,\ 1,\ 140,\ 221,\ 164,\ 0,\ 2)$$
补充 原始特征往往不能直接喂给模型——需要清洗缺失值、统一量纲、把文字类别变成数字。这类加工统称特征工程,是机器学习流程里最花时间、也最影响效果的一步。
4. 模型要预测什么:标签
- 标签(Label,也叫目标值 target):要预测的那一列。上面的例子里就是「是否患有心脏病」。
- 有标签的任务属于监督学习;标签这一列在预测时是藏起来的,模型的任务就是把它猜出来。
- 判断任务是分类还是回归,只看标签的类型:
- 标签是离散类别(患病 / 不患病)→ 分类;
- 标签是连续数值(房价、气温)→ 回归。
易错 看标签,别看特征。特征里有多少连续数值,都不改变「这是个分类任务」的事实。
5. 数据怎么分:训练集、验证集、测试集
为什么不能把所有数据都拿去训练
我们关心的不是模型「在见过的数据上」的表现——背题谁都会——而是「在没见过的数据上」的表现,这叫泛化能力。所以必须留一部分数据藏起来,等模型定型后才拿出来检验。藏起来的数据不能只有一个用途,于是分成三份:
| 数据集 | 英文 | 用途 | 类比 |
|---|---|---|---|
| 训练集 | Training Set | 训练模型(学参数) | 上课、做课后题 |
| 验证集 | Validation Set | 比较不同模型、调节超参数 | 模拟考,用来调整复习策略 |
| 测试集 | Test Set | 最终评估,只用一次 | 高考 |
最常犯的错误:反复用测试集看效果、顺手调参。这等于拿高考真题刷题——评估分数会虚高,因为它不再代表「没见过的数据」。
1 | from sklearn.model_selection import train_test_split |
补充 常见比例是 7:3 或 6:2:2(有验证集时)。数据少的时候,一次划分的偶然性会很大——解决办法叫交叉验证,属于「模型评估」话题,这里先记住职责分工即可。
补充(本系列黄金法则) 上面那种「偷看」有个正式名字:数据泄漏——凡是用验证/测试样本的信息(统计量、特征、阈值、超参数……)影响了训练过程的行为,都可能构成泄漏,评估结果随之虚高。后面每一篇都会反复回到这条法则。
6. 模型到底学什么:参数
30 秒先懂
参数(Parameter)是模型在训练过程中,从数据里自己学出来的数字。
为什么需要参数
用最简单的模型根据「每周学习时长」预测「考试成绩」:
$$\hat{y} = wx + b$$
逐个看符号:
| 符号 | 含义 |
|---|---|
| $x$ | 输入:每周学习时长 |
| $\hat{y}$ | 输出:模型预测的成绩 |
| $w$ | 斜率:每多学 1 小时,成绩应该加几分 |
| $b$ | 截距:不学习时的基准分 |
关键问题来了:模型一开始并不知道每多学 1 小时该加几分——「w 到底该是几」没法靠拍脑袋,只能从训练数据中学出来。这个被学出来的 $w$ 和 $b$,就是模型参数。
参数是怎么「学」出来的(走一遍数字)
训练开始时随便初始化:
1 | w = 0.1, b = 0 |
模型用它预测一个样本,发现误差很大。优化算法根据误差算出「该往哪个方向调、调多少」:
1 | 第 1 次更新:w = 0.18 |
最终的 0.31 和 -1.27 不是任何人手工指定的,而是训练过程产生的——这就是「学出来」的含义。在 sklearn 里它们分别存在 model.coef_(系数)和 model.intercept_(截距)里。
7. 我们控制什么:超参数
为什么还需要另一类「参数」
参数回答的是「学什么」,但有个问题它管不了:每次更新该走多大一步?
步子太大会一步跨过最优点,步子太小则学得极慢。这个「步长」叫学习率 $\eta$(读 eta),它描述的是「怎么学」,而不可能从数据里学出来——还没开始学,怎么可能知道该怎么学?它只能在训练前由人指定。这类数字叫超参数(Hyperparameter)。
在「模型求解」阶段会正式学梯度下降,这里提前看一眼更新公式的结构,认出各符号的角色即可:
$$w_{new} = w_{old} - \eta , \frac{\partial L}{\partial w}$$
| 符号 | 角色 | 是参数还是超参数? |
|---|---|---|
| $w$ | 模型参数 | ✅ 会被反复更新 |
| $L$ | 损失函数(预测误差的度量) | —— 是函数,不是数值 |
| $\dfrac{\partial L}{\partial w}$ | 梯度:该调大还是调小、趋势多急 | —— 每轮由数据算出 |
| $\eta$ | 学习率:每次走多大步 | ❌ 超参数,固定不变,人指定 |
看结构就明白了:**$w$ 在公式左边被更新,$\eta$ 永远站在右边当尺子**——一个学、一个管。
常见的超参数还有:正则化强度、KNN 里的 K、决策树的最大深度、神经网络的 batch size……
在代码里怎么认
1 | model = LogisticRegression(C=1.0) # C 是我们传进构造函数的 → 超参数 |
一个实用的判断法
以后看到一个量,问一句:
这个值是不是在
fit()的训练过程中,根据数据被优化出来的?
- 是 → 参数;
- 不是、是训练前由人指定/搜索出来的 → 超参数。
补充 超参数也不是凭感觉瞎设——实践中常用网格搜索(Grid Search)、随机搜索配合交叉验证来挑选最优值。但即使它是「搜出来的」,也依然是超参数:搜索发生在训练之外,不是
fit()优化的产物。
8. 一次训练到底发生了什么:fit 与 predict
fit(X, y) 的内部
1 | fit(x_train, y_train) |
输入是特征 + 标签;它基本没有「返回结果」,它的产出是模型对象本身被填充了参数。
补充 上面画的是「梯度下降类」模型的 fit——不同模型的 fit 干的事并不一样:线性回归在解方程,KNN 的 fit 只是存数据,PCA 的 fit 在估计均值和主成分,决策树的 fit 在递归寻找切分点。
fit的统一含义是:让对象从训练数据中学习/估计出它的内部状态——具体怎么学,由算法决定。
predict(X) 的内部
1 | predict(x_test) |
输入只有特征、没有标签;参数在预测时不再发生任何变化。
补充 一句话记住区别:fit 会改变模型(参数被更新),predict 只读模型(参数不动)。所以同一个训练好的模型可以对无数条新数据反复 predict,结果稳定不变。
9. 一张图收束:术语全景
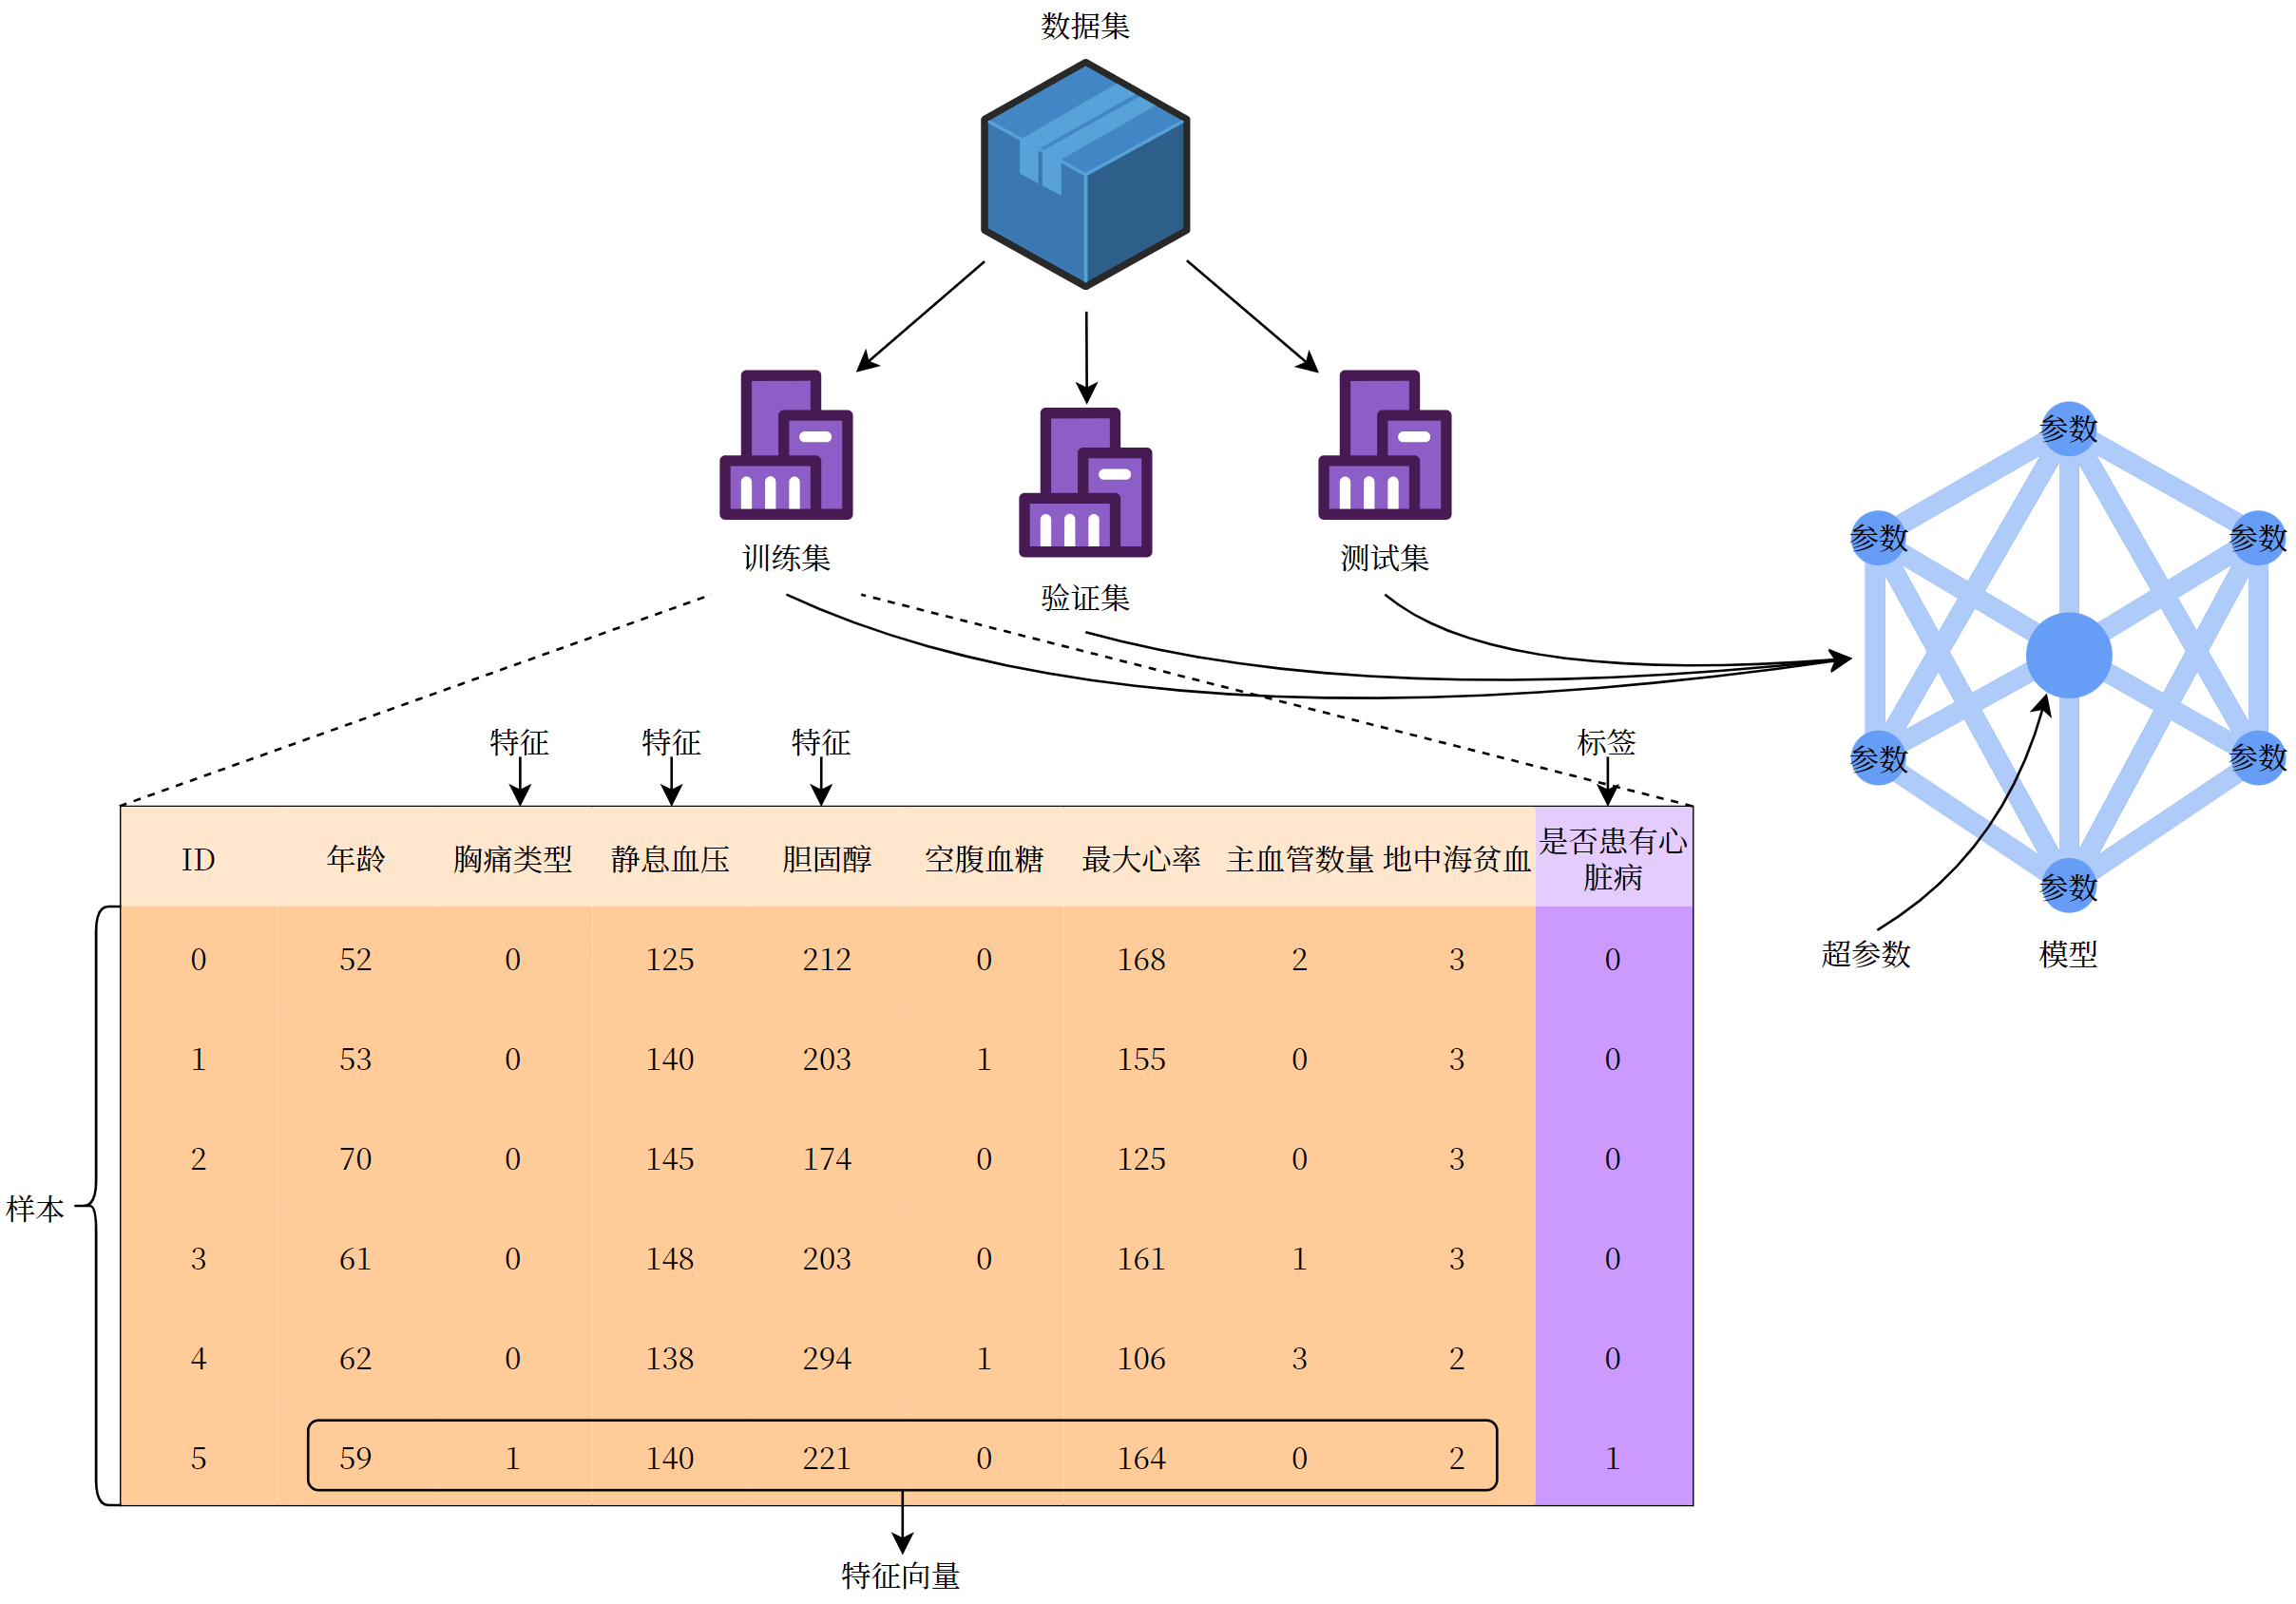
对照图检查一遍:一行是样本、一列是特征、最后一列是标签;数据分成训练集 / 验证集 / 测试集;训练集喂给模型学出参数,超参数由我们在训练前设定。全篇主线就是这张图。
10. 按有没有标签:四大学习范式
按「数据有没有标签、学习发生在哪里」,机器学习分成四类:
| 范式 | 英文 | 数据特点 | 典型任务与算法 |
|---|---|---|---|
| 有监督学习 | Supervised Learning | 样本有标签,学习映射 $X \to y$ | 分类、回归;如线性回归、逻辑回归、KNN、决策树、SVM |
| 无监督学习 | Unsupervised Learning | 样本无标签,从数据自身找结构 | 聚类、降维;如 K-means、PCA |
| 半监督学习 | Semi-supervised Learning | 少量有标签 + 大量无标签 | 用无标签数据辅助训练 |
| 强化学习 | Reinforcement Learning | 没有现成数据集,智能体在与环境交互中试错学习 | 游戏、机器人控制、大模型对齐(见下方速查) |
11. 扩展术语速查:深度学习与强化学习
这一节是查阅用的术语表,第一遍通读混个脸熟即可,不必记住;学到对应技术时再回来查。
11.1 深度学习
网络结构
| 术语 | 英文 | 一句话 |
|---|---|---|
| 神经元(节点) | Neuron / Node | 接收输入、加权求和、经激活函数输出的基本计算单元 |
| 权重 | Weight | 控制每个输入信号的重要性,就是上文的参数 w |
| 偏置 | Bias | 调整神经元被激活的难易程度,就是参数 b |
| 激活函数 | Activation Function | 引入非线性,否则多层网络等价于一层;常见 Sigmoid、Tanh、ReLU |
| 输入层 / 隐藏层 / 输出层 | Input / Hidden / Output Layer | 数据从输入层进、结果从输出层出 |
| 「深度」 | Depth | 隐藏层层数;层数多 = 网络深 |
训练过程
| 术语 | 英文 | 一句话 |
|---|---|---|
| 前向传播 | Forward Propagation | 数据从输入层到输出层算一遍,得到预测值 |
| 损失函数 | Loss Function | 度量预测与真实的差距,越小越好 |
| 反向传播 | Backpropagation | 把误差从输出层往回逐层求梯度,告诉每个参数怎么改 |
| 梯度下降 | Gradient Descent | 沿负梯度方向迭代更新参数(第 7 节的更新公式就是它) |
| 学习率 | Learning Rate | 每步走多大;过大发散、过小过慢(超参数) |
| 过拟合 / 欠拟合 | Overfitting / Underfitting | 训练好测试差 = 过拟合;两边都差 = 欠拟合 |
| Dropout | —— | 训练时随机丢弃一部分神经元,防过拟合 |
Epoch / Batch Size / Iteration 三兄弟(最易混):
| 术语 | 含义 | 假设 1000 个样本、batch size = 100 |
|---|---|---|
| Batch Size | 一次参数更新所用样本数 | 100 |
| Iteration | 参数更新一次 = 1 个 batch 过完 | 1 个 epoch 有 10 次迭代 |
| Epoch | 全部训练数据完整过一遍 | 10 个 epoch = 共 100 次迭代 |
经典模型与大模型
| 术语 | 一句话 |
|---|---|
| CNN(卷积神经网络) | 擅长图像;卷积核提取局部特征,池化压缩尺寸 |
| RNN / LSTM | 擅长序列;RNN 有梯度消失问题,LSTM 用门控改进 |
| Transformer | 大模型基石,完全基于注意力机制(论文 Attention Is All You Need) |
| 自注意力 Self-Attention | 让序列中每个位置按重要性「关注」其他位置 |
| 词嵌入 Embedding | 把词映射成向量,语义相近则向量相近 |
| 预训练 Pre-training | 海量无标注文本上自监督学习通用知识 |
| 微调 Fine-tuning | 在预训练模型上用少量领域数据继续训练 |
| Prompt / Token | 提示词 / 文本最小切分单位 |
| 多模态 | 一个模型同时理解文字、图像、语音等 |
| RLHF | 基于人类反馈的强化学习,ChatGPT 对齐训练的核心技术(见下) |
11.2 强化学习
与其他范式的根本区别:没有现成的数据集,数据是智能体自己「玩」出来的。
1 | ──────── 动作 a ────────▶ |
核心概念(以超级马里奥为类比):
| 术语 | 英文 | 含义 | 类比 |
|---|---|---|---|
| 智能体 | Agent | 做决策的学习者 | 马里奥 |
| 环境 | Environment | 智能体所处的世界 | 关卡画面 |
| 状态 | State (s) | 环境当前的情况 | 位置、前方有无水管 |
| 动作 | Action (a) | 可执行的操作 | 左移、右移、跳 |
| 奖励 | Reward (r) | 对动作的即时反馈(标量) | 吃金币 +1、掉坑 -1000 |
| 策略 | Policy (π) | 从状态到动作的映射,智能体的「大脑」 | 「看到水管就跳」 |
| 回合 | Episode | 从开始到结束的完整一轮 | 玩一条命 |
| 回报 | Return (G) | 一条轨迹上奖励的累积 | 整条命的得分 |
| 折扣因子 | Discount Factor (γ) | 0~1,未来奖励打折的程度 | 远处金币不如眼前值钱 |
| 值函数 | Value Function | 评估某个状态(或状态-动作对)有多好 | 「站这里的期望得分」 |
交互闭环:智能体在状态 s 下按策略 π 执行动作 a → 环境反馈奖励 r 并转移到新状态 s’ → 循环,目标是长期累积回报最大。
探索与利用的平衡:以概率 ε 随机尝试新动作(探索),以 1−ε 执行当前最优(利用),即 ε-贪婪策略。
常见算法名词:Q-Learning(学「状态-动作价值」Q(s,a) 的表格型算法)、DQN(用神经网络近似 Q 函数)、策略梯度(直接优化策略)、Actor-Critic(策略网络决策 + 价值网络打分)、PPO(近端策略优化,RLHF 的标准选择)。
RLHF 三步走(以 ChatGPT 为例):
- SFT:人工示范对话,先教会模型基本对话格式;
- 训练奖励模型 RM:人类对多个回答排序,训练出「打分器」;
- PPO 强化学习:模型生成回答、RM 打分当奖励,把模型对齐到人类偏好。
这里所有 RL 术语都能对上号:智能体 = 语言模型,动作 = 生成 token,奖励 = RM 打分。
12. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 参数 vs 超参数 | fit() 中被数据优化出来的是参数;训练前由人指定的是超参数 |
| 验证集 vs 测试集 | 验证集参与「选模型」的决策;测试集只做最终评估,绝不参与决策 |
| 特征 vs 标签 | 特征是输入(原因);标签是要预测的输出(结果) |
| 分类 vs 回归 | 看标签类型:离散类别 = 分类,连续数值 = 回归 |
| fit vs predict | fit 改变模型(学参数);predict 只读模型(参数不动) |