特征工程
1. 什么是特征工程
特征工程(Feature Engineering)是机器学习过程中非常重要的一步:通过对原始数据的处理、转换和构造,生成新的特征或选择有效的特征,从而提高模型的性能。
补充 业界流传很广的一句话:「数据和特征决定了机器学习的上限,而模型和算法只是在逼近这个上限。」同一个模型,喂进去的特征质量不同,效果可能天差地别。
两个关键认识:
- 特征工程是一个迭代过程。 不是「做完就结束」的一个步骤,而是「训练 → 看结果 → 回头改特征 → 再训练」的循环,需要大量数据分析和领域知识。
- 特征工程取决于具体情境。 特征如何编码,由所用模型类型、特征与输出之间的关系、要解决的问题共同决定;文本、图像、表格数据各有各的套路,没有万能配方。
2. 特征工程的四块内容
| 内容 | 一句话 | 例子 |
|---|---|---|
| 特征选择 | 从原有特征里挑出有用的 | 剔除与标签几乎无关的列 |
| 特征转换 | 把特征变成更适合模型输入的形式 | 标准化、One-Hot 编码、对数变换 |
| 特征构造 | 由已有特征创造新特征 | 年龄 × 收入、时间窗口均值 |
| 特征降维 | 压缩特征数量,尽量不丢信息 | PCA 把 100 维压到 10 维 |
易混 特征选择是「挑列」——不创建新特征、不改变数据结构;特征降维是「造新列」——新特征是原特征的(线性)组合,原来的列没了。
3. 特征选择
3.1 为什么要筛选特征
- 无关特征:某个特征取值变化很小、几乎所有样本都一样,它和预测结果基本无关。
- 冗余特征:几个特征相关性很高,包含重复信息。
- 维度灾难(Curse of Dimensionality):特征数量过多时,样本在高维空间里变得极度稀疏,基于距离的算法(KNN、K-means、SVM)会失效,模型的参数量上升,过拟合风险也随之增大。
筛选特征的好处:降低模型复杂度、加速训练、减少过拟合风险、增强可解释性。
3.2 三大方法
| 方法 | 思路 | 典型代表 | 速度 | 与模型的关系 |
|---|---|---|---|---|
| 过滤法(Filter) | 先用统计指标给特征打分,选分高的,与模型无关 | 低方差过滤、相关系数、卡方检验、互信息 | 快 | 无关,可独立先跑 |
| 包裹法(Wrapper) | 把不同的特征子集喂给模型试跑,按模型表现选 | 递归特征消除(RFE) | 慢 | 强依赖所选模型 |
| 嵌入法(Embedded) | 模型训练时「顺手」完成特征选择 | L1 正则化、决策树的特征重要性 | 中 | 选择机制内置在模型里 |
补充 实战中常见的组合拳:特征非常多时,先用过滤法(如相关系数)快速粗筛,再用嵌入法(如 L1 或树模型重要性)精选。包裹法一个代表是 RFE:反复训练模型、每次删掉最不重要的特征,直到剩下目标数量。
1 | from sklearn.feature_selection import RFE |
4. 特征转换
4.1 归一化(Normalization)
把特征按比例缩放到一个固定范围(默认 $[0, 1]$):
$$x’ = \frac{x - x_{min}}{x_{max} - x_{min}}$$
这个公式不用背,它只是在回答一个问题:这个数在本列的最小值和最大值之间排多靠上? 越接近最小值结果越接近 0,越接近最大值越接近 1。
手算一次:某列特征取值为 [1, 2, 4, 6],则 $x_{min}=1$、$x_{max}=6$(极差 = 5):
| 原值 | 计算 | 结果 |
|---|---|---|
| 1 | (1−1)/5 | 0 |
| 2 | (2−1)/5 | 0.2 |
| 6 | (6−1)/5 | 1 |
「6 被变成 1」没有任何魔法——它只是本列最大的数,被放到了区间的最右端。
目的:消除量纲差异(身高用米、体重用千克,尺度差几个数量级),让所有特征站在同一起跑线,也加速梯度下降类算法的收敛。
适用:数据分布有明显边界(如图像像素 0~255、词频)、模型对输入范围敏感(KNN、SVM、神经网络)。
缺点:对异常值敏感——一个极端值会把其他样本全部压扁到很窄的区间。
1 | from sklearn.preprocessing import MinMaxScaler |
4.2 标准化(Standardization)
把特征调整为均值为 0、标准差为 1 的分布(z-score):
$$x’ = \frac{x - \mu}{\sigma}$$
其中 $\mu$ 是均值,$\sigma$ 是标准差。
这个公式也先不要背。它其实在回答:
当前这个数,比平均值高(或低)几个标准差?
手算一次:某列特征为 [10, 20, 30]:
- 均值:$\mu = 20$
- 标准差:$\sigma \approx 8.16$(每个数与均值之差平方后取平均,再开根号)
- 对 30:$x’ = \dfrac{30 - 20}{8.16} \approx 1.225$
含义不是「30 神秘地变成了 1.225」,而是:30 比这列数据的平均水平高出约 1.225 个标准差。标准化不改变数据的相对位置,只是换了一把更统一的「尺子」。
目的:统一特征尺度、改善梯度优化的收敛条件、让正则化惩罚对各特征公平、让基于距离/内积的计算更合理。
澄清一个常见误解:标准化不会把数据变成正态分布——z-score 不改变分布形状,偏态的标准化后仍然偏态;线性回归、逻辑回归也并不要求特征服从正态分布(「误差近似正态」说的是误差项,不是特征)。另外,均值和标准差本身会被异常值拉偏,所以标准化并不真正鲁棒——异常值严重时请改用 RobustScaler。
适用:大多数场景下标准化是更通用的默认选择(分布未知、存在轻微异常值时尤其合适)。
1 | from sklearn.preprocessing import StandardScaler |
4.3 归一化 vs 标准化怎么选
| 归一化 | 标准化 | |
|---|---|---|
| 公式 | min-max 缩放 | z-score |
| 结果 | 固定在 $[0,1]$(或指定区间) | 无固定范围,均值 0、标准差 1 |
| 异常值 | 敏感 | 仍会拉偏均值/标准差(重异常值场景用 RobustScaler) |
| 适用 | 有明确边界的数据;需要固定输入范围 | 分布未知/近似正态;默认首选 |
补充 三条经验:
- 树模型(决策树、随机森林)不需要缩放——它们按特征值排序找分裂点,单调变换不改变排序结果。
- 需要缩放的是「看距离/看数值大小」的模型——KNN、K-means、SVM、神经网络、带梯度下降的线性模型。
- 异常值很多时可以用 RobustScaler(用中位数和四分位距缩放),抗异常值能力更强。
🔴 数据泄漏(面试高频) 缩放器的
fit只能在训练集上做,再用它去transform训练集和测试集。把测试集的信息掺进fit(比如用全局最小最大值缩放),测试集就不再「未见」,评估结果会虚高。
这三行代码最重要的不是背下来,而是弄清楚两个方法各自在做什么。
fit(X_train) 内部——只学习、不转换:
1 | 读取训练数据 |
transform(X) 内部——只转换、不学习:
1 | 取出保存的 μ、σ(固定不动) |
所以代码应该这样写:
1 | scaler = StandardScaler() |
fit_transform(X) 等价于先 fit(X) 再 transform(X),是训练集的便捷写法。如果对测试集写了 fit_transform(x_test),测试集自己的一套 μ、σ 就混进了训练流程——这就是数据泄漏(Data Leakage)。记住口诀:fit 只在训练集,transform 走遍天下。
4.4 对数变换
对右偏分布(少数极端大值把分布的右尾拉得很长,如收入、价格、销量)取对数,把右尾压缩,使分布更接近正态:
$$x’ = \log(x)$$
1 | import numpy as np |
补充 对数变换还会把乘法关系变成加法关系:$\log(ab) = \log a + \log b$,对线性模型更友好。
4.5 类别变量的编码
模型只能吃数字,类别变量(城市、颜色、学历)必须先编码。但直接用整数编号会出问题:「红色/绿色/蓝色」编码成 0/1/2 后,模型会误以为 2 比 1「大」、1 和 2 的距离比 1 和 0 近——而颜色之间并没有这种大小关系。
| 编码方法 | 做法 | 适用 | 风险 / 代价 |
|---|---|---|---|
| 独热编码(One-Hot) | 每个类别生成一列 0/1 | 无序类别(城市、颜色) | 类别很多时维度爆炸 |
| 标签编码(Label Encoding) | 类别 → 整数 | 有序类别(学历:小学 < 中学 < 大学) | 用在无序类别会引入虚假的大小关系 |
| 目标编码(Target Encoding) | 类别 → 该类别对应标签的均值 | 高基数(类别极多)+ 有监督任务 | 必须在交叉验证内部做,否则泄漏标签信息 |
| 频率编码(Frequency Encoding) | 类别 → 该类别出现频率 | 高基数 | 频率相同的不同类别无法区分 |
1 | import pandas as pd |
补充 几个细节:
- sklearn 里
LabelEncoder是给标签 y 用的;特征 X 的有序编码用OrdinalEncoder。- One-Hot 把 k 个类别编成 k 列后,这 k 列完全线性相关(和恒为 1),对线性模型会造成多重共线性——设
drop="first"删掉第一列即可打破。- 编码器的 fit 在做什么:扫描训练集该列,把出现过的类别记成一份名单(存在
categories_属性里);transform只按这份名单生成 0/1 列。这同样是「fit 只在训练集」——测试集若出现名单之外的新类别,默认直接报错,设handle_unknown="ignore"可以把未知类别整行编为全 0。
4.6 把纪律落成工程:Pipeline
「fit 只在训练集、transform 走遍天下」这条纪律,靠人肉执行迟早会漏。sklearn 的 Pipeline(管道)把所有预处理步骤和模型串成一条流水线,从结构上杜绝遗忘:
1 | from sklearn.pipeline import Pipeline |
它一次解决四件事:① 接入交叉验证/网格搜索时,每一折内部自动重新 fit 预处理(防泄漏);② 新样本预测不会忘记 transform;③ 保存模型时预处理器和模型一起走;④ 网格搜索可用 "model__C" 这种「步骤名__参数名」统一调参。
5. 特征构造
特征构造是基于现有特征创造新的、更有代表性的特征,最能体现领域知识的一步。
| 类型 | 做法 | 例子 |
|---|---|---|
| 交互特征 | 两个特征组合(乘积、和、差、比率) | 年龄 × 收入,可能比单独两项更能反映消费能力 |
| 统计特征 | 从时间窗口中提取统计量 | 最近 7 天消费的均值 / 最大值 / 标准差 |
| 日期时间特征 | 从日期中拆出信息 | 星期几、月份、季度、是否节假日、月初/月末 |
1 | import pandas as pd |
警告 构造统计特征有一个隐藏大坑——未来泄漏:上面
transform("mean")用的是用户全时段的消费均值;如果任务是预测某个月之后的行为,这个均值里就混进了「未来」。时间/行为数据的窗口统计,必须保证每个样本只能使用预测时点之前的信息。
补充 在 Kaggle 等数据竞赛中,特征构造往往是拉开差距的关键;而「星期几」这类周期特征,进阶做法是用 sin/cos 编码成两个特征,让模型理解「周日和周一其实相邻」。
6. 特征降维总览
特征太多会带来计算复杂和过拟合风险。降维的目标:在尽量保留信息的前提下减少特征数量。
| 方法 | 监督? | 线性/非线性 | 典型用途 |
|---|---|---|---|
| PCA 主成分分析 | 无监督 | 线性 | 通用降维、去相关、压缩、可视化 |
| LDA 线性判别分析 | 有监督 | 线性 | 降维同时有利于分类(最大化类间距离/类内距离) |
| t-SNE | 无监督 | 非线性 | 高维数据可视化(压到 2/3 维看分布) |
| AutoEncoder 自编码器 | 无监督 | 非线性 | 复杂结构数据(图像)的特征学习 |
补充 t-SNE 基本只用于可视化:它对新高维样本没有通用的投影方式(transform 能力弱),且不保持全局距离,不要拿它的输出当特征训练模型。
7. 常用方法实操
7.1 低方差过滤法(过滤法)
原理:方差衡量一组数值的离散程度。某特征方差接近 0,说明所有样本取值几乎一样——它不携带区分样本的信息,可以直接删掉。
1 | from sklearn.feature_selection import VarianceThreshold |
补充 注意量纲问题:方差的大小和量纲直接相关(「年收入」的方差天然比「性别」大几个数量级),拿统一阈值去卡不同量纲的特征并不公平。更严谨的做法是先标准化、再做低方差过滤。另外,低方差 ≠ 一定没价值:一个几乎全为 0、只在罕见关键事件(如「发生过事故」)时取 1 的特征方差很低,却可能极有预测力——低方差过滤只是无监督的粗筛启发式,动手删除前最好过一遍业务判断。
7.2 相关系数法(过滤法)
原理:用相关系数衡量特征与标签的关联程度——
- 特征与标签相关性高 → 该特征有信息量,保留;
- 特征与标签几乎不相关 → 候选剔除;
- 特征之间相关性极高 → 冗余,二选一。
皮尔逊相关系数(Pearson)
衡量两个变量的线性相关性,取值 $[-1, 1]$:
$$r = \frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}{\sqrt{\sum_{i=1}^{n}(x_i-\bar{x})^2}\sqrt{\sum_{i=1}^{n}(y_i-\bar{y})^2}}$$
- $r \to 1$:正相关(x 增大 y 随之增大);
- $r \to -1$:负相关;
- $r \to 0$:无线性关系(不代表没有关系——可能存在非线性关系)。
以广告投放数据集(TV/Radio/Newspaper 投入与 Sales 销售额)为例,计算各特征与标签的皮尔逊相关系数:
1 | import pandas as pd |
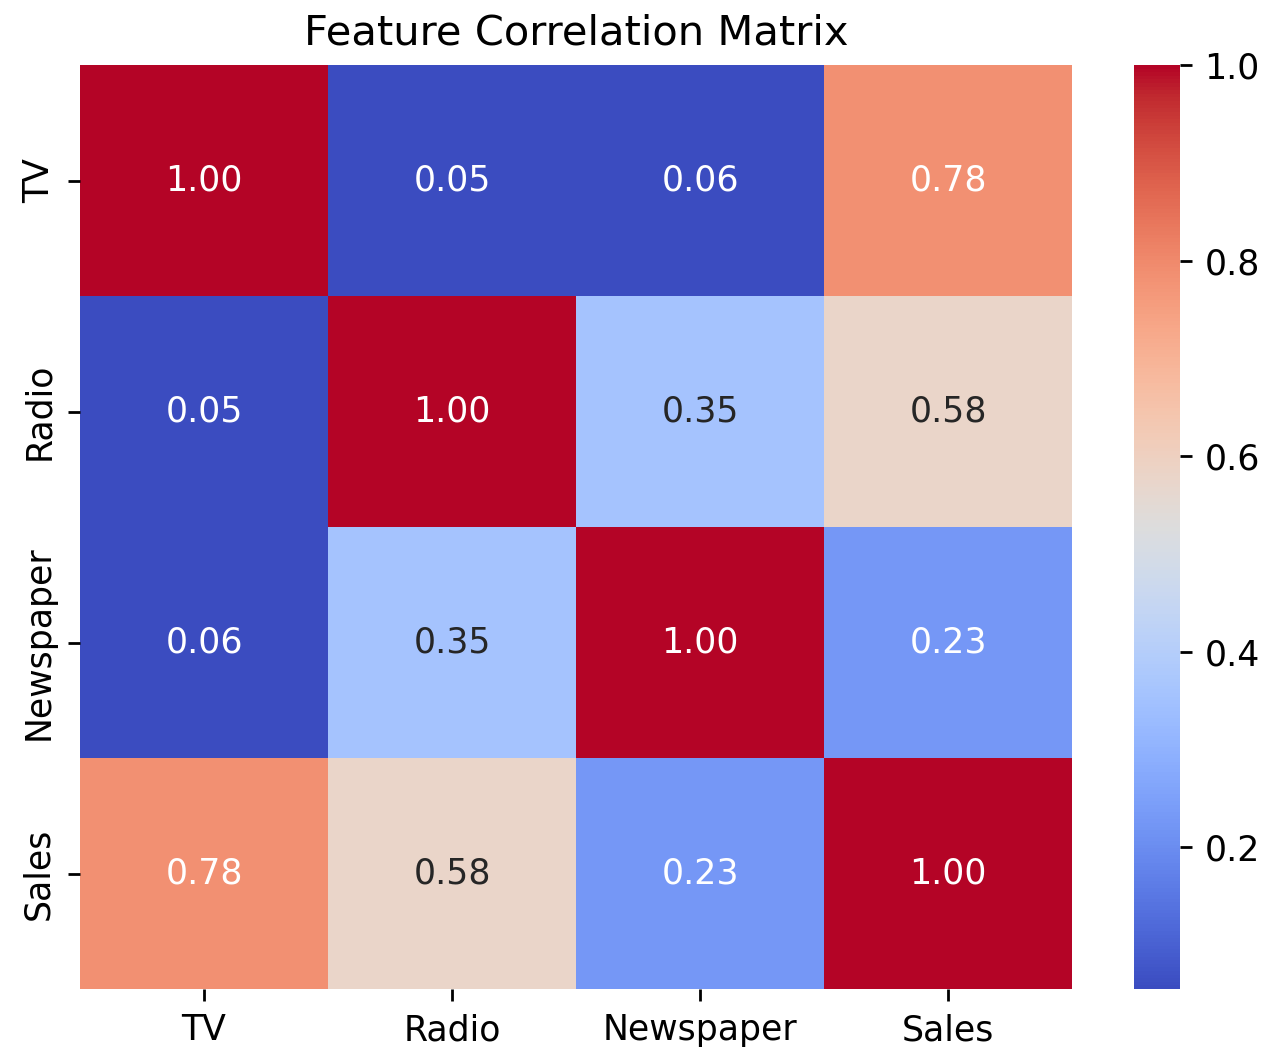
从热力图读出两个结论:TV(0.78)、Radio(0.58)与 Sales 相关性高,是重要特征;Newspaper(0.23)相关性低,是剔除候选。特征之间(如 Radio 与 Newspaper 的 0.35)相关性都不算高,没有明显冗余。
斯皮尔曼相关系数(Spearman)
定义是「等级变量之间的皮尔逊相关系数」:先把数值换成排名,再算相关性。衡量的是单调关系(一个变量增大,另一个是否总是增大/减小),不要求线性。
$$r_s = 1 - \frac{6\sum_{i=1}^{n}d_i^2}{n(n^2-1)}$$
其中 $d_i$ 是两个变量的排名之差,$n$ 是样本数。(这个简化公式在没有并列排名时最直接成立;有并列时,更一般的定义是「对两个排名序列计算皮尔逊相关」——pandas 的 method="spearman" 正是这么实现的。)
适用:非线性但单调的关系、数据不满足正态分布、有序数据(等级评分)。
1 | import pandas as pd |
两者对比
| 皮尔逊 | 斯皮尔曼 | |
|---|---|---|
| 衡量什么 | 线性相关 | 单调相关 |
| 对数据的要求 | 连续、近似正态 | 无要求(用排名) |
| 异常值 | 敏感(用原始值计算) | 更鲁棒(排名抹平极端值) |
| 单调但非线性的关系(如 $y=x^2$,x>0) | 低估甚至看不见 | 能捕捉 |
提醒 相关系数只适合做初步筛查:单变量相关低不代表特征没用——它可能与其他特征交互后才发挥作用,可能是非线性关系(斯皮尔曼能抓单调、也抓不住 U 形),也可能是「与标签相关、但被其他特征稀释」。不要仅凭相关系数给特征判死刑。
8. 主成分分析(PCA)
1. 它解决什么问题?
特征维度太高时:训练慢、维度灾难、无法画图观察。特征选择的办法是「挑列」,会直接丢掉整列原始信息;PCA 给出另一种思路——把 n 个相关的原始特征压缩成 k 个互不相关的新特征($k < n$),每个新特征都是原特征的线性组合,并尽可能保留原数据的信息。
典型用途:降维加速训练、高维数据可视化(压到 2/3 维)、去除特征间的多重共线性、压缩去噪。PCA 是无监督方法,全程不需要标签。
2. 核心直觉
把二维数据点云想象成一个斜着的椭圆:
- 沿椭圆长轴方向,数据散得很开(方差大)——这个方向上样本差异明显,携带的信息多;
- 沿短轴方向,数据挤成一团(方差小)——这个方向上样本差不多,信息少。
PCA 做的事就是旋转坐标系:让第一根新坐标轴(第一主成分)对准长轴方向,第二根对准次长轴……然后只保留前 k 根轴。丢掉的都是「数据挤成一团」的方向,因此信息损失最小。
核心假设一句话:方差 = 信息。
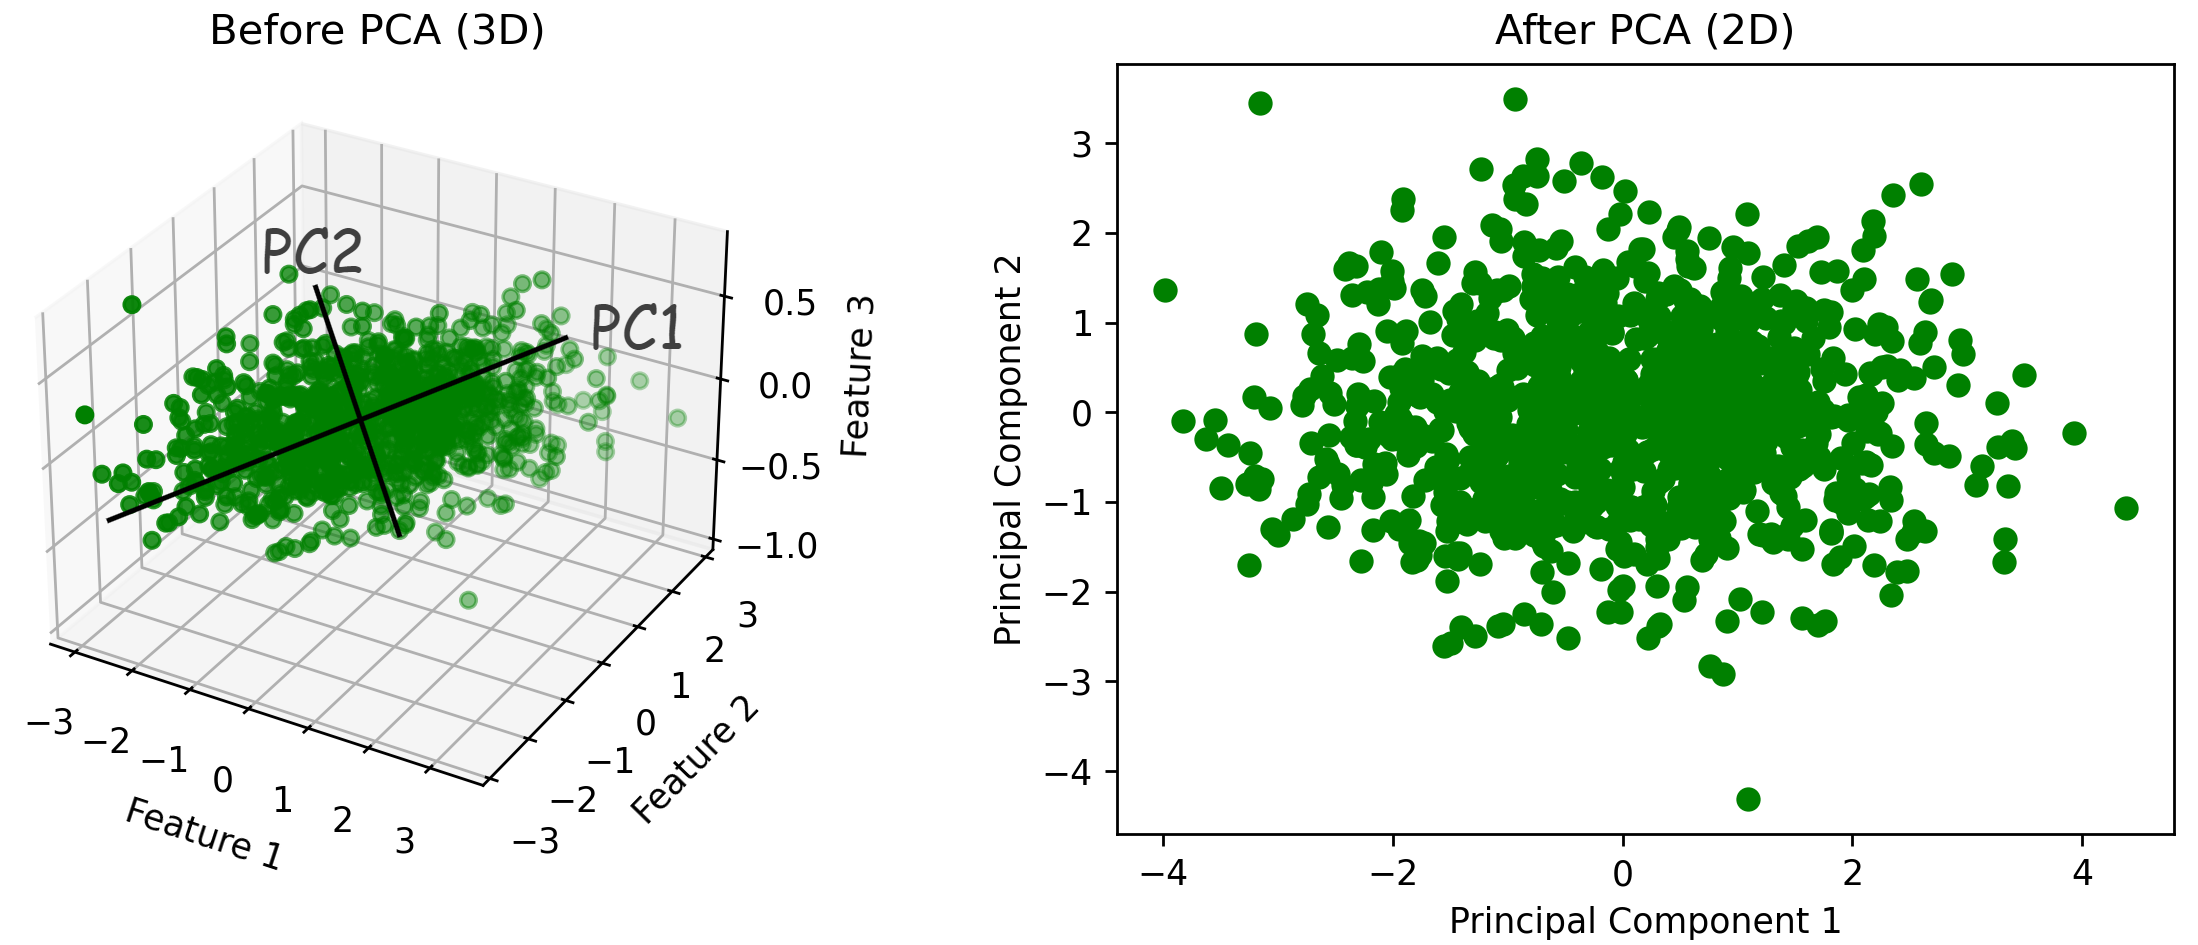
上图中,三维数据点云其实躺在一个斜平面附近——用 PC1、PC2 两根新轴(左图)重新表达后,三维问题变成了二维问题(右图),几乎不丢信息。
保留多少个主成分?看方差贡献率:常用经验是让前 k 个主成分的累计贡献率达到 85%~95%。
3. 数学表达 / 公式
设样本矩阵 $X \in \mathbb{R}^{n \times d}$(n 个样本、d 个特征),PCA 的求解流程:
第 0 步:中心化。 每个特征减去自己的均值,使每列均值为 0:
$$x_j \leftarrow x_j - \mu_j$$
第 1 步:求协方差矩阵。 描述特征两两之间的线性关系:
$$C = \frac{1}{n-1} X^\top X \in \mathbb{R}^{d \times d}$$
第 2 步:找方差最大的投影方向。 把数据投影到单位向量 $w$ 上(新特征 $y = Xw$),投影后的方差为 $w^\top C w$。第一主成分就是求解:
$$\max_{w} ; w^\top C w \quad \text{s.t.} \quad w^\top w = 1$$
第 3 步:拉格朗日乘子法。 构造 $L(w) = w^\top C w - \lambda(w^\top w - 1)$,对 $w$ 求导令其为零,得到:
$$Cw = \lambda w$$
这正是特征方程:最优投影方向 $w$ 是协方差矩阵 $C$ 的特征向量,对应的方差就是特征值 $\lambda$。
第 4 步:排序与投影。 把特征值从大到小排序,取前 k 个特征向量拼成投影矩阵 $W \in \mathbb{R}^{d \times k}$,降维结果为:
$$X’ = XW \in \mathbb{R}^{n \times k}$$
第 i 个主成分的方差贡献率:
$$\eta_i = \frac{\lambda_i}{\sum_{j=1}^{d}\lambda_j}$$
一句话结论:PCA 的解 = 协方差矩阵的特征分解;特征值 = 各主成分的方差,特征向量 = 各主成分的方向。
补充 sklearn 底层实际用奇异值分解(SVD)实现 PCA,不显式构造协方差矩阵,数值计算更稳定,数学结果与特征分解等价。
4. 模型是怎么训练出来的?
PCA 严格意义上没有「训练」,只有 fit——从数据中估计出降维所需的一切:
- 计算每个特征的均值(用于中心化);
- 中心化后求协方差矩阵;
- 特征分解(或 SVD),得到全部特征向量与特征值;
- 按特征值从大到小排序,保留前 k 个特征向量;
- 把均值和投影方向存下来。
fit 之后模型里保存的关键属性:
| 属性 | 含义 |
|---|---|
mean_ |
每个特征的均值(transform 时要先减掉) |
components_ |
k 个主成分的方向(每行一个) |
explained_variance_ratio_ |
每个主成分的方差贡献率 |
transform 则是纯计算:减均值、乘投影矩阵,把样本从 d 维坐标系搬到 k 维新坐标系。
🔴 和缩放器同样的纪律:
fit只能在训练集上做,测试集用transform。主成分方向必须只反映训练数据的结构。
主成分个数 k 是超参数,无法通过训练学出来,常用确定方法:累计贡献率达到阈值(如 0.95)、配合交叉验证看下游模型表现。
5. Python / sklearn 怎么实现?
n_components 参数的两种用法:整数 = 保留的维度个数;小数(0~1) = 希望保留的信息比例,sklearn 自动选最少的维度数。
下面构造一组带噪声的三维相关数据,用 PCA 压到二维(上面那张前后对比图就是这段代码的输出):
1 | import numpy as np |
按信息比例保留的写法(更常用):
1 | # 自动选择「保留 95% 信息」所需的最少维度 |
补充
pca.inverse_transform(X_pca)可以把数据投影回原空间做「近似还原」——被丢掉维度的信息找不回来了,只能得到近似值,这正好可以用来做数据压缩与去噪。
6. 优缺点与注意事项
优点:消除特征间相关性、降低计算量、缓解过拟合、便于可视化。
缺点与注意:
- 可解释性变差:主成分是所有原始特征的抽象组合,「第一主成分」没有业务含义。
- 只捕捉线性结构:数据在弯曲的流形上时效果差,需换 t-SNE、自编码器等非线性方法。
- 方差大 ≠ 对预测有用:PCA 是无监督的,它保证「保留方差」,不保证「保留判别力」——与标签相关但方差小的方向可能被丢掉。有监督场景下可以对比「PCA + 模型」与「原始特征 + 模型」的表现再决定用不用。
- 量纲差异大时通常先标准化:不缩放的话,量纲大的特征会独占几乎所有方差;但 PCA 在数学上强制要求的只是中心化(sklearn 默认已做)——若各特征同单位、且原始方差本身携带业务信息,也可以不缩放。
9. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 特征选择 vs 特征降维 | 选择 = 挑列,不产生新特征;降维 = 造新列(原特征的组合) |
| 归一化 vs 标准化 | 归一化压到固定区间、怕异常值;标准化变均值 0 方差 1、更通用 |
| 皮尔逊 vs 斯皮尔曼 | 皮尔逊看线性;斯皮尔曼看单调(先转排名),更抗异常值 |
| One-Hot vs 标签编码 | 无序类别用 One-Hot;有序类别才能用整数编码 |
| LabelEncoder vs OrdinalEncoder | 前者编码标签 y,后者编码特征 X |
| fit / transform 用法 | 所有「学统计量」的转换器(Scaler、PCA、编码器)都只在训练集 fit,防数据泄漏 |