无监督学习:聚类与降维
30 秒先懂
没有标签怎么办?聚类:按「物以类聚」自动把相似样本分成几簇;降维:在尽量少丢信息的前提下压缩特征数量。
这是最后一篇(原文档部分标注【了解】):聚类介绍三种代表算法与评估指标,降维讲 SVD 与 PCA 的原理及联系。
1. 聚类解决什么问题?
聚类(Clustering)把数据集分成若干个簇:同簇样本彼此相似,异簇差异大。没有标签、没有标准答案,完全依赖数据自身的结构——最终每个簇代表什么概念,要由人来命名和解释。
流程三步:① 定义相似性(欧氏距离、余弦相似度等)→ ② 按相似性分组 → ③ 迭代优化,让簇内相似度最大、簇间差异最大。
典型应用:市场细分(按消费习惯给客户分组)、图像分割(按颜色/纹理给像素分组)、异常检测(不属于任何簇的点很可疑)、生物信息(基因表达分组)。
2. K-means:最常用的聚类算法
1)它解决什么问题?
把样本分成 K 个簇,使每个样本到其所属簇中心的距离之和最小。K-means 是硬聚类:每个样本只属于一个簇。
2)核心直觉
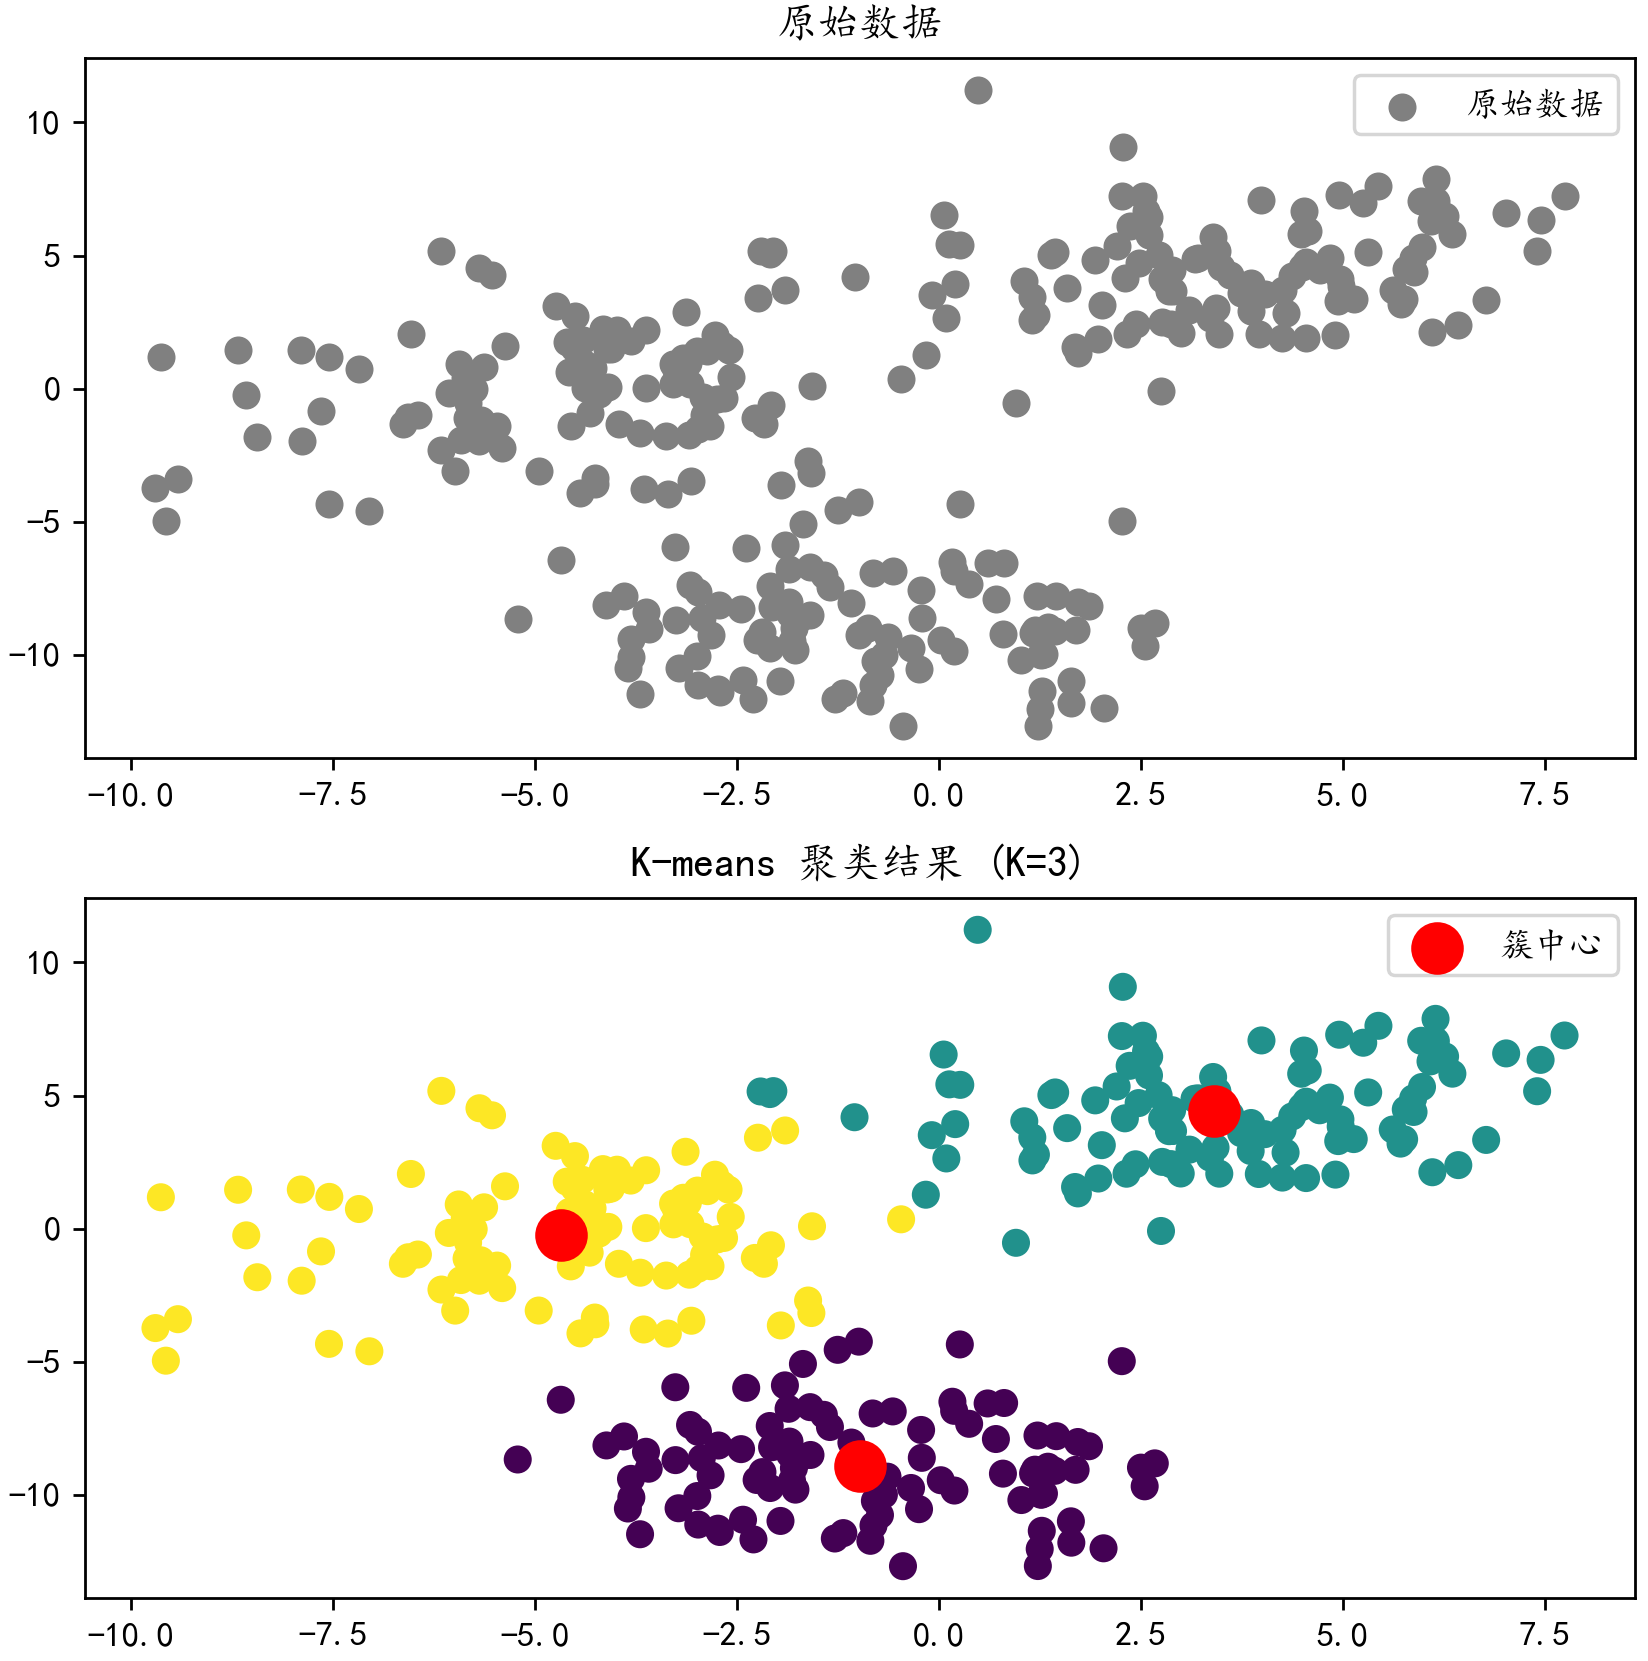
在散点图上撒 K 个「吸铁石」(簇中心),每个点被吸向最近的磁石;吸完后磁石挪到自己所吸点的正中央,再吸一轮……直到磁石不再移动:
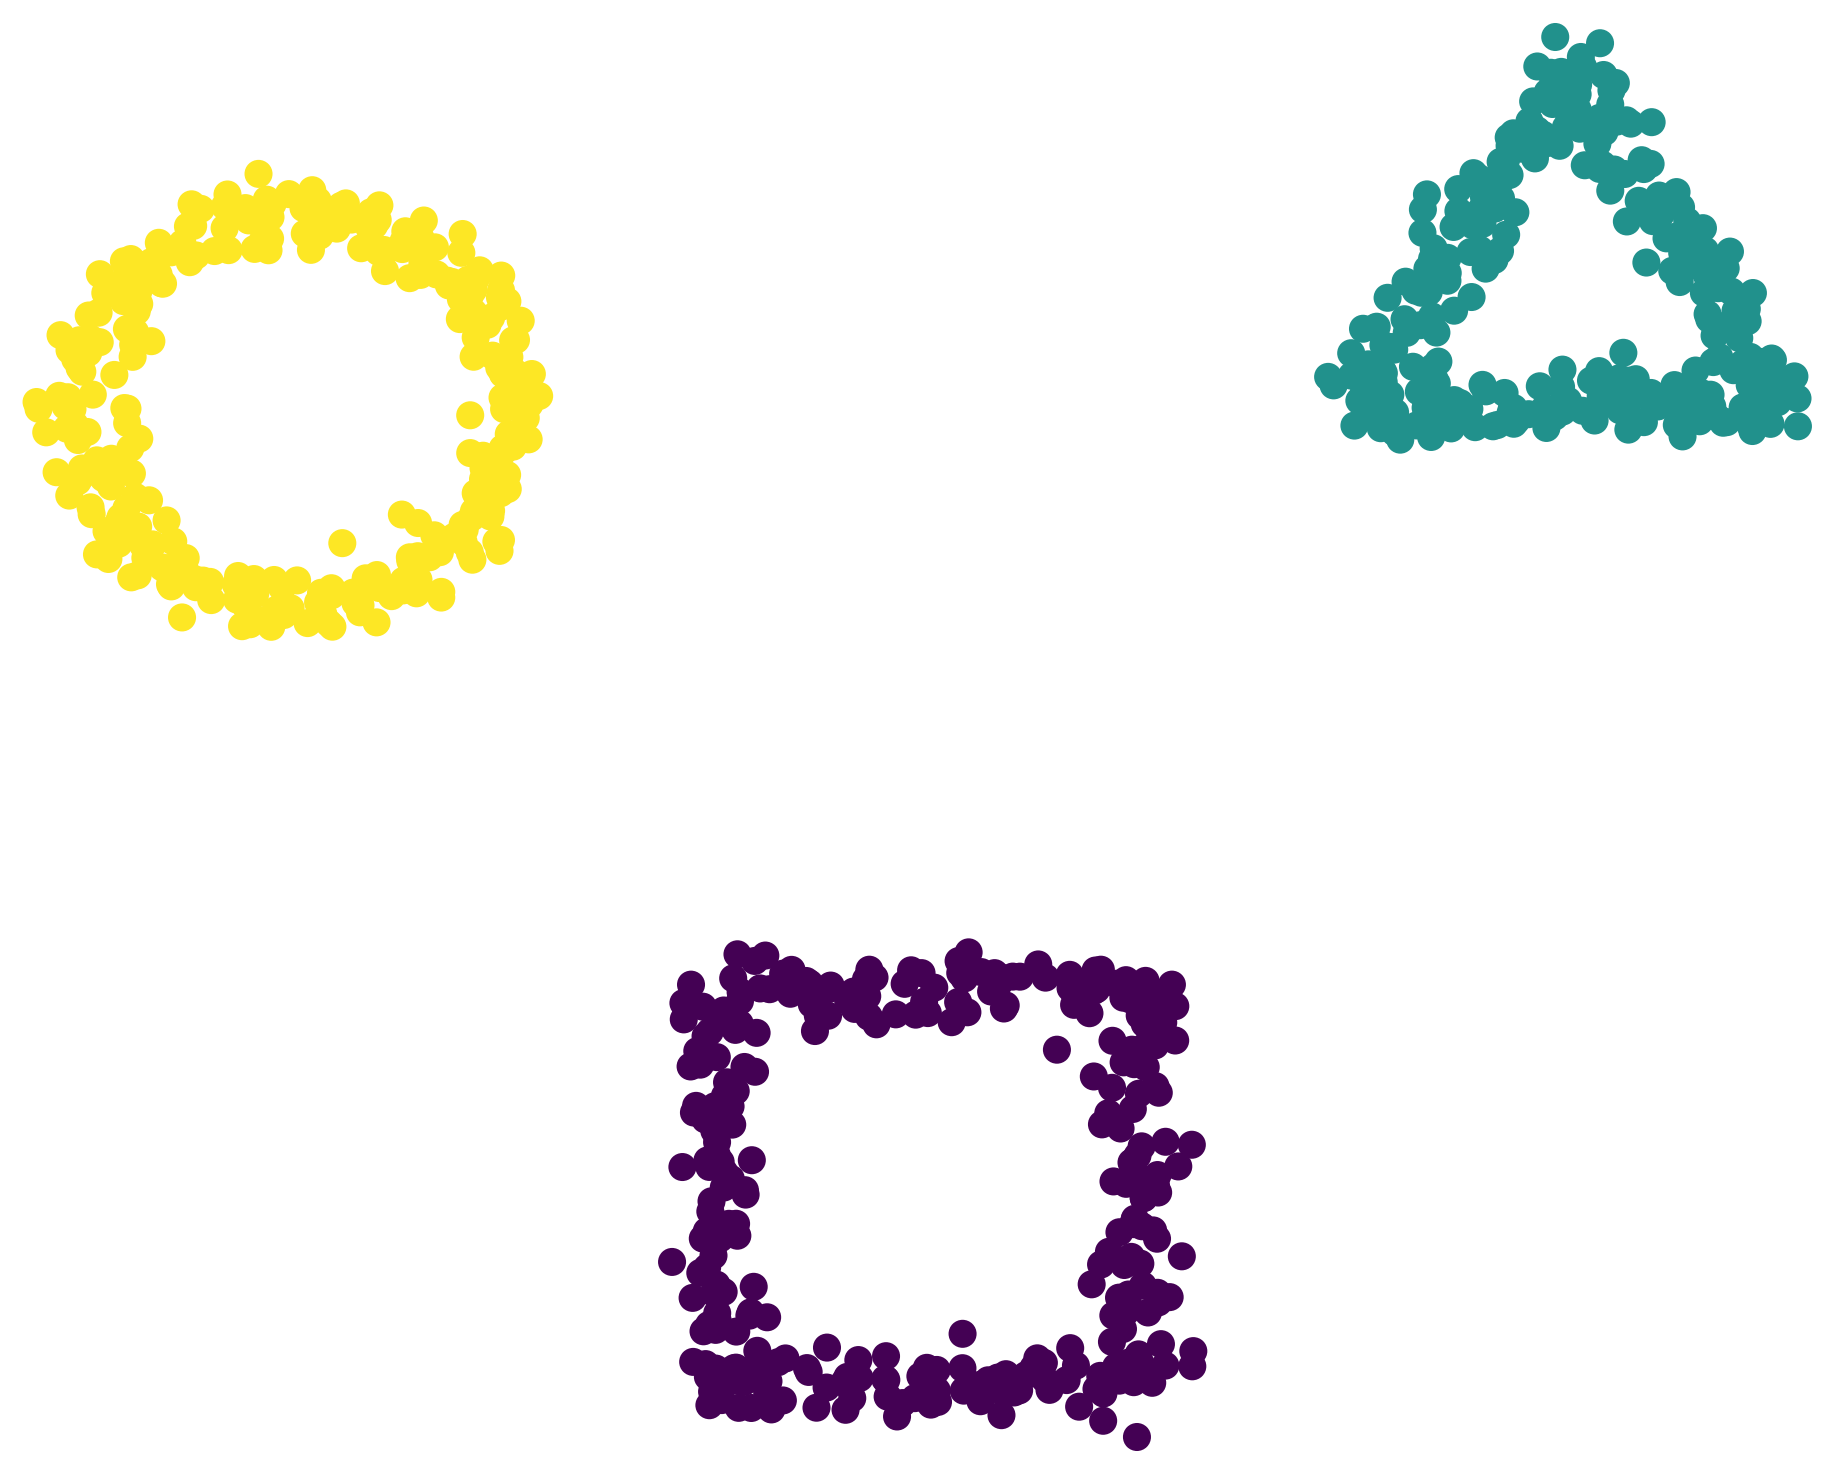
手算一次(一维数据秒懂全流程)。6 个点 $[1, 2, 3, 10, 11, 12]$,取 K=2,初始中心随机定为 $c_1 = 1$、$c_2 = 10$:
- 分配:每个点归最近的中心 → ${1,2,3}$ 归 $c_1$,${10,11,12}$ 归 $c_2$;
- 更新:新中心 = 各组均值 → $c_1 = 2$,$c_2 = 11$;
- 再分配:所有点离新中心的远近关系没变,分组不变 → 收敛,结束。
3)数学表达 / 公式
以欧氏距离平方为距离,损失函数是「每个样本到所属簇中心的距离平方之和」:
$$J = \sum_{i=1}^{n} \sum_{k=1}^{K} r_{ik} \lVert x_i - \mu_k \rVert^2$$
其中 $r_{ik} \in {0, 1}$ 表示样本 $i$ 是否属于簇 $k$(指示变量),$\mu_k$ 是第 $k$ 个簇的中心。最小化 J 本质是一个组合优化问题(n 个样本分 K 群的分法是指数级的),现实做法就是上面的迭代:分配(固定中心,最优分组)→ 更新(固定分组,最优中心)交替进行,J 单调下降直至收敛。
4)K-means 的使用要点
- 初始中心敏感:不同的随机起点可能收敛到不同的局部最优(sklearn 的
n_init会多跑几次取最优); - K 要事先指定,但实际最合理的 K 未知——用肘部法等指标试出来(见第 3 节);
- 自带假设:适合「近似球状、尺度相近、密度相近」的簇,且对离群点敏感(均值会被拉偏);长条、环形、螺旋形是它的软肋——那是 DBSCAN 的主场;
- 簇编号没有语义:
cluster 0/1/2只是算法给的编号——0 不代表「第一类」,换个随机种子编号甚至可能互换;每个簇代表什么,要人来命名; - 数据要先标准化(又是距离的锅,和 KNN 同理)。
5)Python / sklearn 怎么实现?
1 | import matplotlib.pyplot as plt |
3. 层次聚类与 DBSCAN
3.1 层次聚类(了解)
假设簇之间存在层次结构,分两个方向:
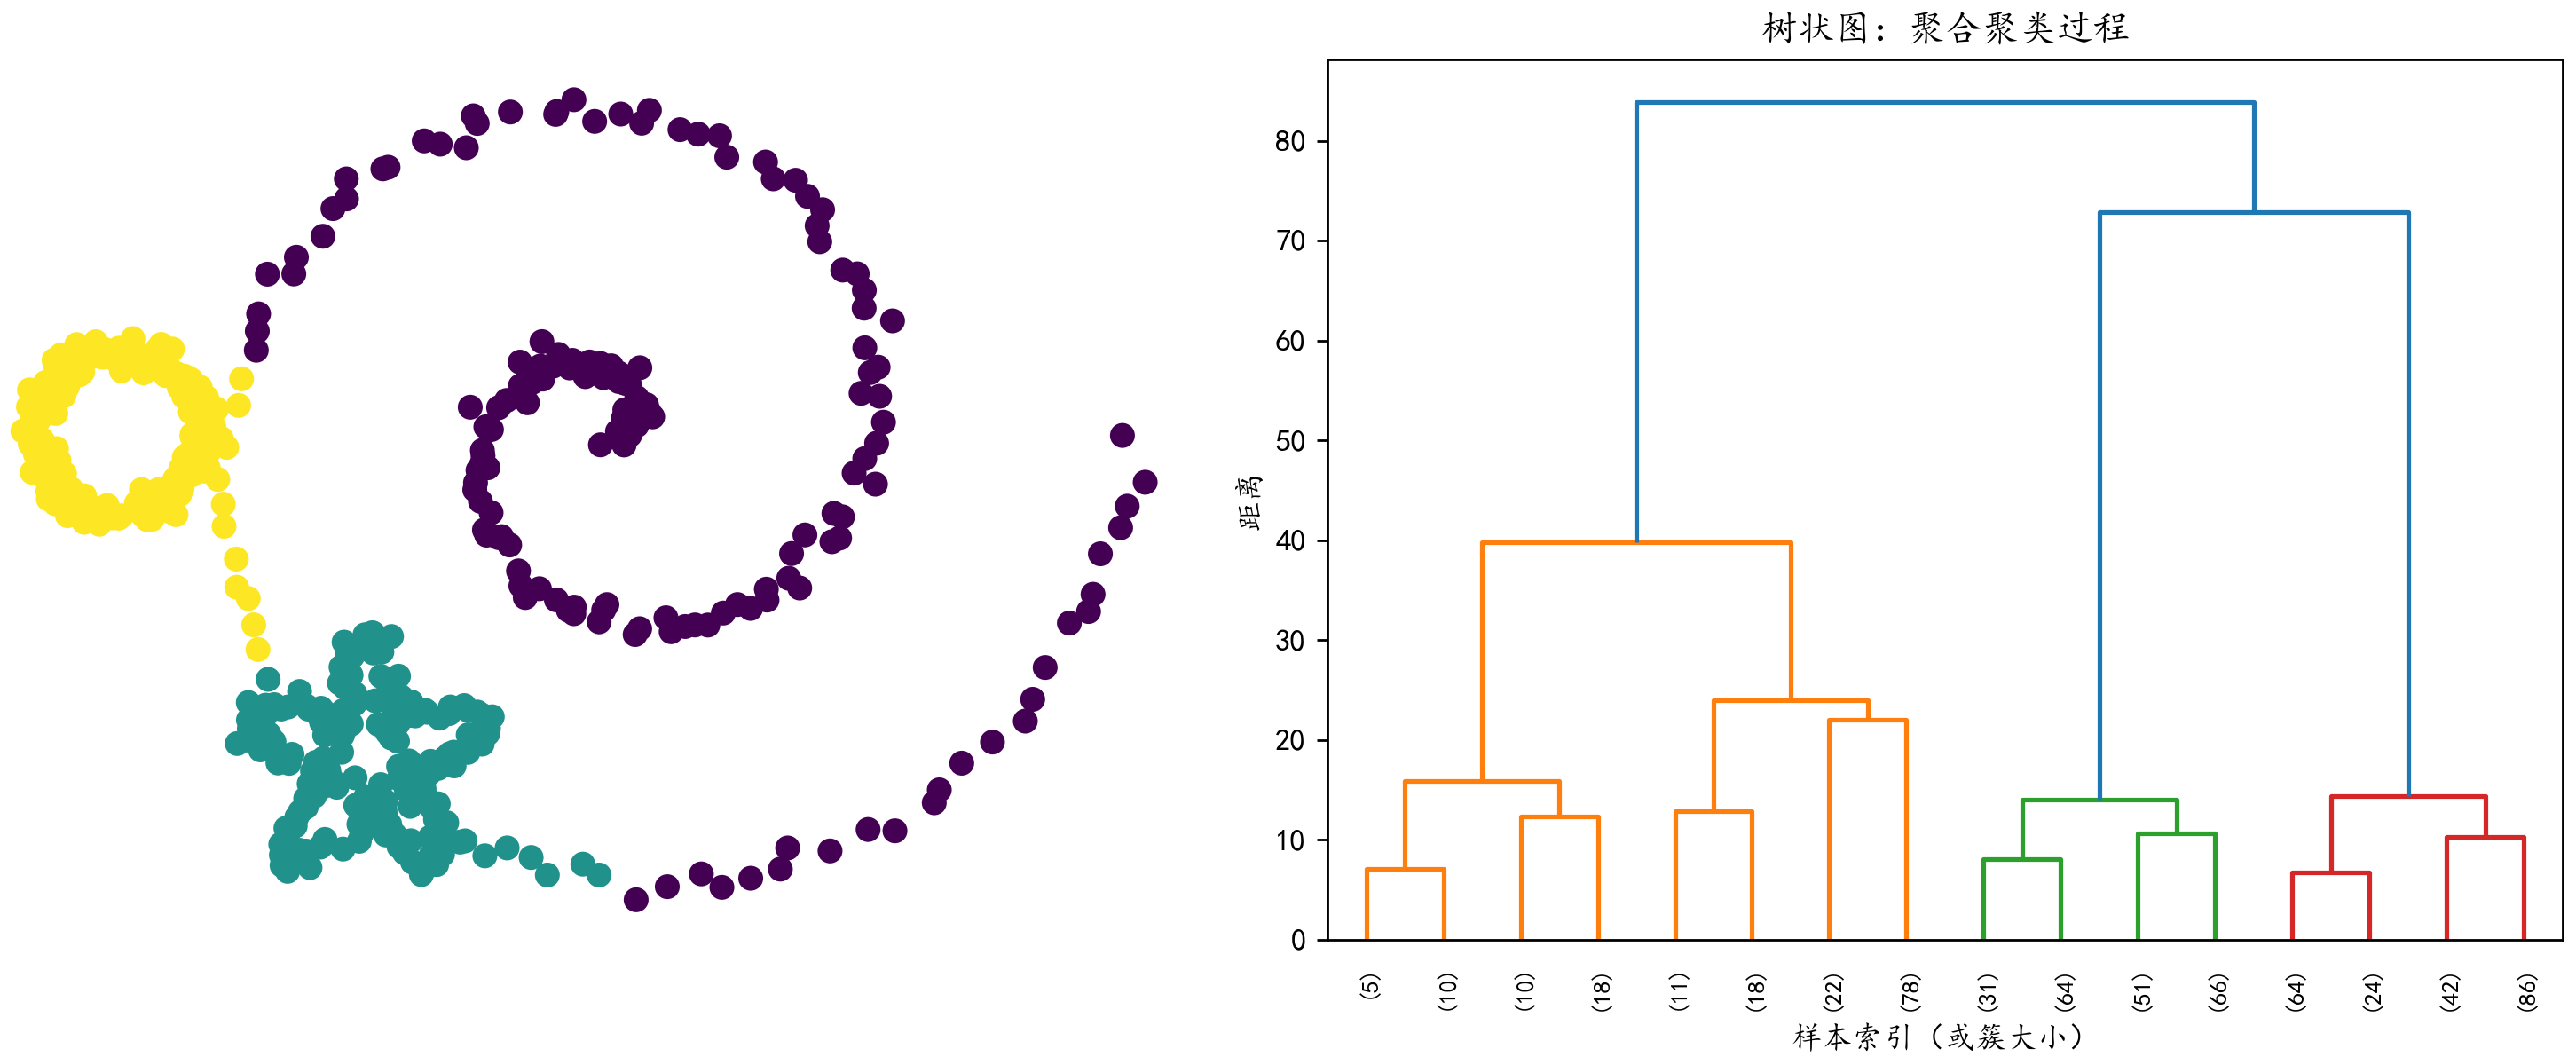
- 聚合(自下而上):开始每个样本各成一簇,每轮把相距最近的两个簇合并,直到满足停止条件(达到簇数阈值等)。「簇与簇的距离」需要先定义——常用 linkage 有 single(最近点对)、complete(最远点对)、average(平均距离)、Ward(合并后方差增量最小),选择不同结果会不同;
- 分裂(自上而下):开始全体一簇,每轮挑一个簇劈成两个,让子簇内更紧、子簇间更远,如此往复。
聚合过程的完整合并史可以画成一棵树(树状图):在任意高度「横切一刀」,就得到该粒度下的聚类结果——一次计算,所有粒度的分组方案随便挑,这是它相对 K-means 的独特优势。
3.2 密度聚类 DBSCAN(了解)
K-means 按到中心的距离划界,DBSCAN 按密度连通划界——从样本分布的紧密程度定义簇。先认识五个概念(设邻域参数 $\varepsilon$ 和最小点数 MinPts):
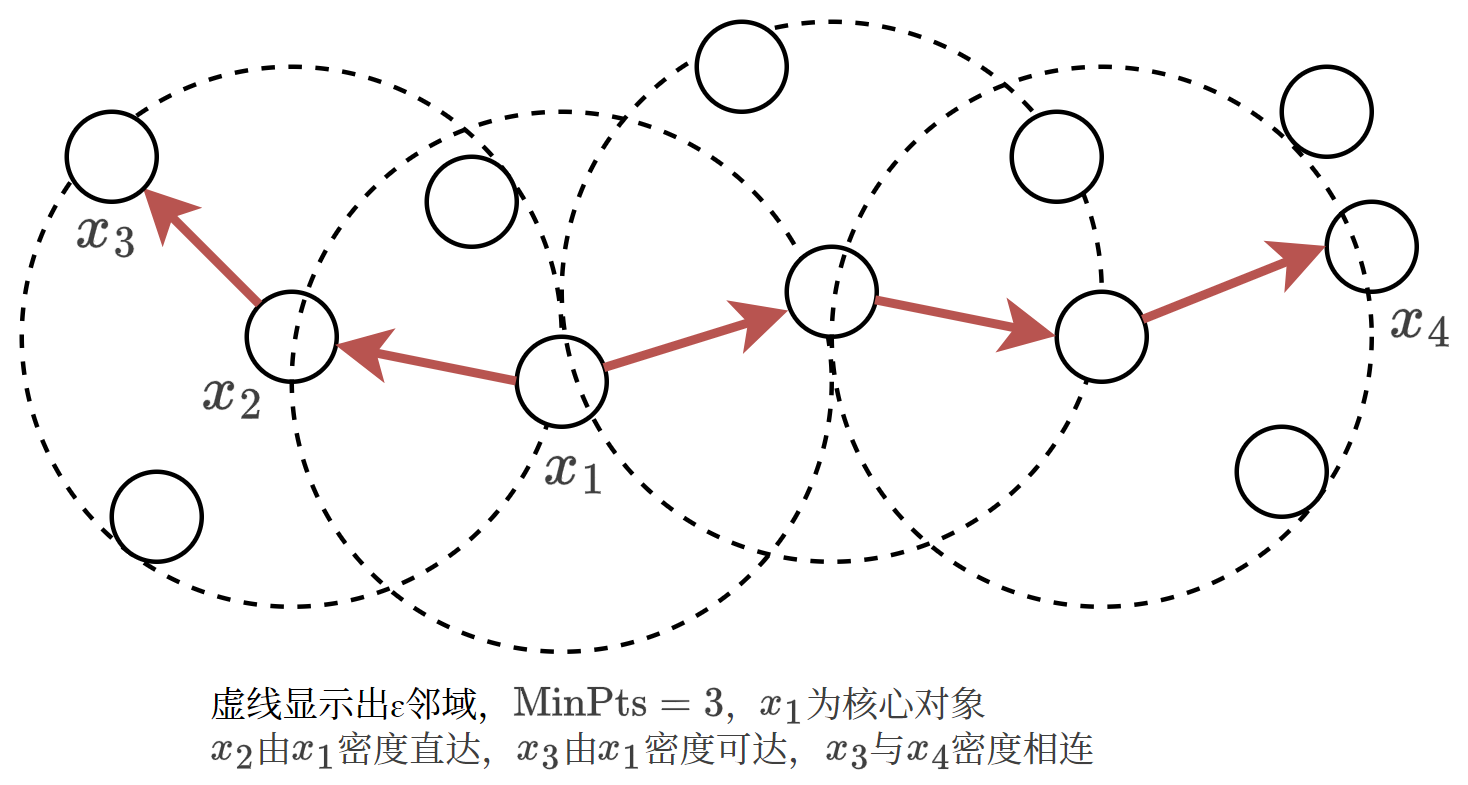
- ε-邻域:以样本为中心、半径 $\varepsilon$ 的圆内的样本集合;
- 核心对象:ε-邻域内至少含 MinPts 个样本的「人口密集区」;
- 密度直达:样本在核心对象的邻域内(被它直接辐射到);
- 密度可达:沿着一串核心对象「接力直达」能到(间接辐射);
- 密度相连:能从同一个核心对象密度可达的两点。
簇 = 由密度可达关系导出的最大密度相连样本集合;不属于任何簇的点是噪声点(自动识别离群点,聚类副产品)。算法:找出所有核心对象 → 从任一核心对象出发,把所有密度可达的样本收进一个簇 → 直到所有核心对象都被访问过。
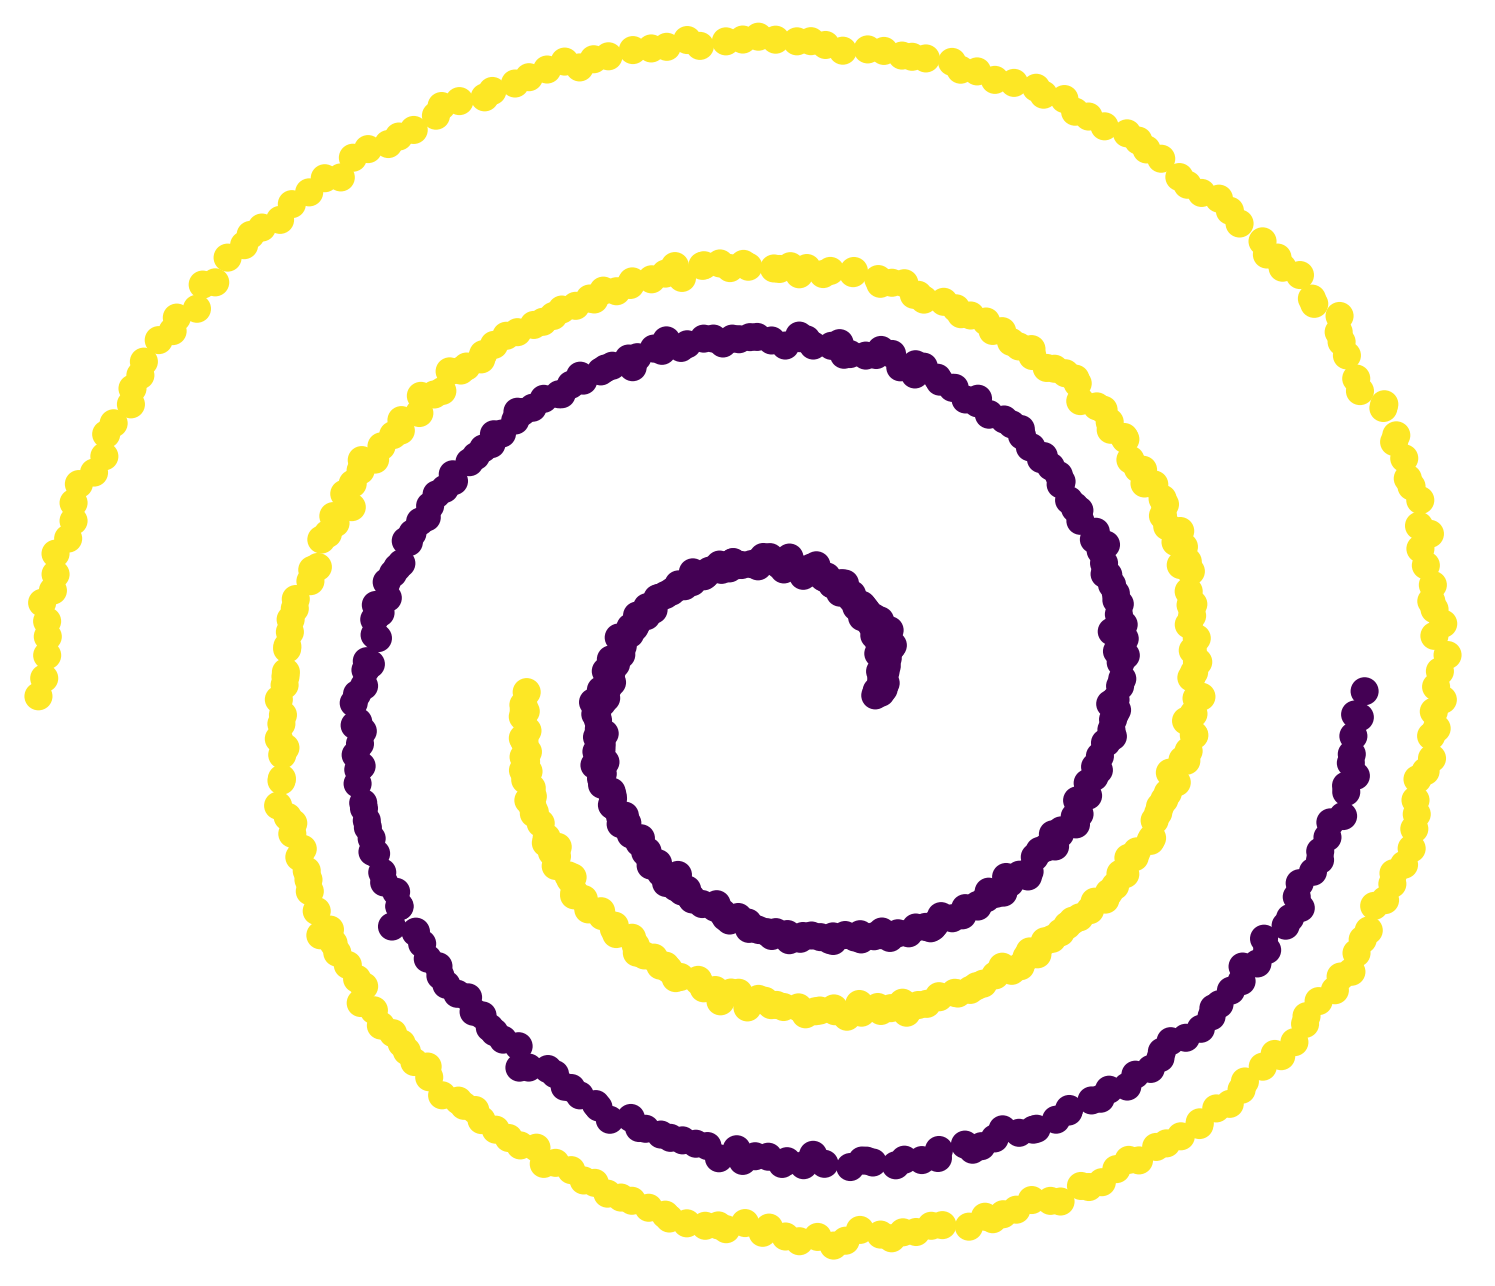
它的杀手锏是任意形状的簇——比如下面两组互相缠绕的螺旋线,K-means 这类基于「到簇中心距离」的算法难以处理;DBSCAN 在 $\varepsilon$、MinPts 设置得当时,能够识别这类非凸簇:
代价:$\varepsilon$ 和 MinPts 的选择对结果影响大,且密度差异悬殊的数据集不好处理。
4. 聚类效果好不好怎么评估?(了解)
聚类没有标签,没有「标准答案」可比,只能从簇内紧凑、簇间分离两个角度评价。
轮廓系数(Silhouette Coefficient):对每个样本,
$$s = \frac{b - a}{\max(a, b)}$$
- $a$:到同簇其他样本的平均距离(内聚度,越小越好);
- $b$:到最近其他簇样本的平均距离(分离度,越大越好)。
手算:某样本 $a = 2$、$b = 5$,则 $s = (5-2)/5 = 0.6$。$s$ 越接近 1 聚类越好,接近 0 表示骑在边界上,负数表示大概率分错簇。整体轮廓系数取所有样本的平均。
簇内平方和(Inertia / WCSS):所有样本到其簇中心距离平方之和,即 K-means 的损失函数 $J$——越小越紧凑,但 K 越大它必然越小,不能单独拿来选 K。
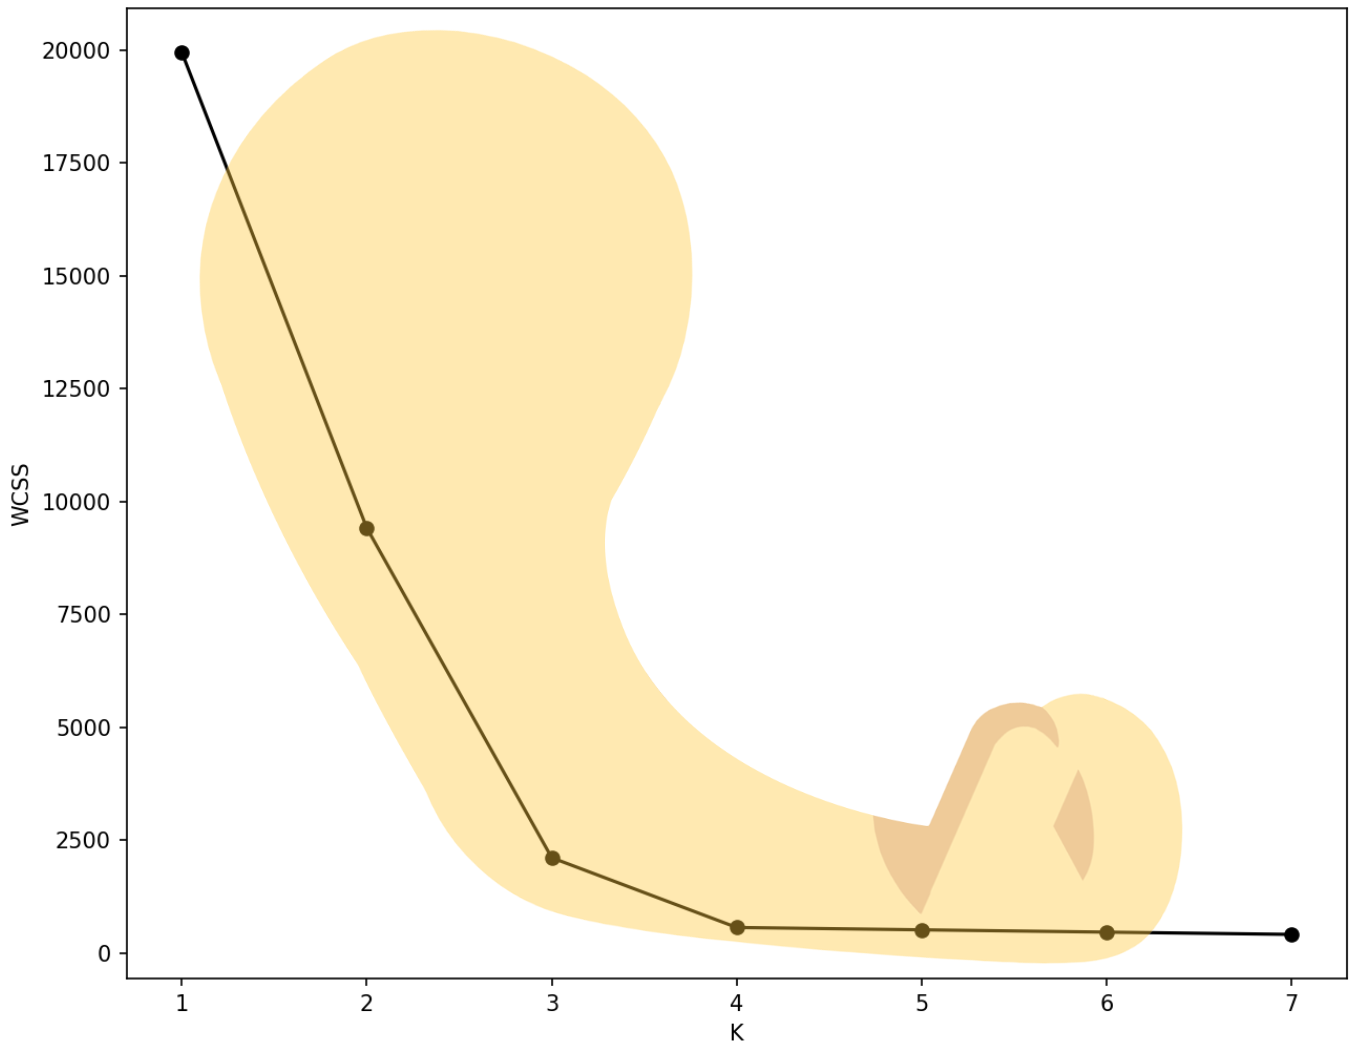
肘部法(Elbow Method):画出 K 从小到大变化时 WCSS 的曲线——K 超过真实簇数后,收益骤减,曲线出现「手肘」;肘部对应的 K 就是好选择。
CH 指数(Calinski-Harabasz):簇间离散度与簇内离散度之比(方差比准则),越大越好,且计算快。另外,如果手里恰好有少量外部真值标签,还可以用 ARI、NMI 这类「外部指标」对照评分——注意标签只在评估时使用,聚类训练本身仍然不用标签。
1 | from sklearn.metrics import silhouette_score, calinski_harabasz_score |
5. 降维:SVD 与 PCA
降维解决「特征太多」:在尽量保留信息的前提下压缩维度,用于加速训练、缓解维度灾难、高维可视化。本篇聚焦两块理论基石:奇异值分解(SVD),以及 SVD 与 PCA 的数学联系(PCA 的直觉与 sklearn 实操不再重复展开)。
5.1 奇异值分解(SVD)(了解)
SVD 是矩阵因子分解方法:任意非零实矩阵 $A$(不必是方阵)都能拆成三个矩阵的乘积:
$$A = U \Sigma V^\top$$
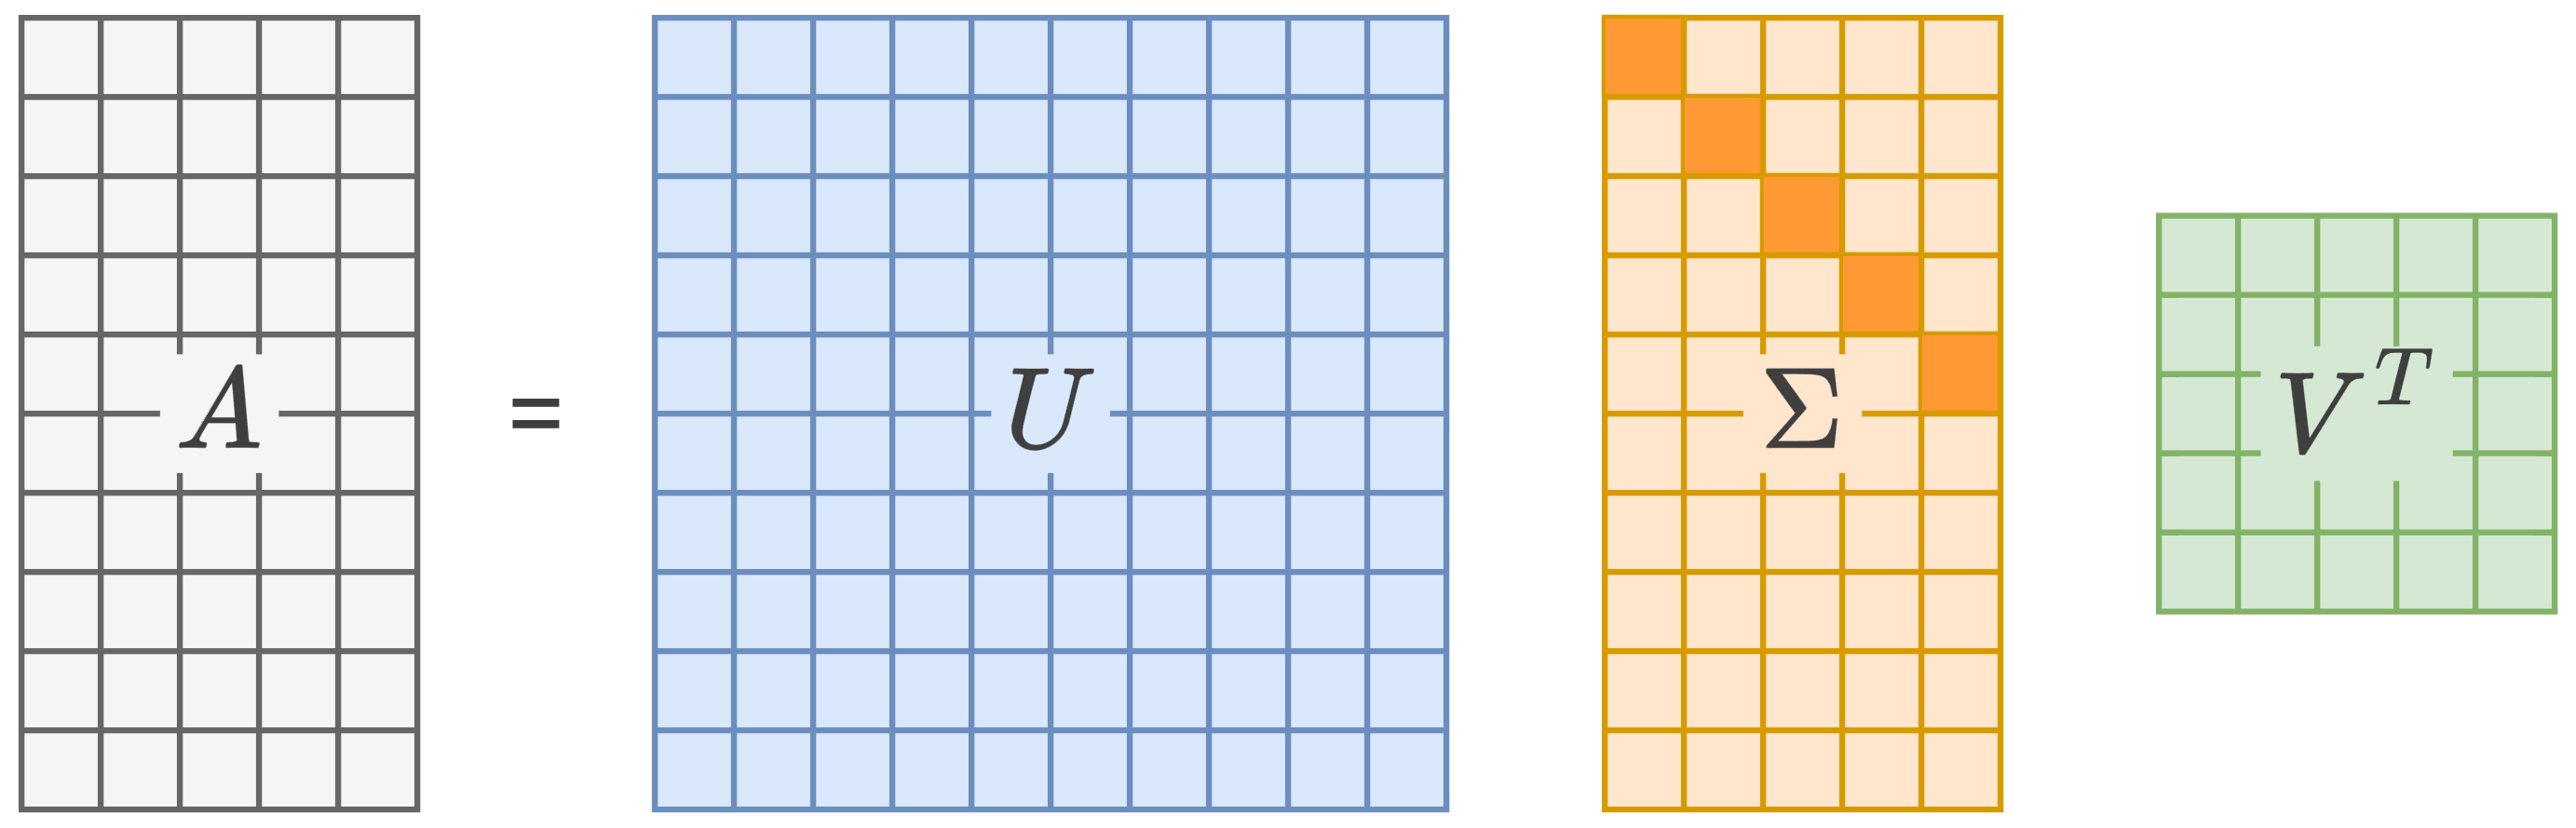
- $U$:左奇异向量组成的正交矩阵(列向量单位化、两两正交);
- $\Sigma$:矩形对角阵,对角线上是从大到小排列的非负奇异值;
- $V^\top$:右奇异向量的转置(正交矩阵)。
关键性质:奇异值按从大到小排列($\sigma_1 \ge \sigma_2 \ge \cdots$,这是数学保证);但「下降得快不快」取决于数据本身——只有当数据具有明显的低秩结构时(真实图像、用户×物品评分矩阵等常常如此),前几个奇异值才会占绝对大头,截断 SVD 才能用少数分量保留大部分信息;若数据没有低秩结构,奇异值可能下降平缓,强行截断就会丢掉较多信息。截断 SVD 只保留前 k 个奇异值和对应的奇异向量,就能近似重构原矩阵:
$$A \approx U_k \Sigma_k V_k^\top$$
这就是「用低秩近似压缩信息」:PCA、潜在语义分析等都是它的应用。文本的 TF-IDF 矩阵这类大规模稀疏矩阵常用 TruncatedSVD 做截断分解——PCA 默认要先中心化,而中心化会把稀疏矩阵变成稠密矩阵、内存吃不消;TruncatedSVD 不要求中心化,正好避开这一点。任意实矩阵都存在 SVD(但不唯一);手算可以通过求 $A^\top A$ 的特征值特征向量得到,过程略(实际应用中从不手算,直接调 np.linalg.svd)。
1 | import numpy as np |
5.2 PCA 与 SVD 的联系
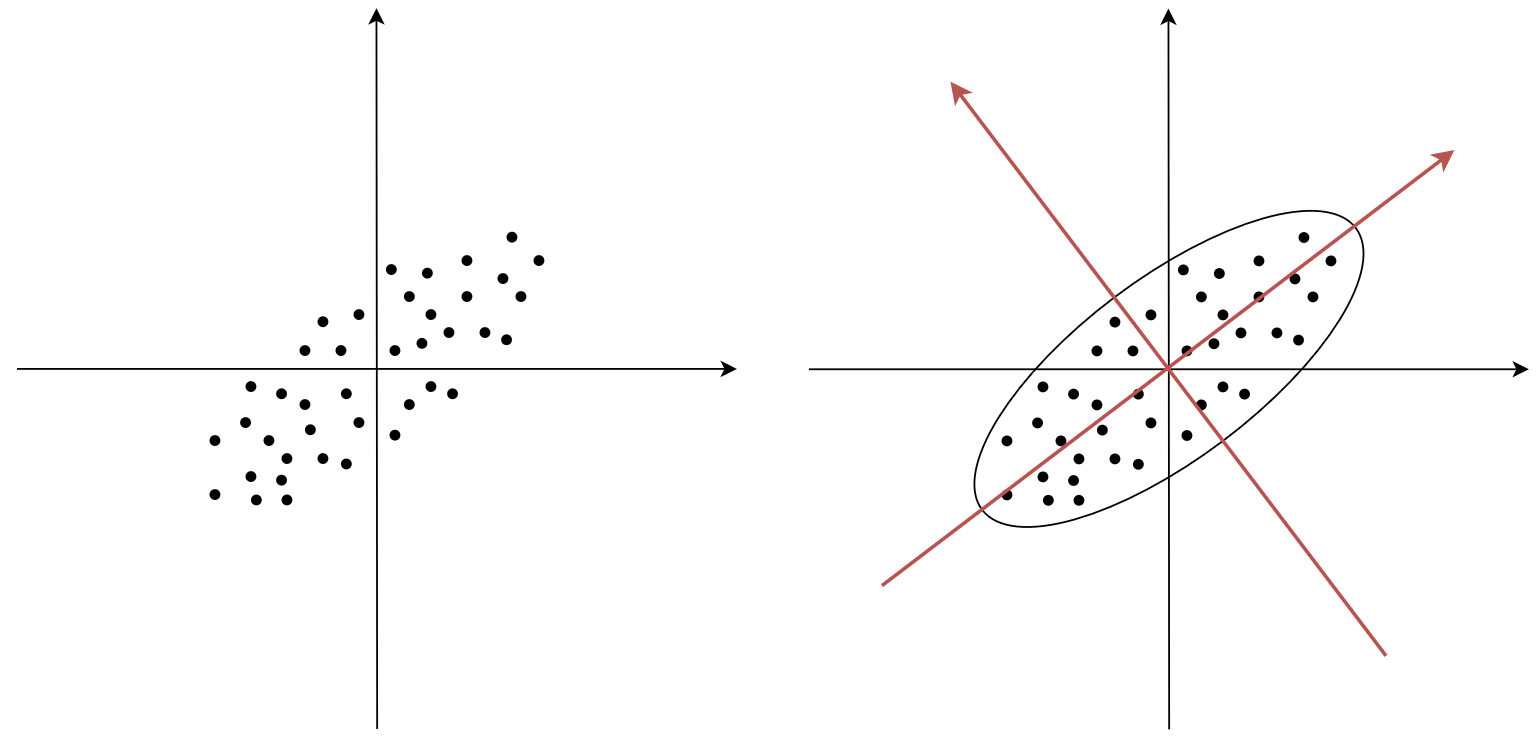
PCA 做的是同一件事:找到方差最大的正交方向(主成分),把数据投影过去。它的传统解法是协方差矩阵的特征分解:
- 数据每列中心化(减去均值;sklearn 的 PCA 默认会做)得到 $X$,协方差矩阵 $C = \frac{1}{n-1}X^\top X$;
- 对 $C$ 做特征分解,特征向量 = 主成分方向,特征值 = 各主成分的方差;
- 每个主成分的方差贡献率 = 该特征值 ÷ 全部特征值之和,据此决定保留几个。
而用 SVD 一步到位:对中心化后的 $X$ 做奇异值分解 $X = U\Sigma V^\top$,则
$$X^\top X = V \Sigma^2 V^\top$$
**右奇异向量 $V$ 就是主成分方向;协方差矩阵的特征值 = 奇异值的平方除以 $(n-1)$**,即 $\lambda_i = \sigma_i^2/(n-1)$——把 $X = U\Sigma V^\top$ 代入 $C = \frac{1}{n-1}X^\top X$ 即得 $C = V\frac{\Sigma^2}{n-1}V^\top$。差一个常数因子不影响主成分的排序与方向;sklearn 的 PCA 底层正是用 SVD 实现(跳过协方差矩阵,数值更稳定、计算更高效),两者的主成分完全一致,只是解法不同。
补充 无监督方法共同的使用纪律:PCA/聚类都没有「标签兜底」,结果好坏要结合业务解释与量化指标(贡献率、轮廓系数)双重验收;缩放、fit 只在训练集等纪律同样适用。
6. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 分类 vs 聚类 | 有标签学边界 vs 无标签找结构;聚类的簇语义要人来命名 |
| K-means 的 K vs KNN 的 K | 簇心个数 vs 投票邻居数,两码事 |
| 硬聚类 vs 软聚类 | 样本只属于一个簇(K-means、层次)vs 可以按概率属于多个簇 |
| K-means vs DBSCAN | 球形簇、需指定 K vs 任意形状、自动识别噪声但对参数敏感 |
| 聚合 vs 分裂层次聚类 | 自下而上逐轮合并最近簇 vs 自上而下逐轮劈开某簇 |
| WCSS vs 轮廓系数 | 前者只看簇内紧凑(K 越大必然越小);后者同时看簇内紧凑与簇间分离 |
| 奇异值 vs 特征值 | 特征值属于方阵的特征分解;奇异值属于任意矩阵的 SVD,且二者在 $X^\top X$ 上满足 $\lambda = \sigma^2$ |
| SVD vs PCA | 同一产物的两条解法:SVD 分解数据矩阵;PCA 分解协方差矩阵——方向一致,SVD 数值更稳 |