SVM 与朴素贝叶斯
30 秒先懂
SVM:在两类样本之间修一条「最宽的马路」,马路中线就是分类边界,离得最近的几个点(支持向量)说了算。朴素贝叶斯:用贝叶斯定理反推「看到这些特征,最可能是哪一类」,并天真地假设特征之间相互独立。
两者都是原文档标注【了解】的经典算法:前者代表「几何视角」做分类,后者代表「概率视角」做分类,对照着学正好互补。
第一部分:支持向量机(SVM)
1. 它解决什么问题?
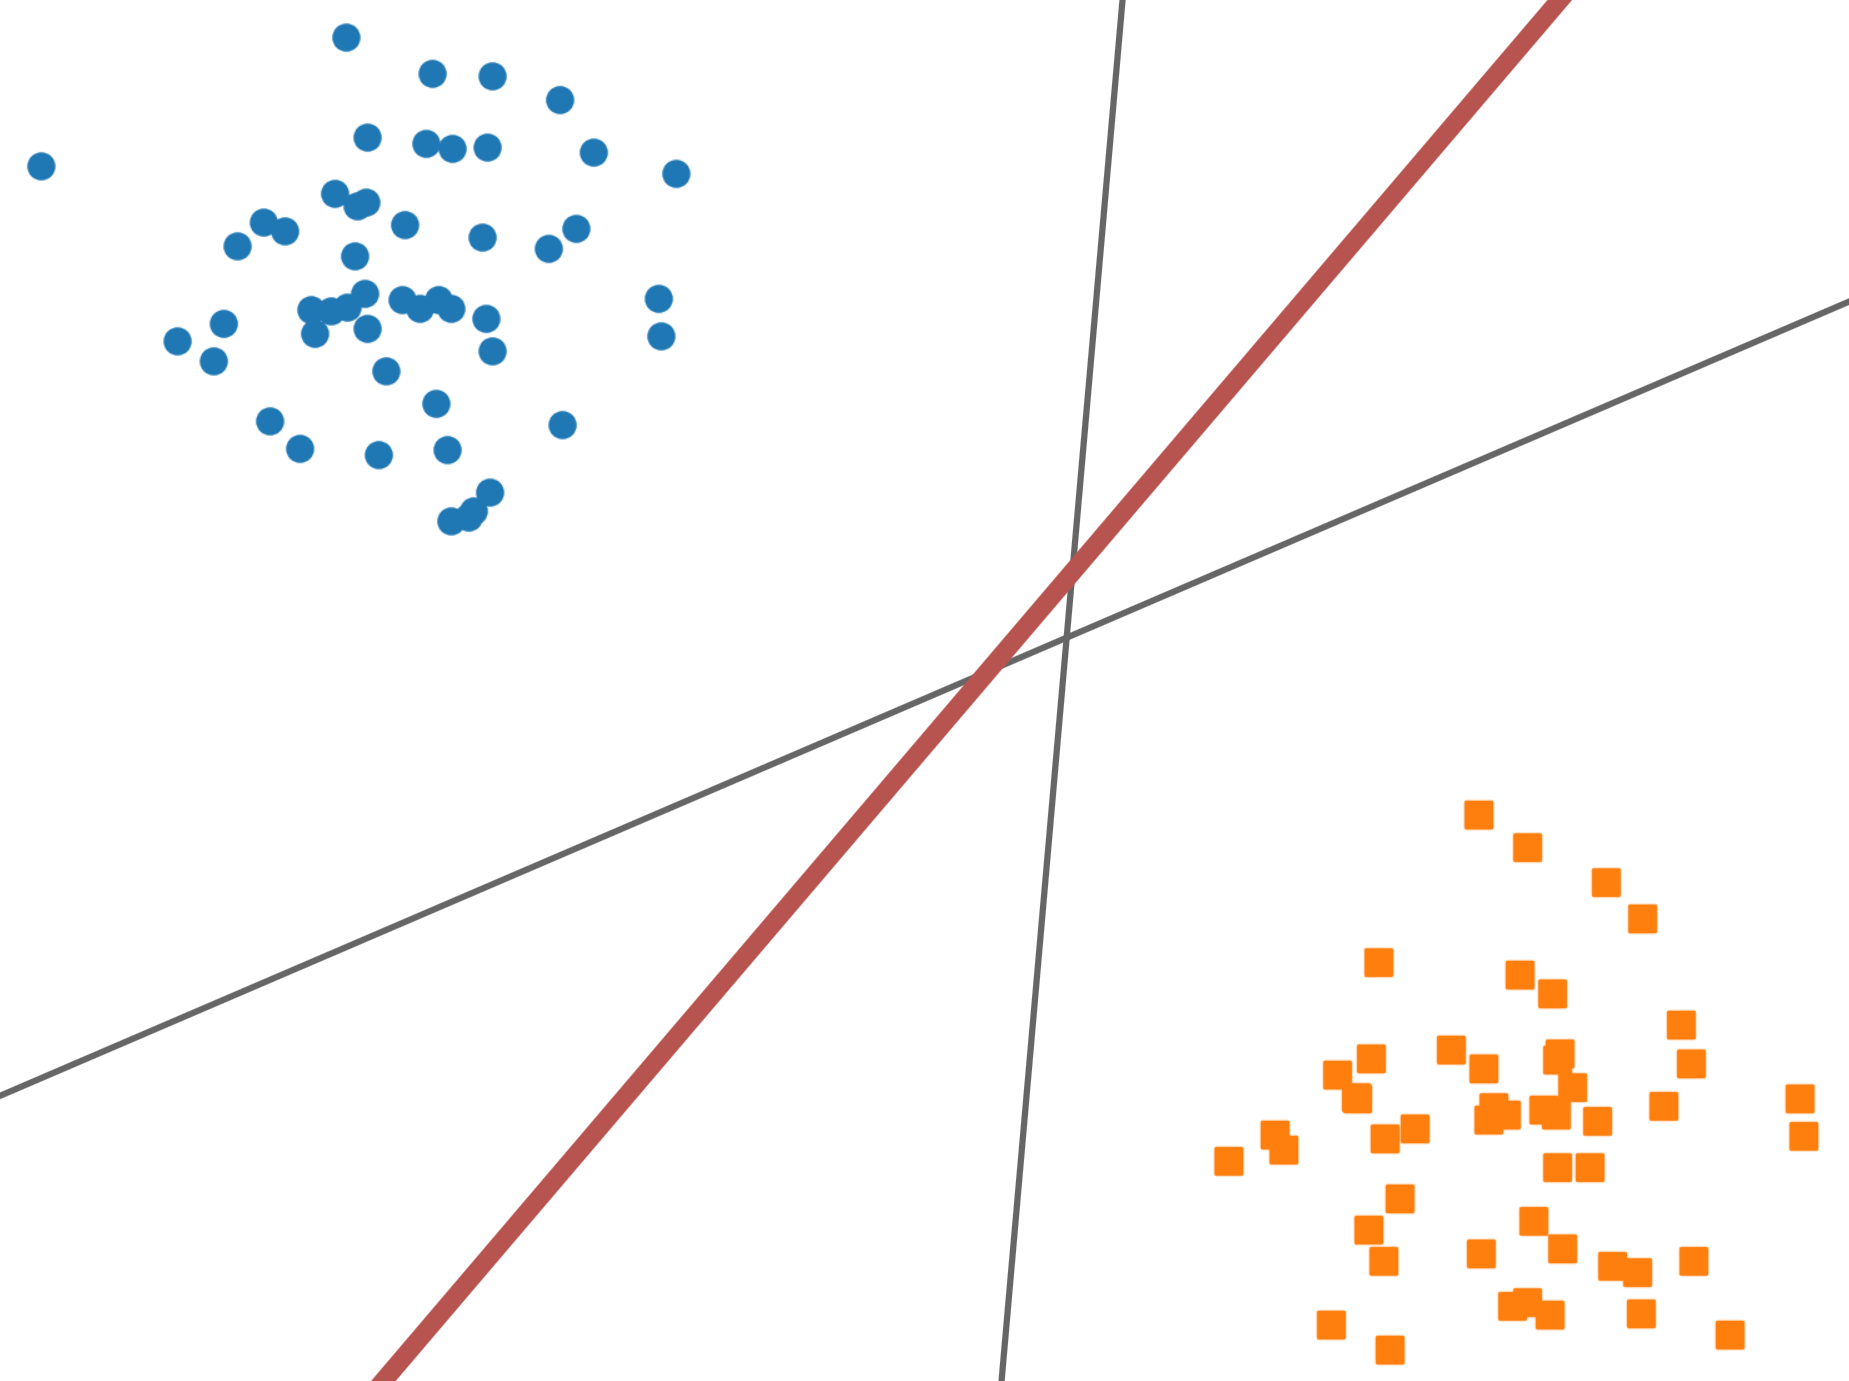
SVM(Support Vector Machine)是一个二分类模型:找一个超平面(二维是直线、三维是平面)把两类分开。可分开两类的直线往往有无数条,SVM 的标准与众不同——找间隔最大的那一条:
2. 核心直觉
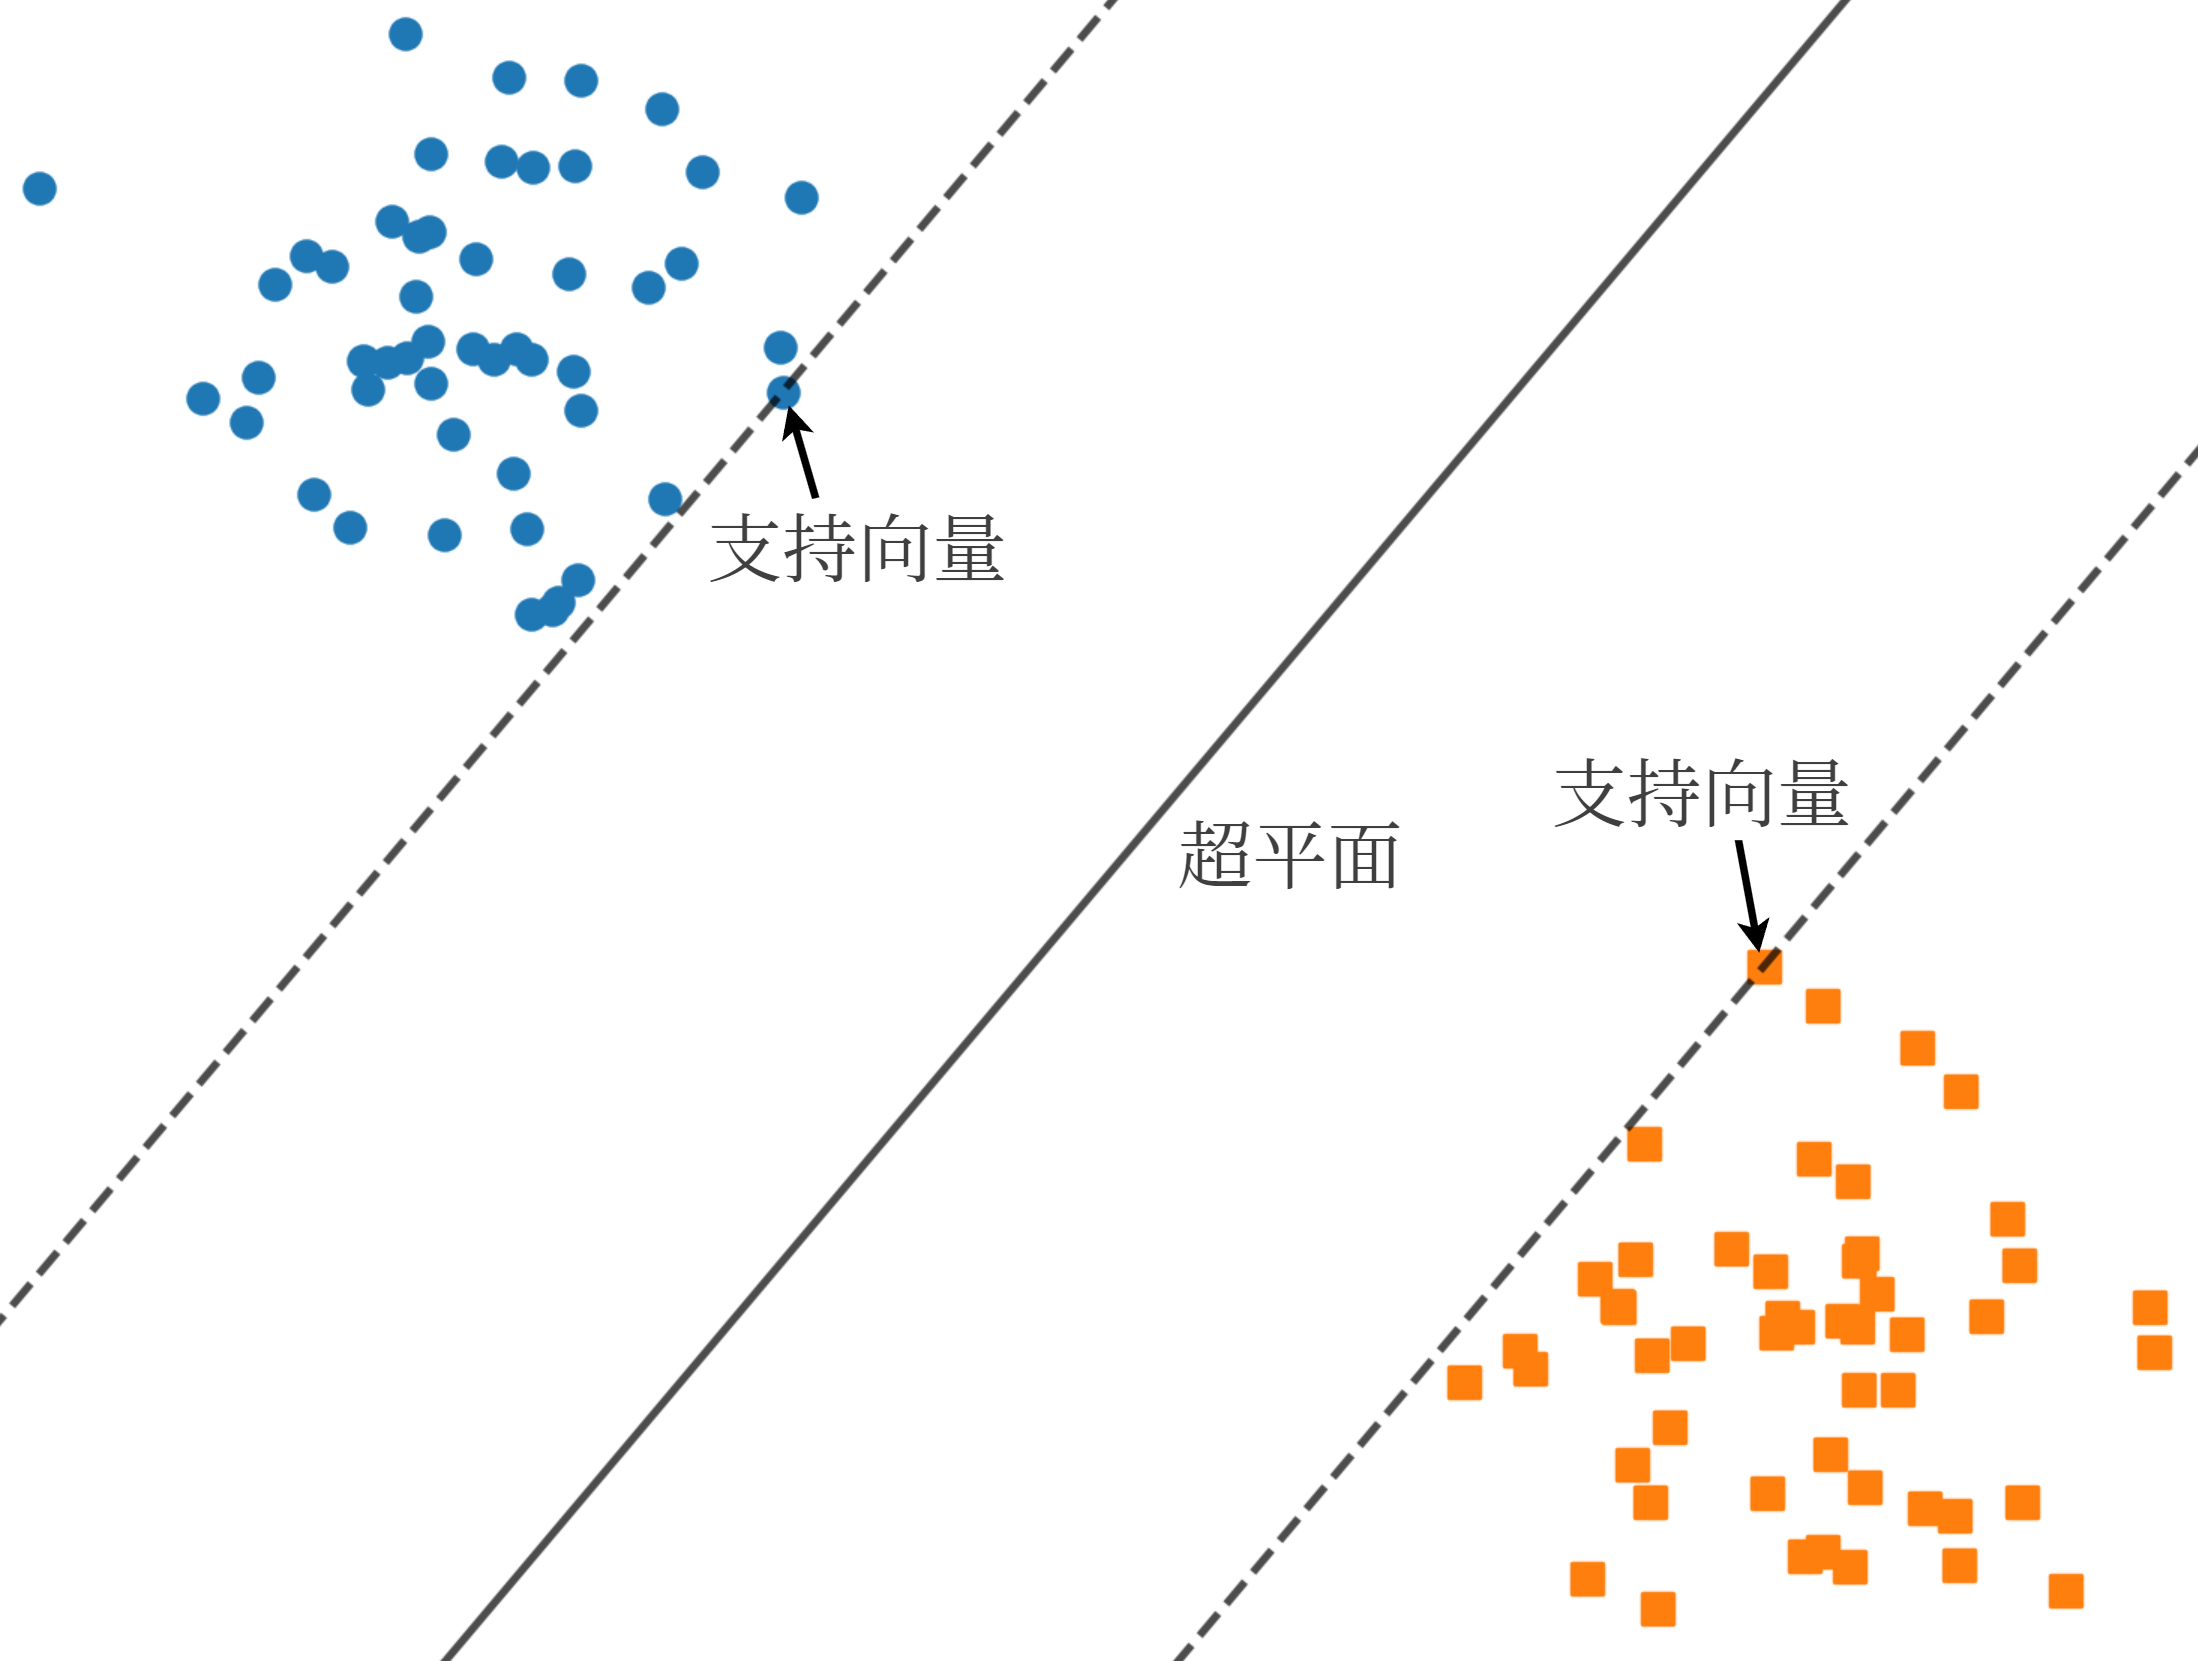
直觉一:修一条最宽的马路。 两类样本像马路两侧的房子,SVM 不但要把马路修在中间,还要让马路越宽越好——离两边都尽量远。为什么宽更好?宽马路两边留的缓冲大,新样本(测试数据)稍微偏一点也不会压线——泛化能力强。
直觉二:只有「路边的房子」说了算。 离超平面最近的几个样本叫支持向量——它们决定了马路的位置和方向;远处的样本再怎么增删,边界纹丝不动。
3. 数学表达 / 公式
3.1 超平面与点到它的距离
样本空间中的超平面:$w^\top x + b = 0$,其中 $w$ 是法向量(决定方向),$b$ 是位移项(决定离原点多远)。任一点 $x$ 到超平面的距离:
$$d = \frac{\vert w^\top x + b \vert}{\lVert w \rVert}$$
这就是立体几何里「点到平面的距离公式」,分母 $\lVert w \rVert$ 是权重的模长。
3.2 硬间隔:约束下的最大化
把超平面记作 $w^\top x + b = 0$,要求所有样本都被正确分类:
$$y_i(w^\top x_i + b) \ge 1$$
(正样本算出来 $\ge 1$、负样本 $\le -1$,符号天然区分两类。)缩放 $(w, b)$ 不改变超平面本身,所以不妨把最近的点(支持向量)的取值归一化为恰好等于 1。此时两类支持向量之间的间隔为:
$$\text{margin} = \frac{2}{\lVert w \rVert}$$
「间隔最大」就等价于 $\lVert w \rVert$ 最小,SVM 的基本型出炉:
$$\min_{w, b} ; \frac{1}{2}\lVert w \rVert^2 \quad \text{s.t.} \quad y_i(w^\top x_i + b) \ge 1$$
这是一个凸优化问题(二次目标 + 线性约束),常用拉格朗日乘子法转成对偶问题求解。
手算一次。经典二维小例:正类样本 $(3,3)、(4,3)$,负类样本 $(1,1)、(0,0)$。最优解为 $w = (0.5,\ 0.5)$,$b = -2$。逐点验证约束 $y_i(w^\top x_i + b) \ge 1$:
| 样本 | $w^\top x + b$ | 是否满足 |
|---|---|---|
| $(3,3)$ 正 | $1.5+1.5-2 = 1$ | ✅ 恰好 = 1(支持向量) |
| $(4,3)$ 正 | $2+1.5-2 = 1.5$ | ✅ 大于 1 |
| $(1,1)$ 负 | $0.5+0.5-2 = -1$ | ✅ 乘 $y=-1$ 后 $=1$(支持向量) |
| $(0,0)$ 负 | $-2$ | ✅ 乘 $y=-1$ 后 $=2$ |
间隔 $= \dfrac{2}{\lVert w \rVert} = \dfrac{2}{\sqrt{0.25+0.25}} = 2\sqrt{2} \approx 2.83$。注意支持向量只有 $(3,3)$ 和 $(1,1)$ 两个——把 $(4,3)$ 或 $(0,0)$ 删掉,边界不变。
3.3 软间隔:现实数据没有这么乖
硬间隔假设两类能被完美分开——现实数据常有少数「捣乱分子」,硬把它们分开反而学到了噪声。软间隔引入松弛变量 $\xi_i \ge 0$,允许个别样本越线:
$$y_i(w^\top x_i + b) \ge 1 - \xi_i$$
同时在目标函数里为每个 $\xi_i$ 付罚金:
$$\min_{w, b, \xi} ; \frac{1}{2}\lVert w \rVert^2 + C\sum_{i=1}^{n}\xi_i$$
惩罚系数 $C$ 是超参数,控制「宽马路」与「零越线」的权衡:
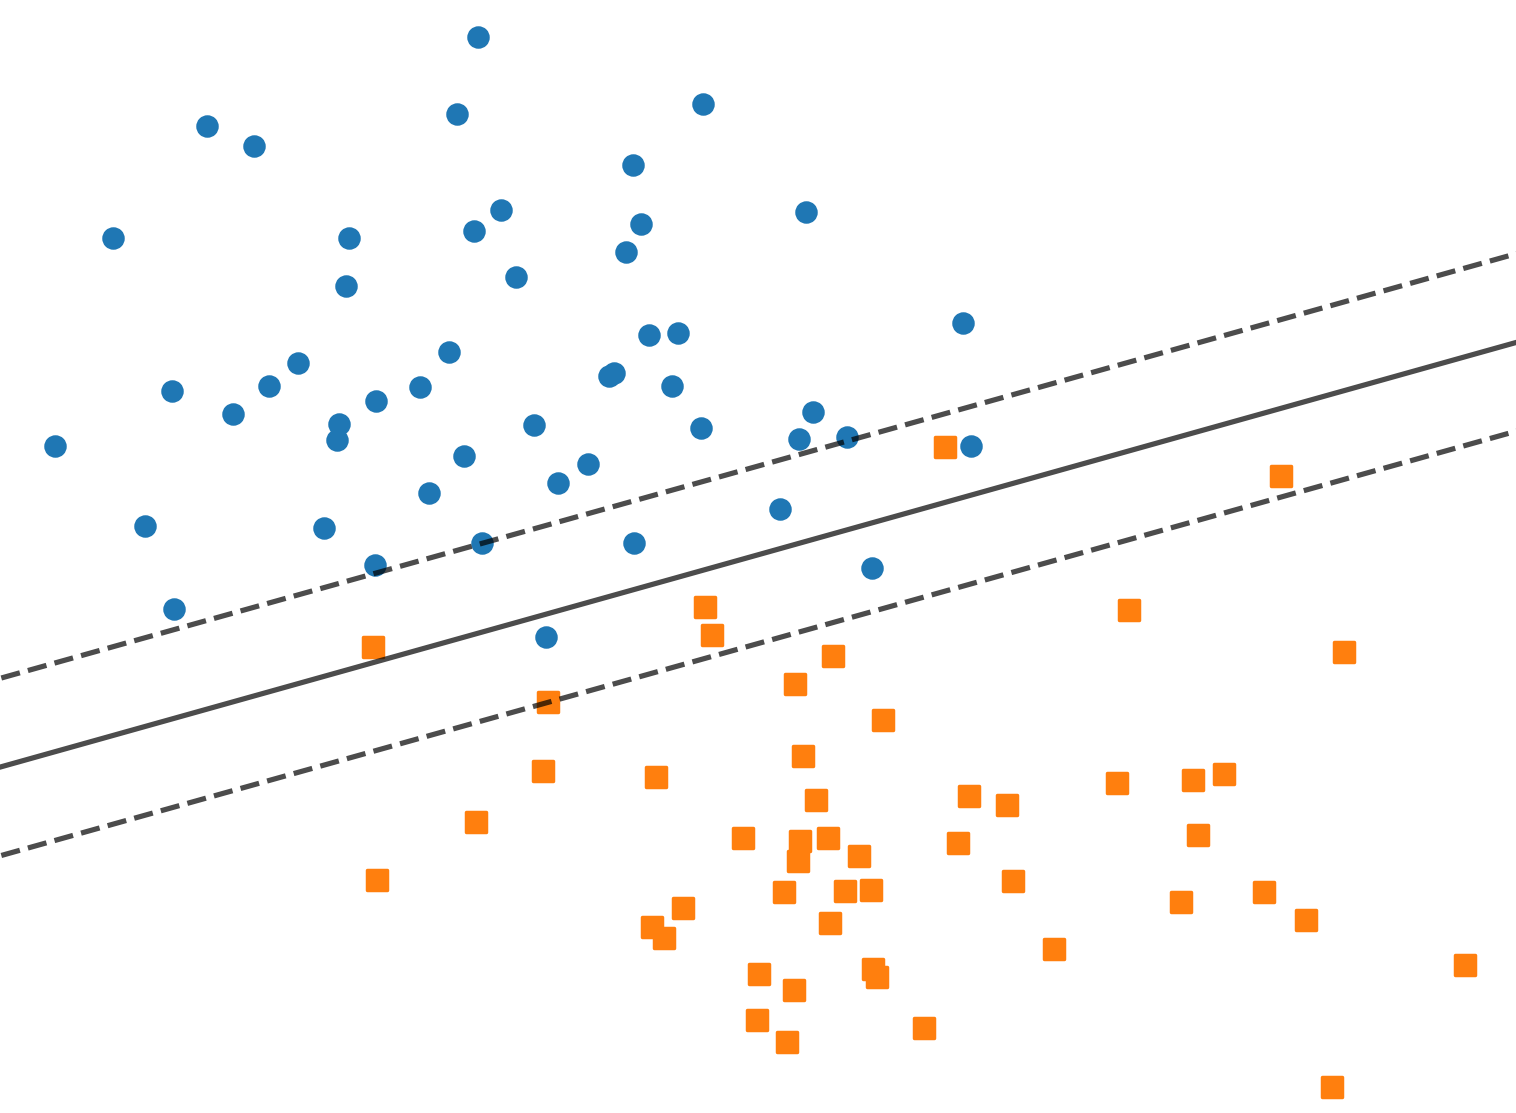
- C 大:对越线零容忍 → 边界被个别样本带偏 → 过拟合风险;
- C 小:宽马路优先、容忍错分 → 欠拟合风险。
3.4 核函数:切不开就升维
如果数据在当前空间压根线性不可分呢?
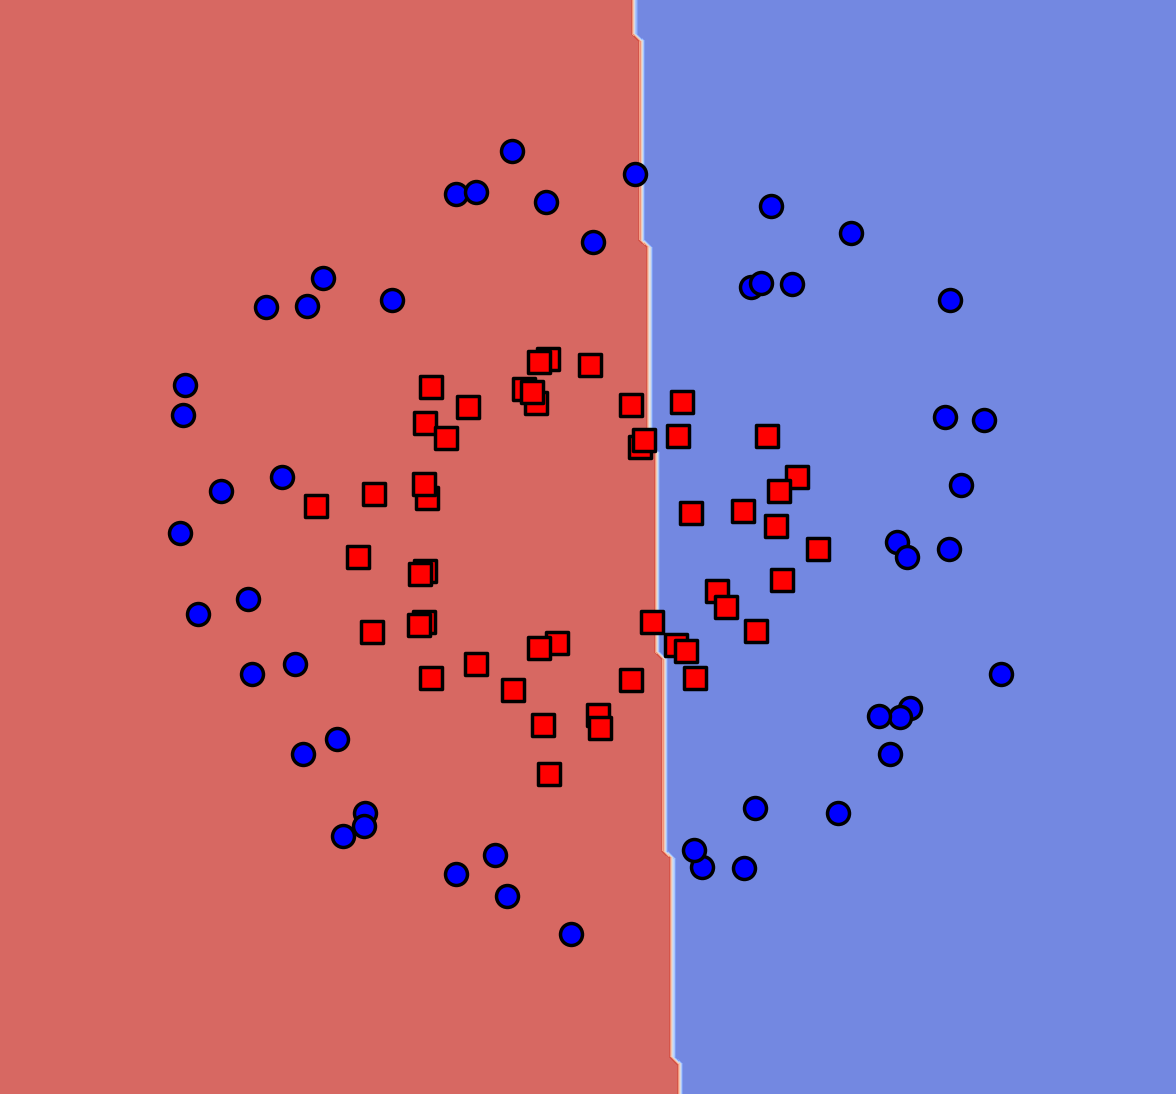
SVM 的杀手锏:把数据映射到更高维的空间,让它们在高维里线性可分,在高维里继续修马路:
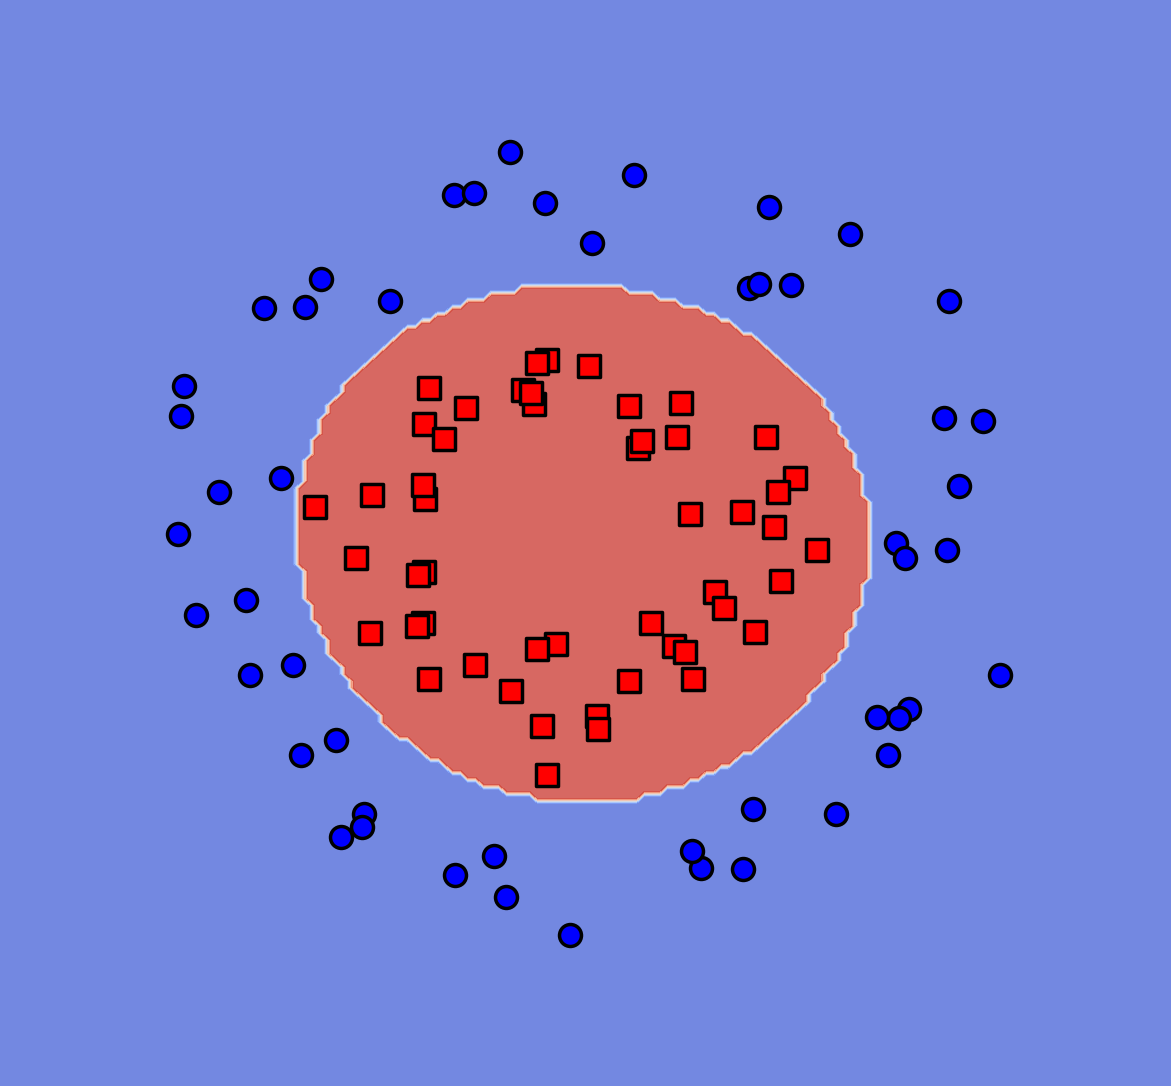
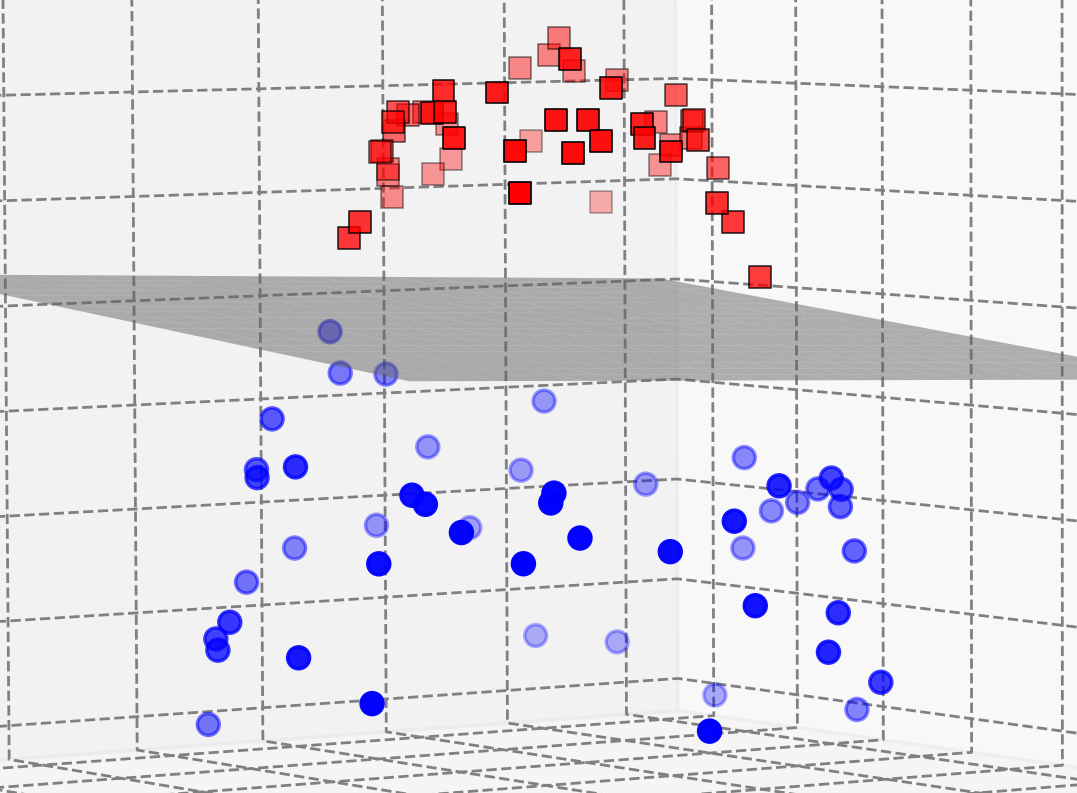
妙处在于:整个求解过程只需要「两个样本的内积」,而这个内积不必真的去高维算——用一个函数(核函数)在低维直接算出来,这就是核技巧。常用核函数:
| 核函数 | 公式 | 适用 |
|---|---|---|
| 线性核 | $K(x_i, x_j) = x_i^\top x_j$ | 本来就近似线性可分、特征很多 |
| 多项式核 | $K(x_i, x_j) = (\gamma, x_i^\top x_j + r)^q$ | 需要适度非线性 |
| 高斯核(RBF) | $K(x_i, x_j) = \exp(-\gamma \lVert x_i - x_j \rVert^2)$ | 通用性最强、默认首选 |
补充 核函数是 SVM 最大的变数:选错了等于把数据映射到一个不合适的空间,性能可能反而变差。实践中通常先试 RBF,把 $\gamma$ 和 $C$ 交给网格搜索。
5. Python / sklearn 怎么实现?(补充)
1 | from sklearn.svm import SVC |
两个关键超参数的二维理解:C 管「要不要在乎训练错分」——C 大逼近硬间隔、边界容易被个别样本带偏;gamma 管「每个样本的影响半径」——gamma 大影响范围窄、边界更弯更碎。RBF 核下两者通常一起交给网格搜索。
工程提示:样本量上万、特征上万(高维文本)时用 LinearSVC(线性核的专用快实现,比通用 SVC 快得多);SVC(probability=True) 可以输出概率,但那是训练后额外校准得到的、训练成本明显增加;另外支持向量太多时存储同样可观——「支持向量机」并不自动内存友好。
优缺点:优点——间隔最大化带来强泛化、核技巧处理非线性、只依赖支持向量(内存友好);缺点——大数据集训练慢、对缺失和尺度敏感、多分类要拆解、调参(C、γ)依赖经验。
第二部分:朴素贝叶斯
6. 它解决什么问题?
朴素贝叶斯(Naive Bayes)是概率视角的分类器:直接算「给定这些特征,属于每个类别的概率各是多少」,选概率最大的类别。垃圾邮件识别是它的成名场景,情感分析、文本分类至今常用。
7. 核心直觉
直觉一:贝叶斯定理是「反着推」。 我们容易统计的是「垃圾邮件里出现『免费』的概率」(原因 → 结果),但预测时想要的是「出现『免费』,它是垃圾邮件的概率」(结果 → 原因)。贝叶斯定理就是这座桥:
$$P(Y \mid X) = \frac{P(X \mid Y), P(Y)}{P(X)}$$
| 量 | 名字 | 在垃圾邮件例子中 |
|---|---|---|
| $P(Y\mid X)$ | 后验概率(要算的目标) | 邮件含「免费」时,是垃圾邮件的概率 |
| $P(X\mid Y)$ | 条件概率(容易从数据统计) | 垃圾邮件中含「免费」的概率 |
| $P(Y)$ | 先验概率 | 随机一封邮件是垃圾邮件的概率 |
| $P(X)$ | 证据 | 邮件含「免费」的概率(对各类相同) |
手算一次:已知 $P(\text{垃圾}) = 0.3$,$P(\text{免费}\mid\text{垃圾}) = 0.4$,$P(\text{免费}\mid\text{正常}) = 0.05$。先算证据:
$$P(\text{免费}) = 0.3 \times 0.4 + 0.7 \times 0.05 = 0.155$$
$$P(\text{垃圾}\mid\text{免费}) = \frac{0.3 \times 0.4}{0.155} \approx 0.774$$
「免费」一词把垃圾邮件的概率从先验的 30% 拉到 77%——这就是贝叶斯更新。
直觉二:「朴素」在哪? 邮件有一堆词(免费、中奖、链接……),完整的贝叶斯要算这些词的联合概率——词与词显然有关联,根本算不过来。朴素贝叶斯大胆假设:给定类别,所有特征相互独立。于是联合概率退化为连乘:
$$P(x_1, \dots, x_d \mid Y = c) = \prod_{j=1}^{d} P(x_j \mid Y = c)$$
假设当然不真实(「免费」和「中奖」常常一起出现),但我们不需要概率多准,只需要各类别相对大小排对序——朴素贝叶斯在文本分类上长期表现优秀,就是「假设错了、结论不差」的著名案例。
8. 数学表达 / 公式
学习过程 = 从训练数据数出两类概率(极大似然估计):
- 先验:$P(Y = c_k) = \dfrac{\text{第 } k \text{ 类样本数}}{\text{总样本数}}$;
- 条件概率:$P(x_j = a \mid Y = c_k) = \dfrac{\text{第 } k \text{ 类中 } x_j = a \text{ 的样本数}}{\text{第 } k \text{ 类样本数}}$。
分类过程:对每个类别计算(分子的)后验,取最大:
$$\hat{y} = \arg\max_{c_k}; P(Y = c_k) \prod_{j=1}^{d} P(x_j \mid Y = c_k)$$
零概率灾难与拉普拉斯平滑。极大似然估计有个坑:如果「免费」在训练集的 10 封垃圾邮件里一次都没出现过,估计出 $P(\text{免费}\mid\text{垃圾}) = 0$——而连乘里只要有一个 0,整个后验就归零,其他特征的信息全被抹掉。贝叶斯估计(拉普拉斯平滑)在分子分母上各加一点:
$$P_\lambda(x_j = a \mid Y = c_k) = \frac{\text{计数} + \lambda}{\text{总数} + \lambda \cdot K}$$
$\lambda = 1$ 时称拉普拉斯平滑($K$ 为该特征的取值数)。手算:$P = \dfrac{0 + 1}{10 + 2 \times 1} = \dfrac{1}{12} \approx 0.083$——从「绝对不可能」变成「很少见」,乘积不再归零,且样本量大时平滑对估计几乎无影响。
1 | from sklearn.naive_bayes import GaussianNB, MultinomialNB, BernoulliNB, ComplementNB |
补充 实际计算时,概率连乘都用对数概率求和代替($\log(ab) = \log a + \log b$)——几十上百个小于 1 的概率直接相乘会数值下溢变成 0,取对数后就是普通加法,稳定得多。
优缺点:优点——训练和预测都快、小数据可用、天然支持多分类;缺点——独立性假设过强(特征相关时吃亏)、输出概率未经校准、平滑参数需要留意。
9. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 支持向量 vs 普通样本 | 支持向量是离边界最近、恰好「踩线」的样本,只有它们决定超平面;删普通样本边界不变 |
| 硬间隔 vs 软间隔 | 前者要求全部分对(数据必须线性可分);后者用松弛变量 + 惩罚 C 容忍个别越线 |
| 惩罚 C 的方向 | C 大 → 逼近硬间隔、边界易被带偏;C 小 → 马路宽、容忍错分 |
| 核函数 vs 直接升维 | 核技巧不在高维里真的算,用核函数在低维「代算」内积,省掉了升维 |
| 先验 vs 后验 | 先验是「开看数据前」的 P(Y);后验是「看完特征 X 后」的 P(Y|X) |
| 朴素贝叶斯的「朴素」 | 指条件独立假设天真,不是指算法性能差——文本分类里它长期是强基线 |
| 极大似然 vs 拉普拉斯平滑 | 前者直接数比例(可能数出 0);后者分子加 λ 分母加 λK,防止零概率灾难 |