模型评估与选择
整章回答一个问题:怎么判断一个模型好不好,以及怎么把最好的那个选出来?(原文档标注【重点】)
1. 机器学习三要素
原文档把一切机器学习方法概括为:
$$\text{机器学习方法} = \text{模型} + \text{策略} + \text{算法}$$
| 要素 | 回答的问题 | 例子 |
|---|---|---|
| 模型(Model) | 用什么形式的函数去描述数据规律? | 线性函数、决策树、神经网络 |
| 策略(Strategy) | 用什么标准判断模型「好」? | 损失函数、经验风险最小化 |
| 算法(Algorithm) | 用什么方法找到那个最优模型? | 最小二乘、梯度下降、牛顿法 |
补充 分析任何机器学习问题都可以用这个「三连问」拆解:模型是什么形式?优化目标(策略)是什么?用什么算法求解?本章讲的损失函数与正则化属于策略,后面单独一篇的梯度下降属于算法。
2. 建模全流程
以监督学习为例,一次完整的建模过程如下:
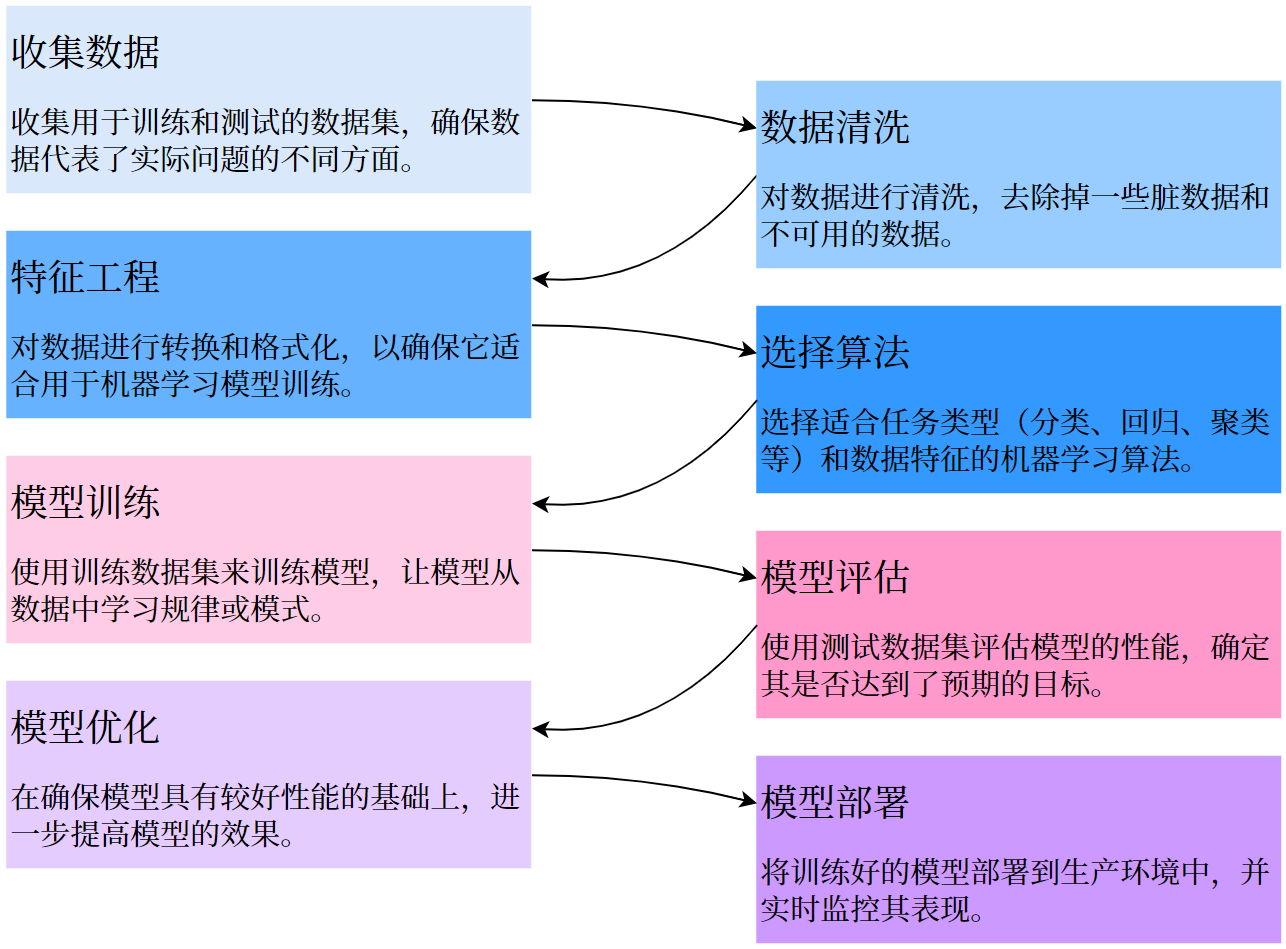
| 步骤 | 做什么 |
|---|---|
| 1. 收集数据 | 收集用于训练和测试的数据集,确保数据能代表实际问题 |
| 2. 数据清洗 | 去除脏数据、缺失值、不可用的数据 |
| 3. 特征工程 | 对数据做转换和格式化,使其适合模型训练 |
| 4. 选择算法 | 按任务类型(分类/回归/聚类等)和数据特点选算法 |
| 5. 模型训练 | 用训练集训练模型,让模型从数据中学习规律 |
| 6. 模型评估 | 用验证集 / 交叉验证评估性能,判断是否达到预期目标 |
| 7. 模型优化 | 基于验证结果继续调优(调参、换特征、换算法),回到第 3 步循环 |
| 8. 最终测试 | 方案定稿、用全部训练数据重新拟合后,测试集只出场这一次 |
| 9. 模型部署 | 部署到生产环境并持续监控表现 |
补充 两个要点:① 这条流程是闭环而不是单行道——第 6 步验证不达标,回到第 3 步换特征、第 4 步换算法,反复迭代,这正是「特征工程是迭代过程」的含义;② 闭环里转的必须是验证集/交叉验证,测试集绝不参与迭代——它一旦影响了调参或特征选择,就不再是独立测试集,最终成绩会虚高。「选模型」和「最终评估」是两件事:前者在训练数据内部(Train ↔ 验证)反复进行,后者只发生一次。
3. 损失函数:衡量「一次预测」的好坏
对监督学习,模型就是一个决策函数 $f$:输入 $X$,输出预测 $f(X)$;真实值记为 $Y$。两者之间会有偏差,损失函数(Loss Function)就是度量这个偏差的函数,记作:
$$L(Y, f(X))$$
三条基本性质:损失函数是 $Y$ 和 $f(X)$ 的非负实值函数;损失越小,预测越好;损失函数是我们定义「什么是好模型」的地方(策略)。
3.1 四种常见损失函数
| 名称 | 公式 | 常用于 | 特点 |
|---|---|---|---|
| 0-1 损失 | $L(Y,f(X))=\begin{cases}0, & Y=f(X) \ 1, & Y\neq f(X)\end{cases}$ | 分类 | 只看对错、不看错多少;不连续、不可导,实际很少直接做优化目标 |
| 平方损失 | $L(Y,f(X))=(Y-f(X))^2$ | 回归 | 放大大误差;处处可导、求解方便;对异常值敏感 |
| 绝对损失 | $L(Y,f(X))=\vert Y-f(X)\vert$ | 回归 | 对异常值更鲁棒;在零点不可导 |
| 对数似然损失 | $L(Y,P(Y\vert X))=-\log P(Y\vert X)$ | 概率分类 | 惩罚「自信的错误」——把正确类概率压得越低,罚得越重 |
手算一次:模型对某个样本给出预测:真实值 $Y=3$,预测值 $f(X)=2$:
- 平方损失:$(3-2)^2 = 1$
- 绝对损失:$\vert 3-2\vert = 1$
- 0-1 损失:$3 \neq 2$,记 1
同样是「偏了 1」这个事实,不同损失函数给出的数值不同——损失函数就是我们自己对「坏」下的定义,定义不同,模型学出来的样子也不同。
补充 三个术语辨析:损失函数针对单个样本;代价/成本函数(Cost Function)通常是全体样本损失的平均;目标函数(Objective Function)是最终要优化的东西(代价函数 + 正则化项等)。很多文献混用这三个词,看到时要按上下文判断。
4. 经验误差与泛化误差
把损失在一个数据集上取平均,就得到评估整个模型的误差。
训练集上的平均误差称为训练误差,也叫经验误差(Empirical Error)或经验风险(Empirical Risk):
$$R_{emp}(f) = \frac{1}{n}\sum_{i=1}^{n} L\big(y_i, f(x_i)\big)$$
手算一次:3 个样本,真实值 $y = [3, 5, 2]$,模型预测 $\hat{y} = [2, 5, 4]$:
| 样本 | 真实 | 预测 | 平方损失 | 绝对损失 |
|---|---|---|---|---|
| 1 | 3 | 2 | 1 | 1 |
| 2 | 5 | 5 | 0 | 0 |
| 3 | 2 | 4 | 4 | 2 |
取平方损失,经验误差 = $(1+0+4)/3 \approx 1.67$(这就是均方误差 MSE);取绝对损失 = $3/3 = 1$(平均绝对误差 MAE)。经验误差不是新东西,只是「每个样本的损失加起来除以 n」——但换一种损失函数,同一个模型的「分数」就不一样。
测试集上的平均误差称为测试误差,也常被叫做泛化误差(Generalization Error)。
经验风险最小化(Empirical Risk Minimization,ERM):让经验误差最小的模型就当作最优模型——这是最常用的模型评估策略。
补充 一个根本矛盾:我们真正关心的是模型对未见数据的泛化能力,但训练时能直接看到的只有经验误差。测试误差只是泛化误差的一个近似估计(严格的教材里,泛化误差指模型对全体未知数据的期望误差)。整个「模型评估与选择」这一章,本质上都是在弥补这个信息差——下一节的过拟合就是这个矛盾的直接后果。
5. 欠拟合与过拟合
30 秒先懂
欠拟合 = 没学会(训练集都考不好);过拟合 = 背题(训练集满分,换套题就崩)。
拟合(Fitting)指模型在训练数据上学习规律并生成预测的过程。理想情况:既准确捕捉训练数据的模式,又在没见过的新数据上表现良好——即具有良好的泛化能力。
三种状态一眼看懂(同一批数据,三种模型):
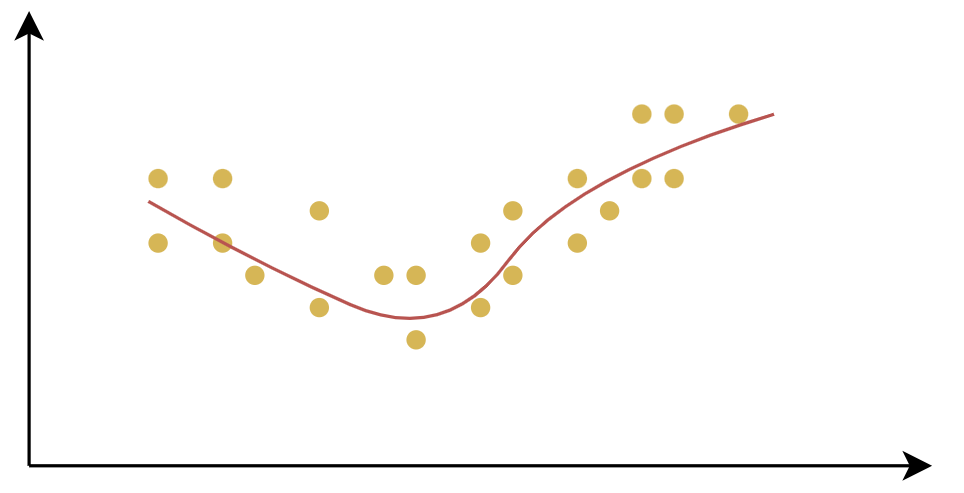
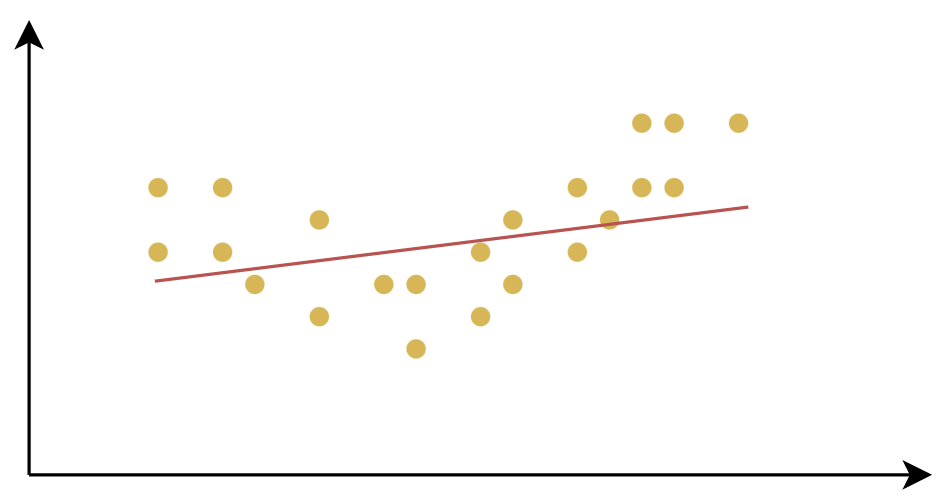
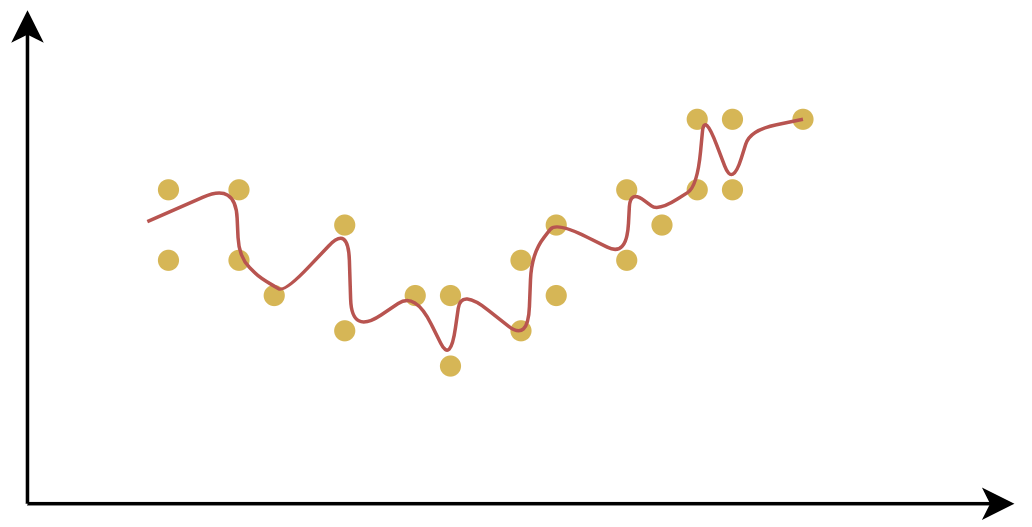
| 训练集表现 | 测试集表现 | 本质 | |
|---|---|---|---|
| 欠拟合(Underfitting) | 差 | 差 | 模型过于简单,高偏差 |
| 过拟合(Overfitting) | 很好 | 明显变差 | 模型过于复杂,高方差——把训练样本自身的噪声、细节当成了普遍规律 |
根本原因:模型复杂度与数据规律不匹配,导致测试误差(泛化误差)偏大。看误差随模型复杂度变化的经典曲线:
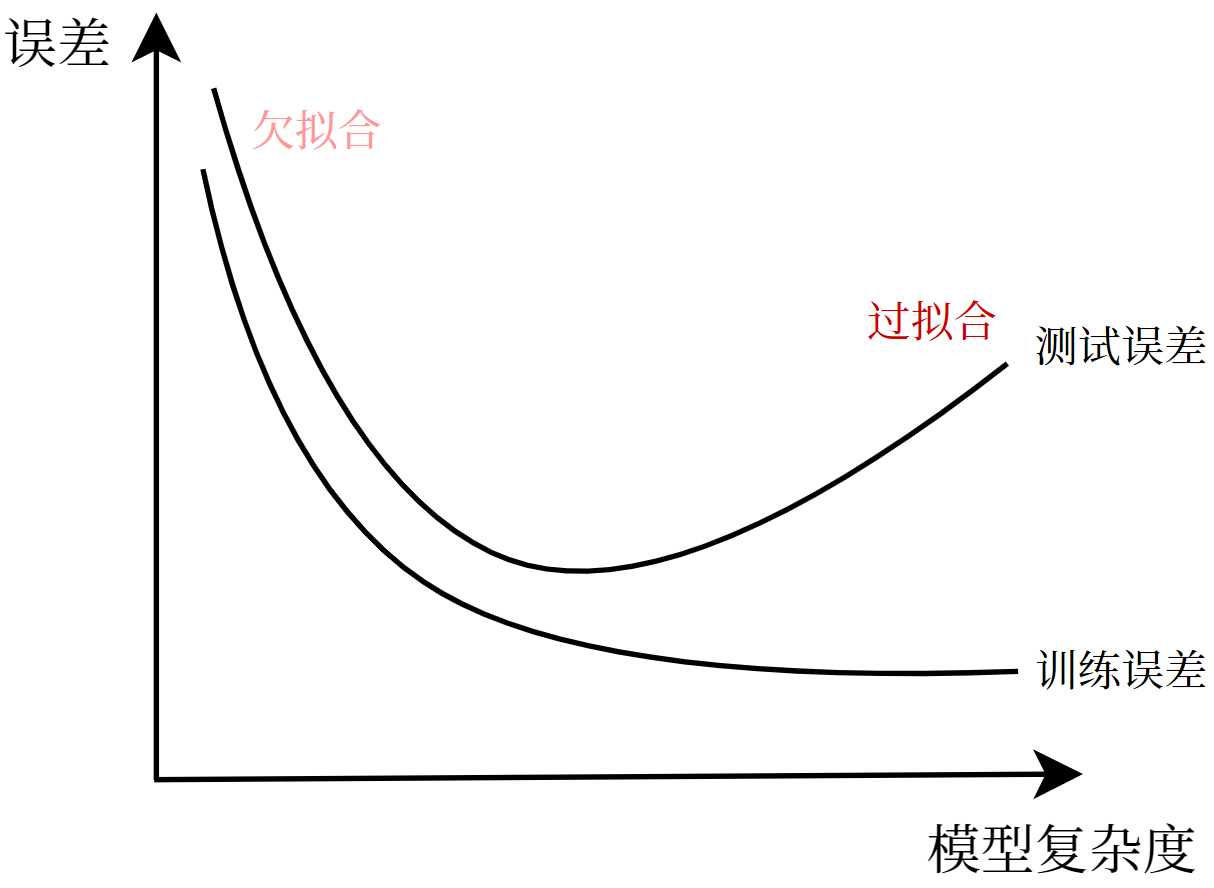
- 左侧(欠拟合区):复杂度太低,训练误差和测试误差都很高;
- 中间谷底:复杂度适中,训练误差和测试误差都低——我们要选的模型就在这里;
- 右侧(过拟合区):复杂度继续升高,训练误差一路下降,测试误差反而回升——模型开始「背题」。
5.1 产生原因与解决办法
| 常见原因 | 解决办法 | |
|---|---|---|
| 欠拟合 | 模型复杂度不足;特征不足或选择不当;训练迭代次数太少;正则化强度过大 | 增加模型复杂度;增加/改进特征;增加训练时间;减小正则化强度 |
| 过拟合 | 模型复杂度过高(参数太多);训练数据太少;特征太多;训练时间过长 | 减小模型复杂度/降维;增加数据或数据增强;正则化(L1/L2);交叉验证;早停(验证损失不再下降时停止训练) |
5.2 代码演示:用多项式拟合看三种状态
用 $n$ 次多项式在正弦数据上做线性回归:次数 1(太简单)、5(合适)、20(太复杂):
1 | import numpy as np |
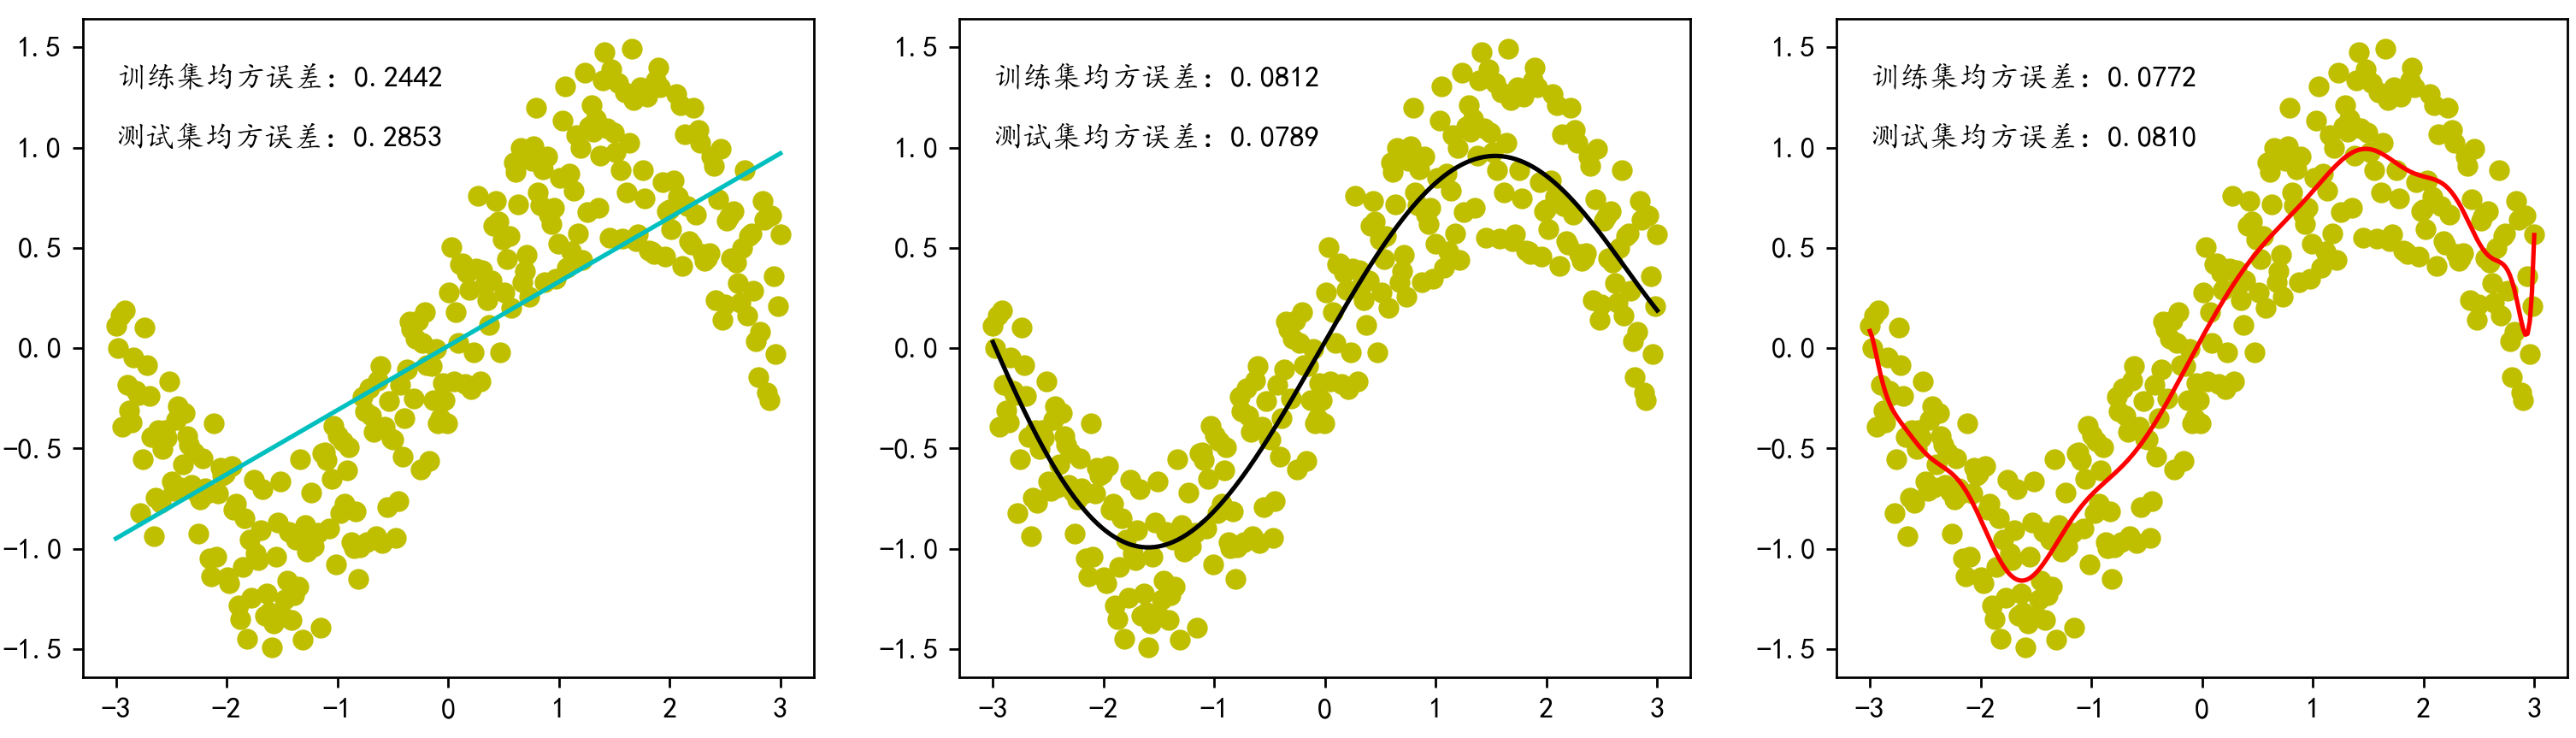
读图(对照误差曲线的三个区域):
| 次数 | 训练 MSE | 测试 MSE | 状态 |
|---|---|---|---|
| 1 | 0.2442 | 0.2853 | 两者都高 → 欠拟合 |
| 5 | 0.0812 | 0.0789 | 两者都低 → 恰好拟合 |
| 20 | 0.0772(更低!) | 0.0810(反弹) | 过拟合 |
注意 20 次的训练误差是三者最低的——过拟合的模型在训练集上永远「更好」,所以绝不能只拿训练误差来选模型。
6. 正则化(Regularization)
1. 它解决什么问题?
过拟合的直接原因是模型太复杂、参数太大(比如 20 次多项式里出现 ±5 的巨大系数去「硬拐弯」)。正则化在损失函数里加一个惩罚项,专门惩罚过大的参数,从而限制模型复杂度、抑制过拟合、提高泛化能力。
加入正则化后,评估策略从「经验风险最小化」升级为结构风险最小化(Structural Risk Minimization,SRM):
$$\underbrace{\frac{1}{n}\sum_{i=1}^{n} L\big(y_i, f(x_i)\big)}{\text{经验风险:拟合数据}} + \underbrace{\lambda R(w)}{\text{正则化项:限制复杂度}}$$
前一项负责「学得好」,后一项负责「别学歪」,两者相互平衡。
2. 核心直觉
- 模型参数越大,曲线越「任性」——为了穿过每一个训练点可以剧烈扭曲。正则化项就像一根缰绳:参数想变大,就必须付出损失变大的代价。
- L1 正则化:把部分参数一路推到 0——模型自动「丢弃」不重要的特征,得到稀疏模型,顺带完成了特征选择。回归任务里使用 L1 = Lasso 回归。
- L2 正则化:把所有参数整体缩小、但不压到 0——曲线变得更平滑。回归任务里使用 L2 = Ridge / 岭回归。
- $\lambda$(正则化系数)是超参数:$\lambda$ 越大缰绳越紧,模型越简单,可能欠拟合;$\lambda$ 越小约束越弱,可能过拟合。它不能被训练学习,只能手动设置或验证选择。
补充 几何直觉:把「损失最小」和「参数范围小」画在同一个坐标系里,L1 的可行域是一个菱形(角在坐标轴上),最优解容易恰好落在角点——某个参数正好为 0,产生稀疏;L2 的可行域是圆形(处处光滑),最优解一般不在轴上,所有参数都被缩小但非零。
3. 数学表达 / 公式
三种正则化的损失函数(以平方损失为基础):
L1 正则化(Lasso)——参数绝对值之和:
$$J(w) = \frac{1}{n}\sum_{i=1}^{n}\big(y_i - f(x_i; w)\big)^2 + \lambda\sum_{j}\vert w_j \vert$$
L2 正则化(Ridge)——参数平方之和:
$$J(w) = \frac{1}{n}\sum_{i=1}^{n}\big(y_i - f(x_i; w)\big)^2 + \lambda\sum_{j} w_j^2$$
ElasticNet(弹性网络)——两者按比例结合,$r$ 决定 L1 与 L2 的权重:
$$J(w) = \frac{1}{n}\sum_{i=1}^{n}\big(y_i - f(x_i; w)\big)^2 + \lambda\left(r\sum_{j}\vert w_j\vert + \frac{1-r}{2}\sum_{j} w_j^2\right)$$
为什么 L1 产生稀疏、L2 只是缩小? 先看两者对参数的「推力」(正则化项的导数):
$$\frac{\partial}{\partial w_j}\lambda\vert w_j\vert = \lambda \operatorname{sign}(w_j) \qquad \frac{\partial}{\partial w_j}\lambda w_j^2 = 2\lambda w_j$$
手算一次:取 $\lambda = 0.1$,看一个已经很小的参数 $w_j = 0.1$ 受到的推力:
- L1:$\lambda\operatorname{sign}(0.1) = 0.1$ —— 哪怕参数只剩 0.1,推力仍是整整 0.1,不随参数变小而衰减;
- L2:$2\lambda w_j = 2 \times 0.1 \times 0.1 = 0.02$ —— 推力随参数变小而变小,参数「快到 0 了」却始终差一口气。
严格地说,稀疏性的根源不是「被固定推力推过 0」:$\vert w\vert$ 在 $w = 0$ 处有一个尖角(不可导点),而这类尖角恰好是最容易成为最优解的位置——最优解倾向于直接落在坐标轴上,对应的系数就精确等于 0。普通梯度下降处理不了这个尖角,实际求解 L1 用的是坐标下降配合「软阈值」操作,能把系数精确压成 0(sklearn 的 Lasso 正是坐标下降)。
一句话总结:L2 的推力正比于参数、越接近 0 越温柔,所以只是收缩;L1 推力恒定、且在 0 处有尖角,最优解容易「站上坐标轴」,于是产生精确的零系数。记住「L1 → 稀疏、L2 → 收缩」的直觉即可,数学机制是尖角 + 坐标下降的软阈值,而不是「一步推过 0」。
4. 模型是怎么训练出来的?
训练流程本身不变——还是求解一个最优化问题,只是目标函数换成了结构风险:
- 定义带正则化项的损失函数(选 L1 / L2 / ElasticNet,定 $\lambda$);
- 用求解算法(梯度下降、坐标下降或解析法)最小化它;
- $\lambda$ 不参与梯度更新——它是超参数,靠验证集或交叉验证挑选。
两个求解细节:
- 岭回归有解析解。对 L2 正则化的线性回归,令梯度为零可解得:
$$w = \left(X^\top X + \lambda I\right)^{-1} X^\top y$$
对角矩阵 $\lambda I$ 像一条「山岭」抬在对角线上——这正是「岭回归」名字的由来;同时它让原本不可逆的 $X^\top X$ 变得可逆,数值上更稳定。
- L1 不可导(绝对值在 0 点是尖角),不能直接用普通梯度下降,实际用次梯度下降或坐标下降法求解(sklearn 的 Lasso 默认就是坐标下降)。
5. Python / sklearn 怎么实现?
核心 API 只有三行:Lasso(alpha=λ)、Ridge(alpha=λ)、ElasticNet(alpha=λ, l1_ratio=r)。把 20 次多项式过拟合的例子拿来对比——不使用正则化、L1、L2 各拟合一次:
1 | import numpy as np |
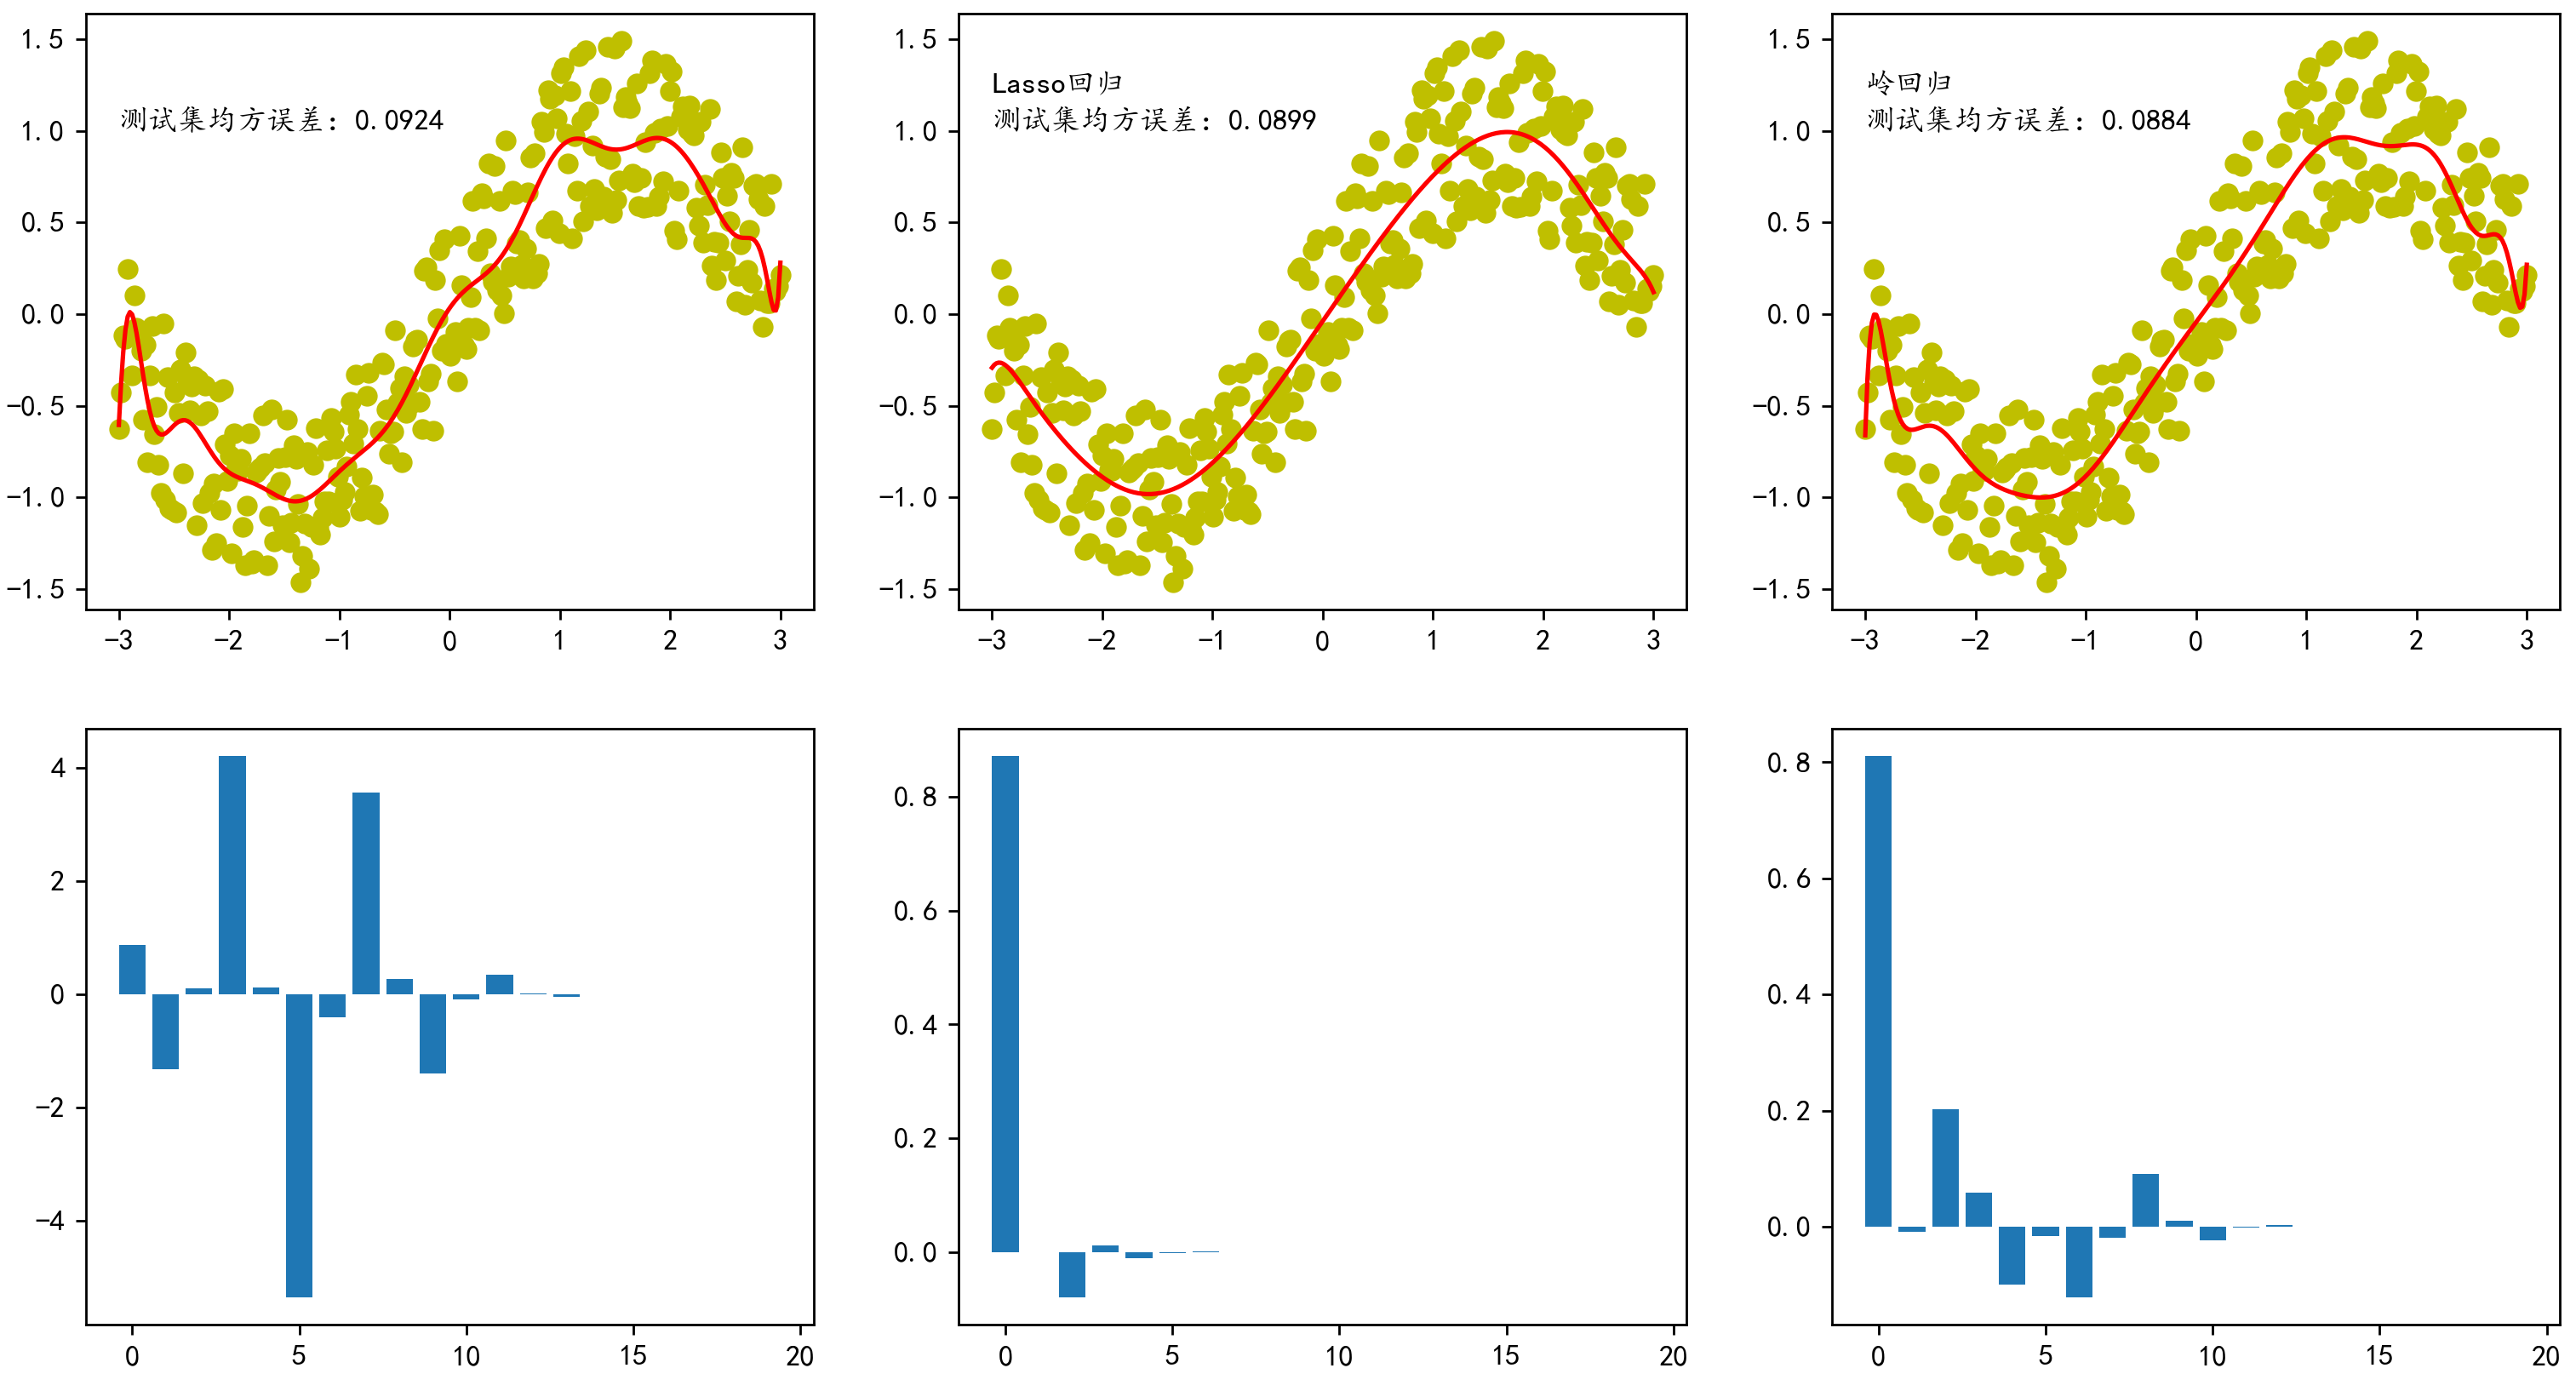
读图(对比三组系数柱状图):
- 无正则化:系数最大到 ±5,曲线在两端剧烈扭曲——典型过拟合;
- Lasso(L1):大部分系数被压成 0(只留低次项)——稀疏化,等价于自动做了特征选择;
- Ridge(L2):所有系数都被整体缩小但没有 0——曲线平滑;
- 三者的测试集 MSE(0.0924 / 0.0899 / 0.0884)都低于无正则化时的过拟合水平。
补充 训练后模型对象里保存了什么:
coef_是学到的系数(Lasso 里一部分恰好是 0,Ridge 里都不为 0 但整体变小)、intercept_是截距;而alpha是我们自己传进去的超参数,不会因训练而改变。另外 sklearn 默认不惩罚截距——截距只是把拟合线整体平移,不影响模型复杂度。
补充 $\lambda$ 不用手工试:sklearn 提供
LassoCV、RidgeCV,内部自动做交叉验证挑最优alpha。
6. 优缺点与注意事项
| L1(Lasso) | L2(Ridge) | ElasticNet | |
|---|---|---|---|
| 系数 | 部分归零(稀疏) | 整体缩小、非零 | 折中 |
| 特征选择 | ✅ 自带 | ❌ | 部分 |
| 共线特征 | 倾向随机保留其一,解不稳定 | 稳定(共线特征共享权重) | 较稳定 |
| 适用 | 特征多、想要稀疏模型 | 默认首选 | 特征多 + 特征间相关 |
补充 两条易错点:正则化前先标准化——惩罚项对所有系数一视同仁,而量纲大的特征天然系数小,不标准化会让惩罚不公平;$\lambda$ 不是越大越好——正则化压的是「无意义的扭动」,压过头就把真实规律也压没了(欠拟合)。
一句话总结:正则化 = 在「拟合数据」的得分之外,额外给「参数太大」扣分;L1 把不重要的参数扣到 0,L2 把所有参数按比例缩小。
7. 交叉验证(Cross-Validation)
1. 它解决什么问题?
评估模型需要把数据划分成训练/验证两部分,但单次划分有偶然性:划分得「巧」,分数虚高;划分得「差」,分数虚低。数据量小时,验证集更小,这种波动更严重。交叉验证通过多次轮流划分、取平均,更可靠地估计模型在未知数据上的表现,也能避免因单次划分不合理而误判模型(误判过拟合/欠拟合)。
2. 核心直觉
一句话:让每个样本都轮到自己当一次「考题」。
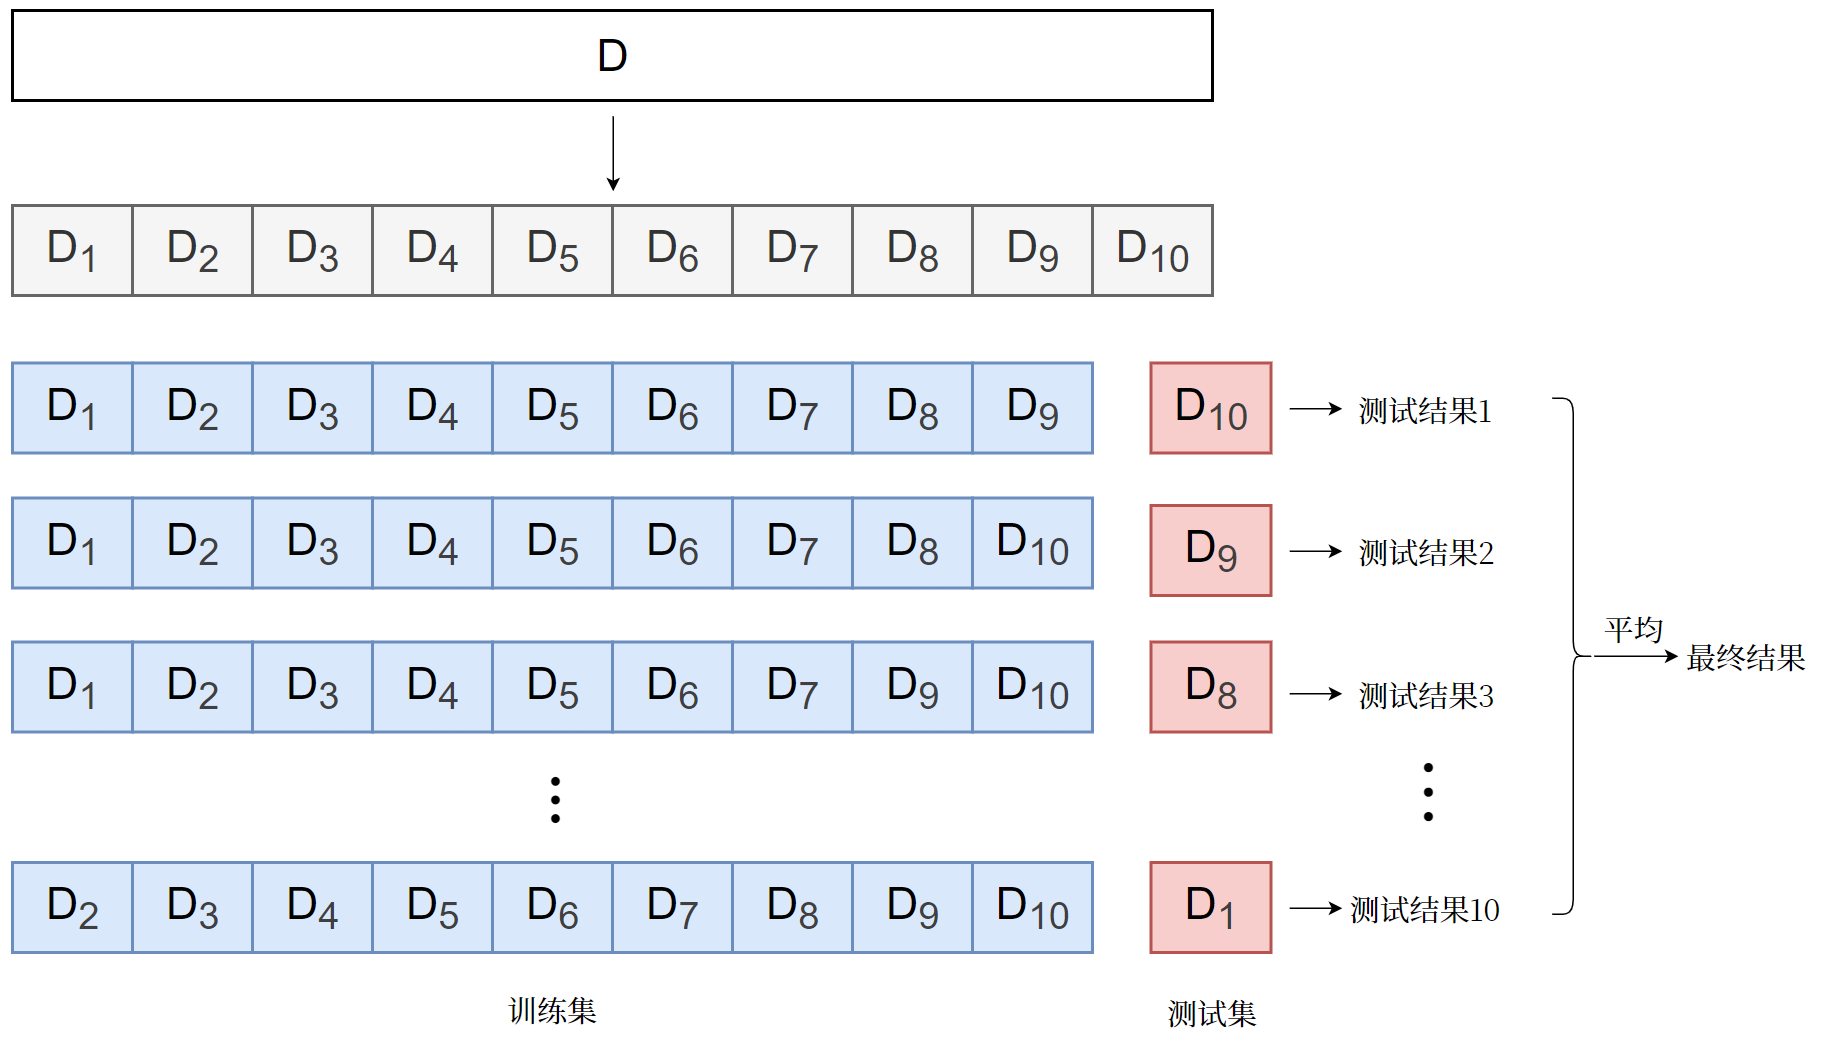
把数据分成 k 份,做 k 轮实验——每轮换一份当验证集、其余当训练集,最后把 k 轮成绩取平均。某个模型「运气好」也许在一份数据上占便宜,但很难在 k 份数据上全占便宜——平均之后,运气成分被抵消。
3. 数学表达 / 公式
把数据集 $D$ 均匀分为 k 份 $D_1, D_2, \dots, D_k$(称为 k「折」),第 i 轮用 $D_i$ 做验证、其余 k−1 折做训练,得到该轮得分 $s_i$。交叉验证的最终评估结果:
$$\text{CV score} = \frac{1}{k}\sum_{i=1}^{k} s_i$$
手算一次:5 折交叉验证,每折的准确率分别是:
$$s = [0.80,\ 0.90,\ 0.70,\ 0.85,\ 0.75]$$
$$\text{CV score} = \frac{0.80 + 0.90 + 0.70 + 0.85 + 0.75}{5} = 0.80$$
如果只做一次 Hold-Out,恰好抽到第 2 折当验证集会得到 0.90 的虚高分数,抽到第 3 折则得到 0.70 的低估。取平均之后,运气被抹平,剩下的是模型真实水平的估计。而且 0.70 ~ 0.90 的波动本身就是信息:波动大,说明模型表现对数据划分敏感、不够稳。
留一法(Leave-One-Out,LOO)是 k 折的极端形式:k = n(n 为样本数),每次只留 1 个样本验证。它的特点是:每轮训练几乎用上全部样本,估计的偏差通常较小;但 n 轮的训练集高度重叠,估计的方差可能反而偏大,加上要训练 n 个模型、计算成本极高——LOO 是「训练数据利用率极高的极端 k 折」,并不是普遍意义上「最可靠」的方案。
4. 模型是怎么训练出来的?
一个容易误解的点:交叉验证本身训练不出最终模型。
- 每一轮都用该轮的 k−1 折数据从头训练一个全新模型(模型之间互不相干,没有权重继承);
- 这 k 个「临时模型」的唯一使命是报分数,用完即弃;
- 交叉验证的产出是对「这套配置」(算法 + 超参数)的可靠评估,用于比较和选型;
- 选定配置后,再用全部训练数据重新训练一次,得到最终模型;测试集只在最后碰一次。
5. Python / sklearn 怎么实现?
最常用的是 cross_val_score(一行完成 k 折训练 + 评估):
1 | from sklearn.datasets import make_classification |
cross_val_score(model, X, y, cv=5) 内部:
1 | 把数据均匀切成 5 折 |
三个关键点:每一轮都是 clone 出的全新模型,参数从零开始、互不继承;返回的是每折的分数而不是模型;它不返回任何可用的最终模型——最终模型要用全部训练数据重新 fit。
补充 网格搜索(GridSearchCV)把「遍历超参数组合」作为外层循环、「交叉验证」作为内层评估,是超参数调优的标准姿势:每个候选参数都得到一个可靠的平均分,选最好的那个。
6. 三种方式对比与注意事项
| 方式 | 做法 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 简单交叉验证(Hold-Out) | 一次性划分(如 70% / 30%) | 快、简单 | 受单次划分影响大 | 数据量大、快速实验 |
| k 折交叉验证 | k 轮轮流验证取平均 | 充分利用数据、结果稳定 | 计算量 ×k | 最常用,k 常取 5 或 10 |
| 留一法(LOO) | 每次只留 1 个样本 | 数据利用率高、偏差小 | 各折高度重叠、方差可能偏大;训练 n 个模型 | 很小的数据集 |
补充 三条实践要点:
- 分类任务用分层 k 折(
StratifiedKFold):每折的正负样本比例与整体一致,避免某折恰好几乎没有正类。- k 的选择是「可靠性与计算量」的权衡:k 越大训练次数越多、每折训练集越大,结果越稳但越慢;5 和 10 是经验默认值。
- 防泄漏:标准化、特征选择等「学统计量」的操作必须发生在每一折的训练部分内部(sklearn 用
Pipeline把预处理和模型打包后交给cross_val_score,可自动保证这一点)。- 分组数据用 GroupKFold:同一个用户/患者/设备的多条样本不能被拆进训练折和验证折两侧,否则模型可能只是在「认出这个人」——按组切分保证同组样本只出现在一侧(分层版有
StratifiedGroupKFold)。- 时间序列不能随机打乱切折:预测未来必须「用过去训练、在未来上验证」,用
TimeSeriesSplit按时间顺序切分。- 数据少又想「调参 + 报告泛化性能」时用嵌套交叉验证:外层 CV 只负责最终评估、内层 CV 只负责调参——两层各司其职,避免调参反复看同一批验证数据带来的乐观偏差。
一句话总结:交叉验证 = 让每个样本轮流当一次考题、k 次成绩取平均,用计算量换一个不被运气左右的评估结果。
8. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 损失函数 vs 经验误差 vs 泛化误差 | 损失针对单个样本;经验误差是训练集平均;泛化(测试)误差是测试集平均,才是我们真正关心的 |
| 欠拟合 vs 过拟合 | 前者训练/测试都差(高偏差);后者训练好测试差(高方差) |
| L1 vs L2 | L1 推参数归零 → 稀疏 + 特征选择;L2 整体缩小 → 平滑稳定,默认首选 |
| ERM vs SRM | ERM 只最小化经验风险;SRM = 经验风险 + 正则化项,在拟合与复杂度间折中 |
| 交叉验证 vs 直接留测试集调参 | 调参决策只能用验证数据;测试集只许最后碰一次,否则评估虚高 |
| 早停 vs 正则化 | 都是抗过拟合手段:早停限制「训练时长」,正则化限制「参数大小」 |