模型求解与评价指标
这一篇回答两个问题(原文档标注【重点】):
- 最优模型怎么找出来?——解析法、梯度下降、牛顿法(求解算法)
- 找出来的模型怎么打分?——回归指标 MAE/MSE/RMSE/R²,分类指标混淆矩阵、Accuracy/Precision/Recall/F1、ROC/AUC(性能度量)
第一部分:模型是怎么求解出来的
1. 求解到底在解什么问题?
30 秒先懂
训练模型 = 让「损失函数(含正则化项)」取得最小值。这是一个以参数为未知数的最优化问题,求解路线有两条:解析法(解方程一步到位)和迭代法(下山,一步步逼近)。
为什么需要两条路线?解析法虽好,但要求目标函数可导、且导数方程能解出公式——条件很苛刻。损失函数一旦变复杂、特征维度一高,公式解就不存在或算不动了,这时候只能迭代。
2. 解析法
适用条件与优缺点
- 适用条件:目标函数可导,且导数方程存在解析解;
- 优点:直接、精确、计算高效——一步得到全局最优;
- 缺点:条件苛刻;特征维度大时矩阵求逆的复杂度极高。
手算一次:一元线性回归的最小二乘解
一元线性回归的损失函数是平方损失:
$$J(w, b) = \sum_{i=1}^{n}\big(y_i - (w x_i + b)\big)^2$$
分别对 $w$、$b$ 求偏导、令偏导等于 0,解方程组,得到:
$$w = \frac{\sum_{i}(x_i-\bar{x})(y_i-\bar{y})}{\sum_{i}(x_i-\bar{x})^2} \qquad b = \bar{y} - w\bar{x}$$
手算一次:取 3 个点 $x=[1,2,3]$、$y=[2,4,6]$:
- 均值:$\bar{x}=2$,$\bar{y}=4$;偏差 $dx=[-1,0,1]$,$dy=[-2,0,2]$
- $w = \dfrac{(-1)(-2)+0+ (1)(2)}{1+0+1} = \dfrac{4}{2} = 2$
- $b = 4 - 2\times2 = 0$
得到 $\hat{y} = 2x$——数据本来就在这条线上,解析解一步命中。换成真实的 10 个「学习时长 → 成绩」样本,同一公式算出 $w \approx 2.87$、$b \approx 41.45$,即「每多学 1 小时约提 2.9 分」。
多元版:正规方程
把样本堆成矩阵($X$ 里加一列全 1 与截距相乘),解析解可以写成矩阵形式,即正规方程:
$$w = \left(X^\top X\right)^{-1} X^\top y$$
带 L2 正则化时(岭回归)只是在对角线上加一个 $\lambda I$:
$$w = \left(X^\top X + \lambda I\right)^{-1} X^\top y$$
补充 两点:① 正规方程的软肋在 $\left(X^\top X\right)^{-1}$ 这一步——求逆的复杂度约为特征维数的三次方,10 个特征毫无压力、1 万个特征就算不动了,且 $X^\top X$ 还可能不可逆,这时候就该迭代法登场;② 区分「数学推导」与「数值实现」:教材的闭式解写作 $(X^\top X)^{-1}X^\top y$,但实际数值计算不会真的去构造逆矩阵——sklearn 的
LinearRegression求解的是同一个最小二乘问题,底层用基于 SVD/QR 的最小二乘求解器,数值上远比显式求逆稳定。
3. 梯度下降法(Gradient Descent)
1. 它解决什么问题?
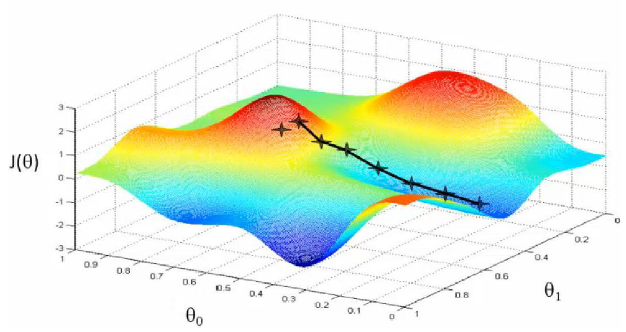
损失函数太复杂、参数维度太高、解析解不存在或算不起——梯度下降用「迭代」代替「解方程」:先随机取一组参数,然后沿着让损失下降最快的方向一小步一小步更新,直到走到(局部)最低点。 它是求解无约束优化问题最简单、最经典的方法。
2. 核心直觉
想象蒙着眼睛在山上找最低谷:
- 你看不见全局,但能感觉出脚下的坡往哪边最陡;
- 每次沿最陡的下坡方向迈一小步,反复如此,总能走到某个谷底。
术语对应:
- 梯度方向 = 函数值上升最快的方向(最陡上坡);
- 负梯度方向 = 函数值下降最快的方向(最陡下坡);
- 学习率 $\eta$ = 每一步迈多大。
3. 数学表达 / 公式
参数更新公式(讲超参数时露过一面的那个式子,现在正式认识一遍):
$$w_{new} = w_{old} - \eta \frac{\partial J}{\partial w}$$
| 符号 | 含义 |
|---|---|
| $J(w)$ | 目标函数(损失 + 正则化项),参数的函数 |
| $\dfrac{\partial J}{\partial w}$ | 梯度:当前点上坡最陡的方向和陡峭程度 |
| $\eta$ | 学习率(超参数):每步走多远 |
| $w_{new},\ w_{old}$ | 更新后 / 更新前的参数 |
手算一次。目标函数 $J(x) = (x^2 - 2)^2$,它的最小值在 $x = \sqrt{2} \approx 1.4142$ 处($J=0$)。梯度:
$$J’(x) = 4x(x^2-2)$$
取初始值 $x=1$、学习率 $\eta=0.1$,代入 $x_{new} = x - 0.1 \times J’(x)$:
| 轮次 | $x$ | $J(x)$ | $J’(x)$ | 更新 |
|---|---|---|---|---|
| 0 | 1.0000 | 1.0000 | $-4$ | $x = 1 - 0.1\times(-4) = 1.4$ |
| 1 | 1.4000 | 0.0016 | $-0.224$ | $x = 1.4 + 0.0224 = 1.4224$ |
| 2 | 1.4224 | 0.00054 | $+0.132$ | $x = 1.4224 - 0.0132 = 1.4092$ |
| 3 | 1.4092 | 0.00020 | $-0.080$ | $x = 1.4092 + 0.0080 = 1.4172$ |
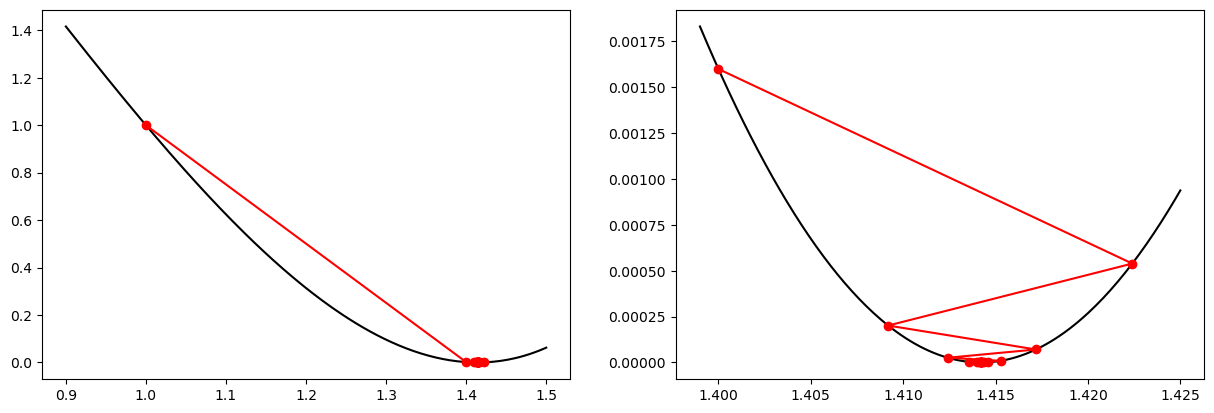
$J$ 从 1 一路跌到万分之二,$x$ 在谷底附近小幅震荡着逼近 $1.4142$——注意「震荡」:因为步长是固定的,越到谷底越容易迈过头,但幅度越来越小。
4. 模型是怎么训练出来的?
梯度下降的完整循环只有四步:
1 | 1. 初始化参数(随机给一组初值) |
停止条件通常是三选一:梯度接近零、达到最大迭代次数、损失值的变化量小于容差 tol。
学习率 $\eta$ 怎么选(超参数,只能试):
- 过大:一步跨过最优解。就用上面的例子,把 $\eta$ 从 0.1 改成 1——第一步 $x$ 直接从 1 跳到 5,损失从 1 暴涨到 529,越走越远(发散);
- 过小:收敛极慢,几万轮还没走到;
- 经验:从 0.01 / 0.1 量级开始试,或交给自适应优化器(Adam、Adagrad 会自动调整步长)。
5. Python / sklearn 怎么实现?
不借助任何库,十几行就能看到梯度下降完整跑起来:
1 | def J(x): |
运行打印的 $x$ 序列正是手算表里那串数字,最终稳定在 $\sqrt{2}$ 附近;把它画出来就是一条在谷底两侧来回衰减的轨迹:
实际训练模型时不手写循环,直接用 SGDRegressor(用随机梯度下降解回归):
1 | from sklearn.linear_model import SGDRegressor |
6. 三种变体与常见问题
梯度 = 用数据算出来的。一轮更新用多少数据,衍生出三种变体:
| 变体 | 每次更新用多少数据 | 优点 | 缺点 |
|---|---|---|---|
| 批量梯度下降 BGD | 全部训练数据 | 方向准,稳定收敛 | 数据一大,一步更新贵到算不动 |
| 随机梯度下降 SGD | 随机 1 个样本 | 快,适合大规模数据 | 方向噪声大、震荡剧烈,可能难收敛 |
| 小批量梯度下降 MBGD | 一小批(如 32、64 个) | 稳定与速度的平衡 | —— |
MBGD 是深度学习时代的事实标准,「batch size = 32/64」说的就是它。
两个常见坑:
- 局部极小值与鞍点:负梯度只保证「往低走」,不保证走到全局最低——可能困在半山腰的小坑(局部最优)或坡度全零的鞍点。缓解:动量(Momentum)、Adam 等优化器、多次随机初始化。
- 特征尺度不一时收敛慢:某特征 0
1、另一特征 010000,损失面的等高线是又扁又斜的椭圆,梯度方向来回弹锯齿。这就是做模型前要标准化/归一化的另一个原因。
4. 牛顿法与拟牛顿法(了解)
30 秒先懂
梯度下降只用一阶信息(坡往哪边斜),牛顿法再用上二阶信息(坡度本身变化多快,即曲率),于是每一步该迈多大可以直接算出来——收敛快得多,但每一步也贵得多。
更新公式:
$$w_{new} = w_{old} - H^{-1} \nabla J(w)$$
其中 $H$ 是黑塞矩阵(二阶偏导组成的矩阵),$H^{-1}$ 相当于「按曲率自动缩放过的步长」。
手算对比:还是求 $x^2 = 2$。牛顿法解方程 $f(x)=x^2-2=0$ 的迭代式是 $x_{new} = x - \dfrac{f(x)}{f’(x)}$:
| 轮次 | $x$ |
|---|---|
| 0 | 1 |
| 1 | $1 - \dfrac{-1}{2} = 1.5$ |
| 2 | $1.5 - \dfrac{0.25}{3} \approx 1.41667$ |
| 3 | $\approx 1.414216$ |
3 轮就精确到小数点后 6 位($\sqrt2 = 1.414214$),而梯度下降 3 轮还在 1.41 附近震荡——这就是二阶信息的威力。
代价:$H$ 是 $d \times d$ 矩阵,参数一多,存储和求逆都吃不消,还可能发散。拟牛顿法用一个正定矩阵近似 $H^{-1}$(代表算法 BFGS / L-BFGS),省掉黑塞矩阵。两者一般用于中小规模的凸优化问题;sklearn 里逻辑回归默认的求解器 lbfgs 就是拟牛顿法。
一句话总结:解析法是「解方程」,梯度下降是「一阶迭代,慢而通用」,牛顿法是「二阶迭代,快而昂贵」。
第二部分:模型评价指标
指标是给模型打分的尺子。同一组预测,用不同的尺子量,结论可能完全不同——所以先弄清每把尺子量的是什么,再谈公式。
5. 回归模型评价指标
一把尺子为什么不够?因为「误差」可以关心不同侧面:平均偏多少?大误差罚不罚重?误差用什么单位?比「无脑猜平均」好多少?四个指标正好回答四个问题。
本节全部用同一组预测做手算:
$$y_{true} = [3,\ 5,\ 2] \qquad y_{pred} = [2,\ 5,\ 4] \qquad 误差 = [1,\ 0,\ -2]$$
5.1 MAE 平均绝对误差(Mean Absolute Error)
$$MAE = \frac{1}{n}\sum_{i=1}^{n}\vert y_i - \hat{y}_i \vert = \frac{1+0+2}{3} = 1$$
直觉:平均每个预测偏了 1(和目标值同单位,解释最直观)。绝对值不放大误差,因此对异常值不敏感——适合数据里有异常值的场景。
5.2 MSE 均方误差(Mean Squared Error)
$$MSE = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2 = \frac{1+0+4}{3} \approx 1.67$$
直觉:先平方再平均。偏 2 的样本被平方成 4,一个「大错」抵得上四个「小错」——对大误差和异常值敏感。平方让它处处可导、且是凸函数(只有一个全局最低点),解析法和梯度下降都好使,因此它是回归默认的损失函数。
5.3 RMSE 均方根误差(Root Mean Squared Error)
$$RMSE = \sqrt{MSE} = \sqrt{1.67} \approx 1.29$$
直觉:就是给 MSE 开个根号,让量纲回到目标值本身——「平均偏了约 1.29」,可以直接和原始数据对话。注意(原文档提醒):一味追求降 RMSE,模型会拼命迁就异常值,反而容易过拟合。
5.4 R² 决定系数
$$R^2 = 1 - \frac{\sum_{i}(y_i - \hat{y}i)^2}{\sum{i}(y_i - \bar{y})^2}$$
| 符号 | 含义 |
|---|---|
| 分子 | 模型残差的平方和(模型犯的总错) |
| 分母 | 「永远预测均值 $\bar{y}$」这个无脑基线犯的总错 |
直觉一句话:R² 回答「你比无脑猜平均值好多少」。
手算一次:$\bar{y} = 10/3 \approx 3.33$;分子 $= 1+0+4 = 5$;分母 $= (3-3.33)^2+(5-3.33)^2+(2-3.33)^2 \approx 0.11+2.78+1.78 = 4.67$:
$$R^2 = 1 - \frac{5}{4.67} \approx -0.07$$
负数! 含义很残酷:这组预测比「永远猜平均值」还要差一点。R² 是唯一会给出负分的常用指标——它拿你和最笨的基线比。换一组好一点的预测 $\hat{y}=[2,6,2]$(分子降为 2),$R^2 = 1 - 2/4.67 \approx 0.57$,即「解释了约 57% 的差异」。
| R² 取值 | 含义 |
|---|---|
| 接近 1 | 解释能力强,模型远好于均值基线 |
| 0 左右 | 和「永远猜均值」没区别 |
| 负数 | 比无脑猜均值还烂 |
5.5 怎么选
| 场景 | 推荐 |
|---|---|
| 常规训练(当损失函数用) | MSE(可导、好优化) |
| 数据里有异常值 | MAE(不被极端值带偏) |
| 要向业务解释「平均偏多少」 | RMSE / MAE(量纲一致) |
| 想知道「比基线好多少」 | R² |
补充 实践中常多个指标一起看:MSE 说明优化目标、RMSE 说明误差量级、R² 说明相对水平,互相不冲突。
6. 分类模型评价指标
先把整套指标体系挂在一棵树上——分类模型输出的通常是一个概率,从概率到「分数」有三条不同的评价路线:
1 | 分类指标 |
同一个模型这三种分数完全可以一好一坏:排序很强但概率虚高、准确率高但正类全漏。评价前先想清楚「我要评的是哪一层」,再挑指标。
6.1 混淆矩阵:一切分类指标的源头
为什么需要它? 先看准确率(Accuracy)怎么骗人:1000 人体检,990 个健康、10 个患病。模型无脑输出「全部健康」,准确率高达 **99%**——但一个病人都没抓到,这个模型一文不值。问题出在:Accuracy 把「四种对错」揉成了一个数。混淆矩阵把这四种情况摊开:
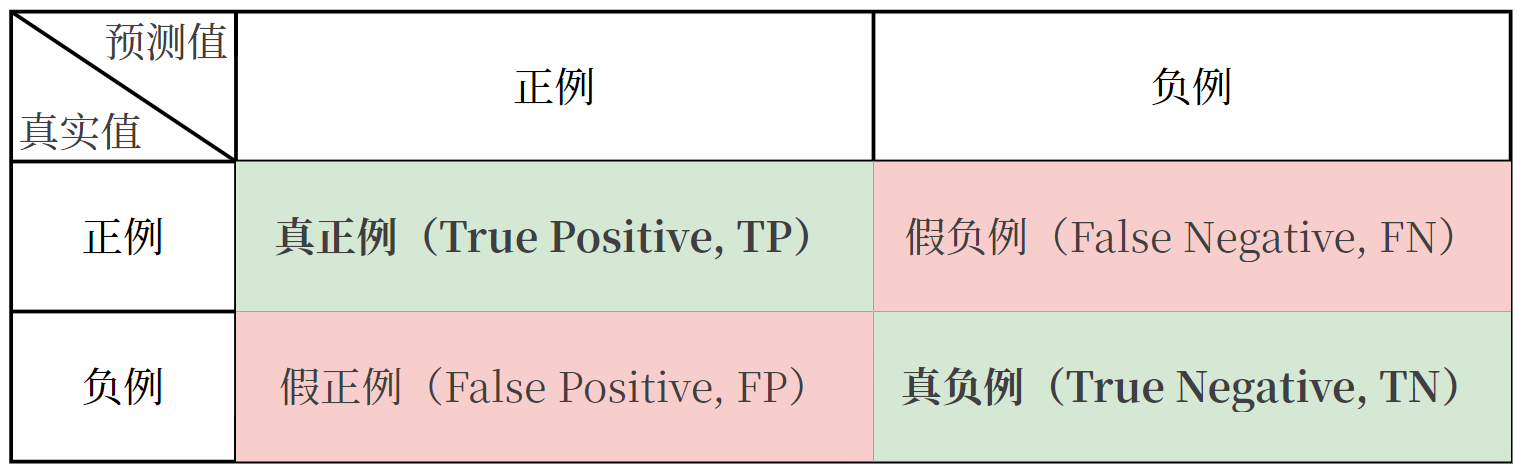
四个格子的记法:第二个字母(P/N)是模型说的,第一个字母(T/F)是模型说得对不对:
- TP 真正例:真是正例,也判成了正例(判对);
- FN 假负例:真是正例,却判成了负例(漏报,判错);
- FP 假正例:真是负例,却判成了正例(误报,判错);
- TN 真负例:真是负例,也判成了负例(判对)。
一个例子贯穿本节:10 个样本,6 只猫、4 只狗;以猫为正例。模型判对了 5 只猫、2 只狗:
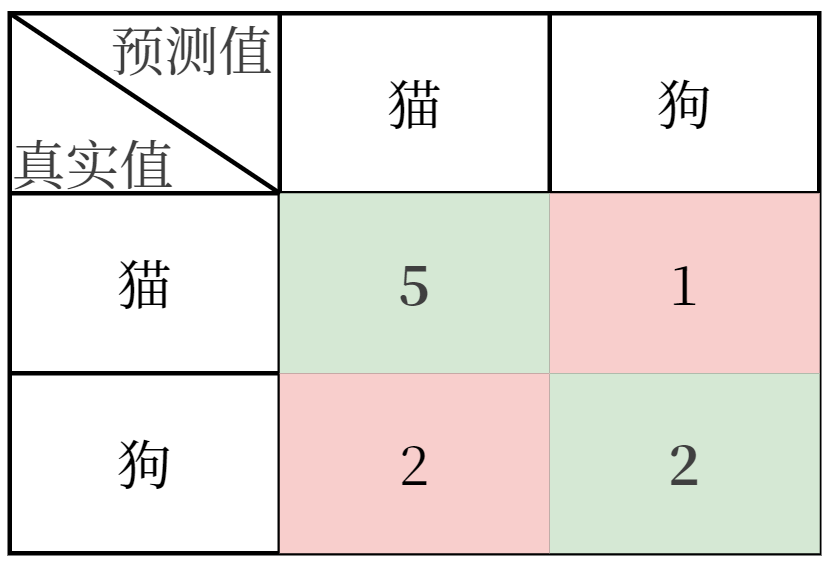
即 TP=5(真猫判成猫)、FN=1(真猫判成狗)、FP=2(真狗判成猫)、TN=2(真狗判成狗)。
1 | from sklearn.metrics import confusion_matrix |
6.2 Accuracy / Precision / Recall / F1
Accuracy 准确率——整体判对的比例:
$$Accuracy = \frac{TP + TN}{TP + TN + FP + FN} = \frac{5+2}{10} = 0.7$$
直觉简单,但回到体检那个例子就失效:正负样本越不平衡,它越接近「无脑报多数类」的分数。
Precision 精确率(查准率)——模型喊「正」的时候,有多少把握:
$$Precision = \frac{TP}{TP + FP} = \frac{5}{5+2} \approx 0.714$$
手算含义:模型一共判了 7 个「猫」(TP+FP),其中真猫只有 5 个——每 7 次喊「猫」约有 5 次是真的。关注的是「误报」的代价。
Recall 召回率(查全率)——真正的正例,被抓住了多少:
$$Recall = \frac{TP}{TP + FN} = \frac{5}{5+1} \approx 0.833$$
手算含义:真猫共 6 只(TP+FN),抓到 5 只——6 只真猫抓住了 5 只。关注的是「漏报」的代价。
Precision 和 Recall 是一对跷跷板:判正的门槛调高(更谨慎),误报少了 Precision 升,但漏掉的也多了 Recall 降;门槛调低则反过来。按业务代价选边:
| 场景 | 更在乎 | 原因 |
|---|---|---|
| 病症筛查 | Recall | 漏诊(FN)可能致命,误报只是多做一次检查 |
| 垃圾邮件拦截 | Precision | 误删正常邮件(FP)代价高,漏一封垃圾邮件无所谓 |
| 风控拦截欺诈 | 视情况 | 误冻正常账户 vs 放过欺诈,看哪个更贵 |
F1 分数——把两者按调和平均绑成一个数:
$$F1 = \frac{2 \times Precision \times Recall}{Precision + Recall} = \frac{2 \times \frac{5}{7} \times \frac{5}{6}}{\frac{5}{7} + \frac{5}{6}} = \frac{50/42}{65/42} = \frac{10}{13} \approx 0.769$$
为什么用调和平均不用算术平均? 手算一次就明白:若 $Precision=1$、$Recall=0$,算术平均 = 0.5(看起来还行),调和平均 = 0(暴露偏科)——调和平均会重罚「一条腿走路」的模型。
1 | from sklearn.metrics import classification_report |
6.3 ROC 曲线与 AUC
为什么还需要它们? 上面的指标都有一个隐藏前提:先用某个阈值(通常是 0.5)把模型输出的概率切成类别,再数格子。可阈值一换,所有指标跟着变——阈值 0.3 时 Recall 0.95 但 Precision 0.4,阈值 0.8 时反过来。有没有一个与阈值无关、衡量模型排序能力的指标? 这就是 ROC 和 AUC。
先认识两个量:
$$TPR = \frac{TP}{TP+FN} \qquad FPR = \frac{FP}{FP+TN}$$
- TPR 真正例率:真正例中被抓到的比例——其实就是 Recall;
- FPR 假正例率:真负例中被误伤的比例——分母是全部真负例,和 Precision(分母是「预测为正」)完全不同,别混。
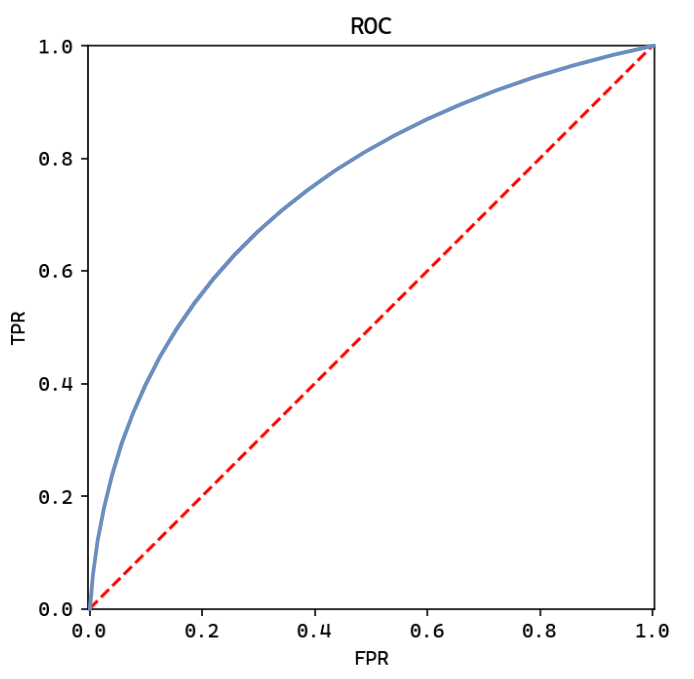
ROC 曲线的画法:让阈值从高到低扫一遍(比如从 1 扫到 0),每个阈值算出一对 (FPR, TPR),画成点连成线。直觉:阈值最高时什么都不判正,落在 (0,0);阈值最低时全判正,落在 (1,1);曲线越靠左上角鼓,说明低误报下也能高召回——模型好;贴着对角线 = 等于抛硬币。
手算一次:8 个样本,模型给每个的「为正的打分」从高到低排列:
| 样本 | 真实标签 | 打分 |
|---|---|---|
| A | 1 | 0.9 |
| B | 1 | 0.8 |
| C | 0 | 0.7 |
| D | 1 | 0.6 |
| E | 0 | 0.5 |
| F | 0 | 0.4 |
| G | 1 | 0.3 |
| H | 0 | 0.2 |
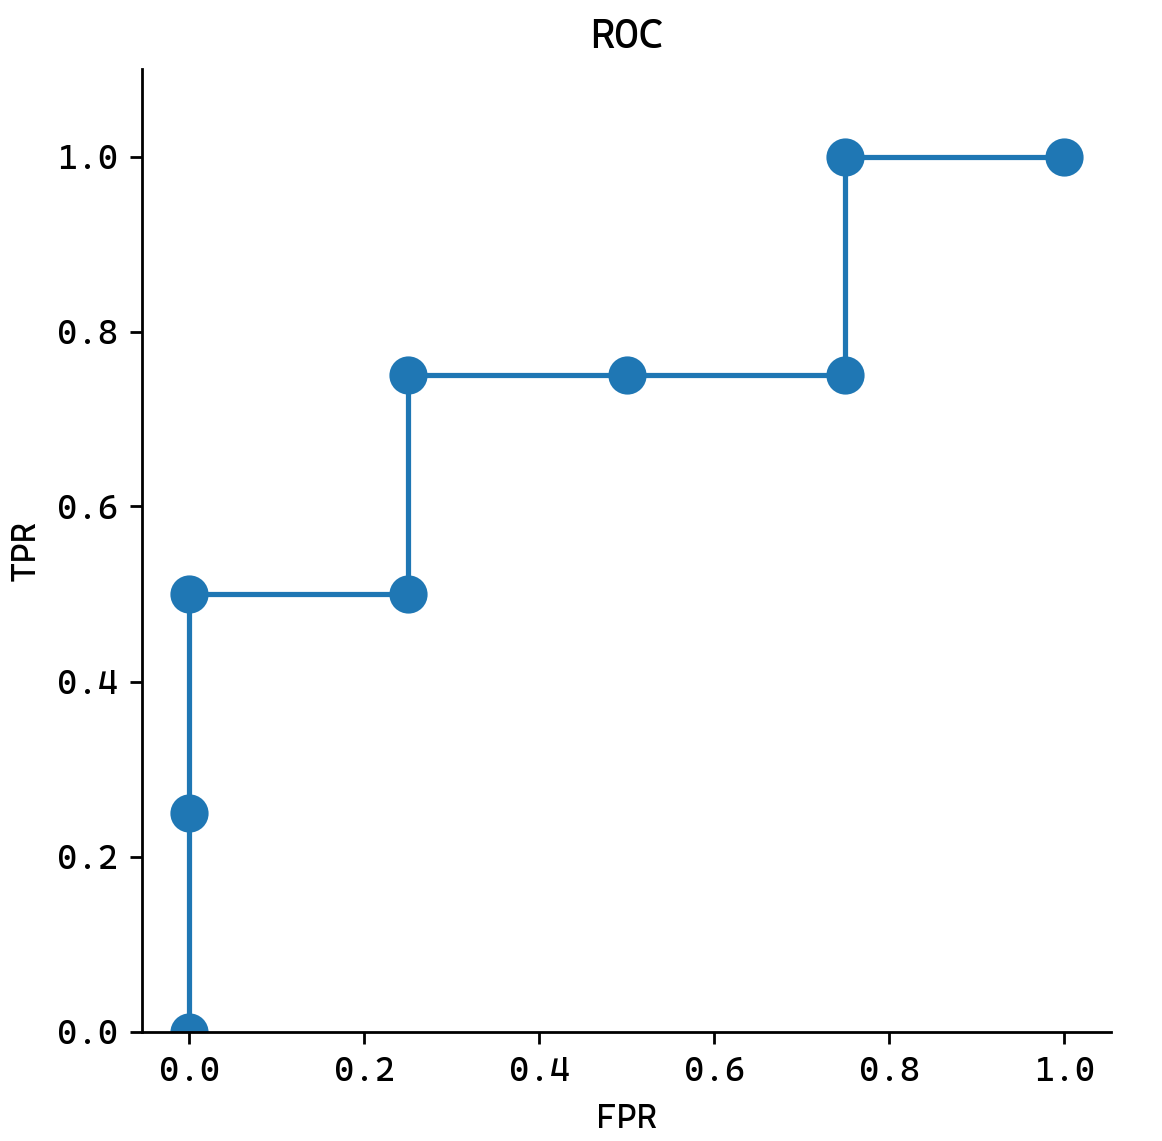
共 4 正 4 负。让阈值从 0.9 逐步降到 0.2(打分 ≥ 阈值判为正):
| 阈值 | 判为正的样本 | TP | FP | TPR | FPR | 坐标点 |
|---|---|---|---|---|---|---|
| 0.9 | A | 1 | 0 | 0.25 | 0 | (0, 0.25) |
| 0.8 | A,B | 2 | 0 | 0.50 | 0 | (0, 0.50) |
| 0.7 | A,B,C | 2 | 1 | 0.50 | 0.25 | (0.25, 0.50) |
| 0.6 | A,B,C,D | 3 | 1 | 0.75 | 0.25 | (0.25, 0.75) |
| 0.5 | +E | 3 | 2 | 0.75 | 0.50 | (0.50, 0.75) |
| 0.4 | +F | 3 | 3 | 0.75 | 0.75 | (0.75, 0.75) |
| 0.3 | +G | 4 | 3 | 1.00 | 0.75 | (0.75, 1.00) |
| 0.2 | 全部 | 4 | 4 | 1.00 | 1.00 | (1, 1) |
把这些点连起来,正是下面这张阶梯图:
AUC:ROC 曲线下的面积。手算两种方法,结果应当一致:
方法一(数格子):曲线下由四段矩形组成——
$$AUC = 0.25\times0.5 + 0.25\times0.75 + 0.25\times0.75 + 0.25\times1 = 0.75$$
方法二(配对法,更直观):随机抽一个正样本和一个负样本,正样本打分更高的概率。4 正 × 4 负 = 16 个配对,逐对检查:0.9 压过 4 个负、0.8 压过 4 个、0.6 压过 3 个(0.5/0.4/0.2)、0.3 压过 1 个(0.2)——共 12 对,$12/16 = 0.75$。两种算法完全一致。
| AUC | 含义 |
|---|---|
| 1.0 | 完美:所有正样本都排在负样本前面 |
| 0.75 | 随机抽一正一负,75% 的概率正样本得分更高 |
| 0.5 | 等价于随机猜测 |
| < 0.5 | 比随机猜还差(把预测反过来用反而更好) |
1 | from sklearn.metrics import roc_auc_score |
补充 注意
roc_auc_score的第二个参数是正例的概率/打分(predict_proba(X)[:, 1]),传成预测类别会算错。
6.4 PR 曲线与 AP:不平衡数据的另一把尺子
ROC-AUC 回答的是「随机抽一正一负,正样本排在前面吗」。但正类极稀少时(欺诈率 0.1%、患病率 1%),即便 Precision 已经很难看,ROC-AUC 仍可能显得体面——数量庞大的负类把 FPR 稀释了。这时更该看 PR 曲线:
- 横轴 Recall、纵轴 Precision——正是 6.2 节那对跷跷板;
- 画法与 ROC 类似:阈值从高到低扫一遍,每个阈值算一对 (Recall, Precision),连成线;
- 曲线越靠右上越好(高召回的同时保住高精确率);注意基线不再是 0.5 的对角线,而是「正类占比」的水平线。
AP(Average Precision,平均精度)是 PR 曲线的汇总数字,直觉一句话:
从模型认为最可能为正的样本开始往下找,在不断召回正样本的过程中,Precision 保持得有多好。
1 | from sklearn.metrics import precision_recall_curve, average_precision_score |
选择口诀:正负均衡、关心整体排序 → ROC-AUC;正类稀少、关心「抓出来的正类准不准」→ PR 曲线与 AP。
6.5 概率质量指标:概率给得准不准
predict_proba 输出的概率本身也有质量高低,常用两把尺子加一个概念:
- Log Loss(对数损失):逻辑回归的训练损失换个身份当指标——对「自信的错误」罚得极重,适合要求概率审慎的场景;
- Brier Score:$\frac{1}{n}\sum (p_i - y_i)^2$,即「概率 vs 真实标签」的均方误差,0~1 之间、越小越好,比 Log Loss 温和直观;
- 校准(Calibration):所有预测 0.8 的样本,长期看是否真有约 80% 是正类——概率要拿去做风险定价、期望收益计算,就必须先校准。
1 | from sklearn.metrics import log_loss, brier_score_loss |
6.6 多分类的平均方式
多分类下 Precision/Recall/F1 要先「每个类各算一份」再汇总——汇总方式不同,结论可能明显不同:
| 方式 | 逻辑 | 适合 |
|---|---|---|
macro |
每个类的分数简单平均 | 关心少数类(少数类与大类同权重) |
weighted |
按类别样本数加权平均 | 想反映整体、又保留类别差异 |
micro |
汇总所有 TP/FP/FN 后统一计算 | 多标签/极度偏斜场景,约等于看整体准确率 |
classification_report 输出末尾的 macro avg / weighted avg 两行就是它们——现在那份报告可以完整看懂了。
6.7 分类指标选择速查
| 场景 | 首选 |
|---|---|
| 样本均衡、粗看整体 | Accuracy |
| 样本极不平衡 | Precision / Recall / F1(别只看 Accuracy) |
| 漏报代价大(疾病筛查) | Recall |
| 误报代价大(垃圾邮件) | Precision |
| 要兼顾查准查全 | F1 |
| 比较模型整体排序能力、与阈值无关 | AUC |
7. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 解析法 vs 梯度下降 | 解方程一步到位(条件苛刻、维度大算不动)vs 迭代逼近(通用、可能局部最优) |
| 梯度方向 vs 负梯度方向 | 前者上升最快,后者下降最快——更新参数用的是负梯度 |
| 梯度下降 vs 牛顿法 | 一阶(只用坡度方向)慢而便宜;二阶(再加曲率)快而昂贵 |
| BGD / SGD / MBGD | 一次更新用全部 / 1 个 / 一小批数据;MBGD 是主流 |
| MSE vs RMSE | RMSE = √MSE,量纲与目标值一致,可以直接和原始数据对话 |
| MAE vs MSE | MSE 平方放大了大误差、对异常值敏感;MAE 一视同仁、更鲁棒 |
| R² = 0 | 不是「零分」,而是「和永远猜均值一个水平」;负数 = 比猜均值还差 |
| Precision vs Recall | 查准(喊「正」时多有把握)vs 查全(真正例抓住了多少);分母不同 |
| TPR vs FPR | 都是「占真实类的比例」:TPR 分母是全部真正例,FPR 分母是全部真负例 |
| Accuracy vs AUC | Accuracy 依赖阈值、怕不平衡;AUC 阈值无关、看排序能力 |
| ROC-AUC vs AP | 都看排序:均衡数据用 ROC-AUC;正类稀少时 AP(PR 曲线)更有解释力 |
| 混淆矩阵的行和列 | sklearn 默认行 = 真实值,列 = 预测值,读表前先确认方向 |