线性回归
30 秒先懂
线性回归:假设目标值和特征之间近似是一条直线(或高维超平面)的关系,然后找出「总体偏差最小」的那条线,用它做预测。
它是第一个正式的模型,也是把「模型 → 损失函数 → 求解算法」这套框架完整走一遍的最佳练手对象——后面所有模型,都是这套框架的变奏。
1. 它解决什么问题?
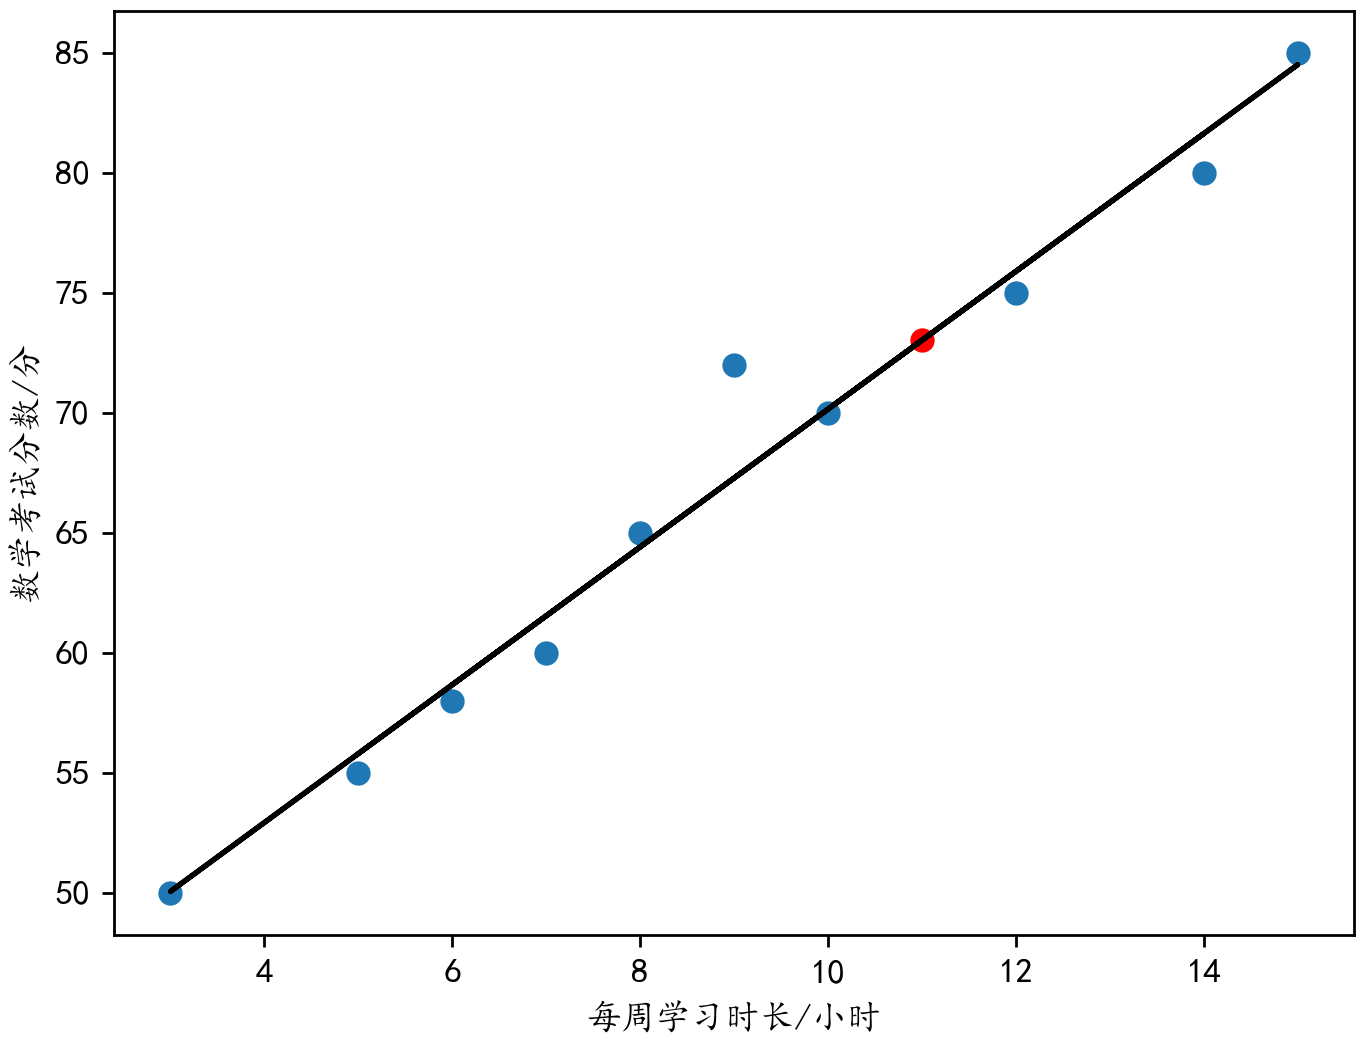
给你一群学生的「每周学习时长」和「数学成绩」,想知道:学得更久,成绩大概能提多少?某个学 11 小时的学生,成绩大概多少分?
这是回归任务:预测一个连续数值(成绩、房价、销售额)。线性回归的答案是:先用一条直线描述「时长 → 成绩」的趋势,再用直线算出任何时长的预测分。
模型的数学形式:
$$\hat{y} = w_1 x_1 + w_2 x_2 + \cdots + w_d x_d + b$$
| 符号 | 含义 |
|---|---|
| $x_1 \cdots x_d$ | $d$ 个特征(输入) |
| $w_1 \cdots w_d$ | 系数(参数):每个特征影响多大 |
| $b$ | 截距(参数):所有特征为 0 时的基准值 |
| $\hat{y}$ | 模型的预测值(带帽子表示「预测」,区别于真实 $y$) |
只有一个特征时叫一元线性回归(平面上找一条直线),多个特征叫多元线性回归(高维空间里找一个平面/超平面):
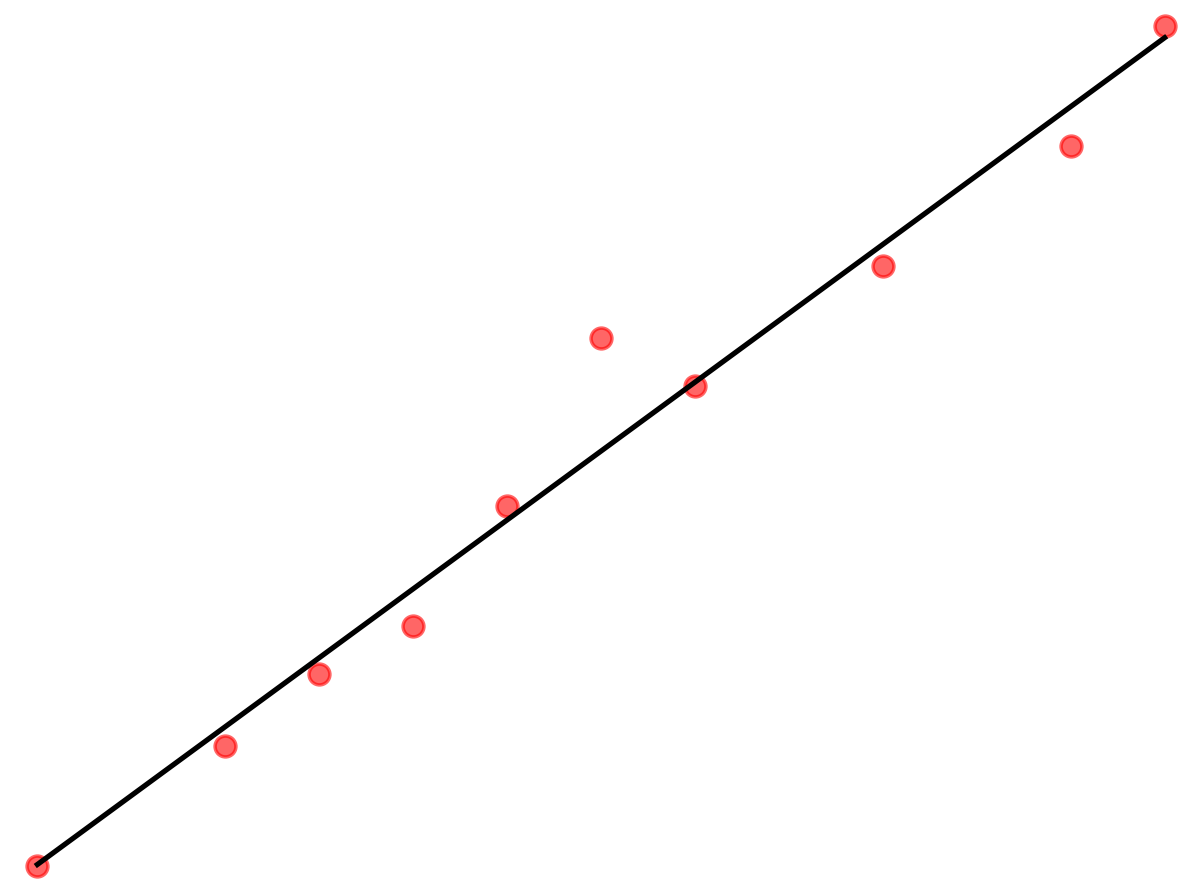
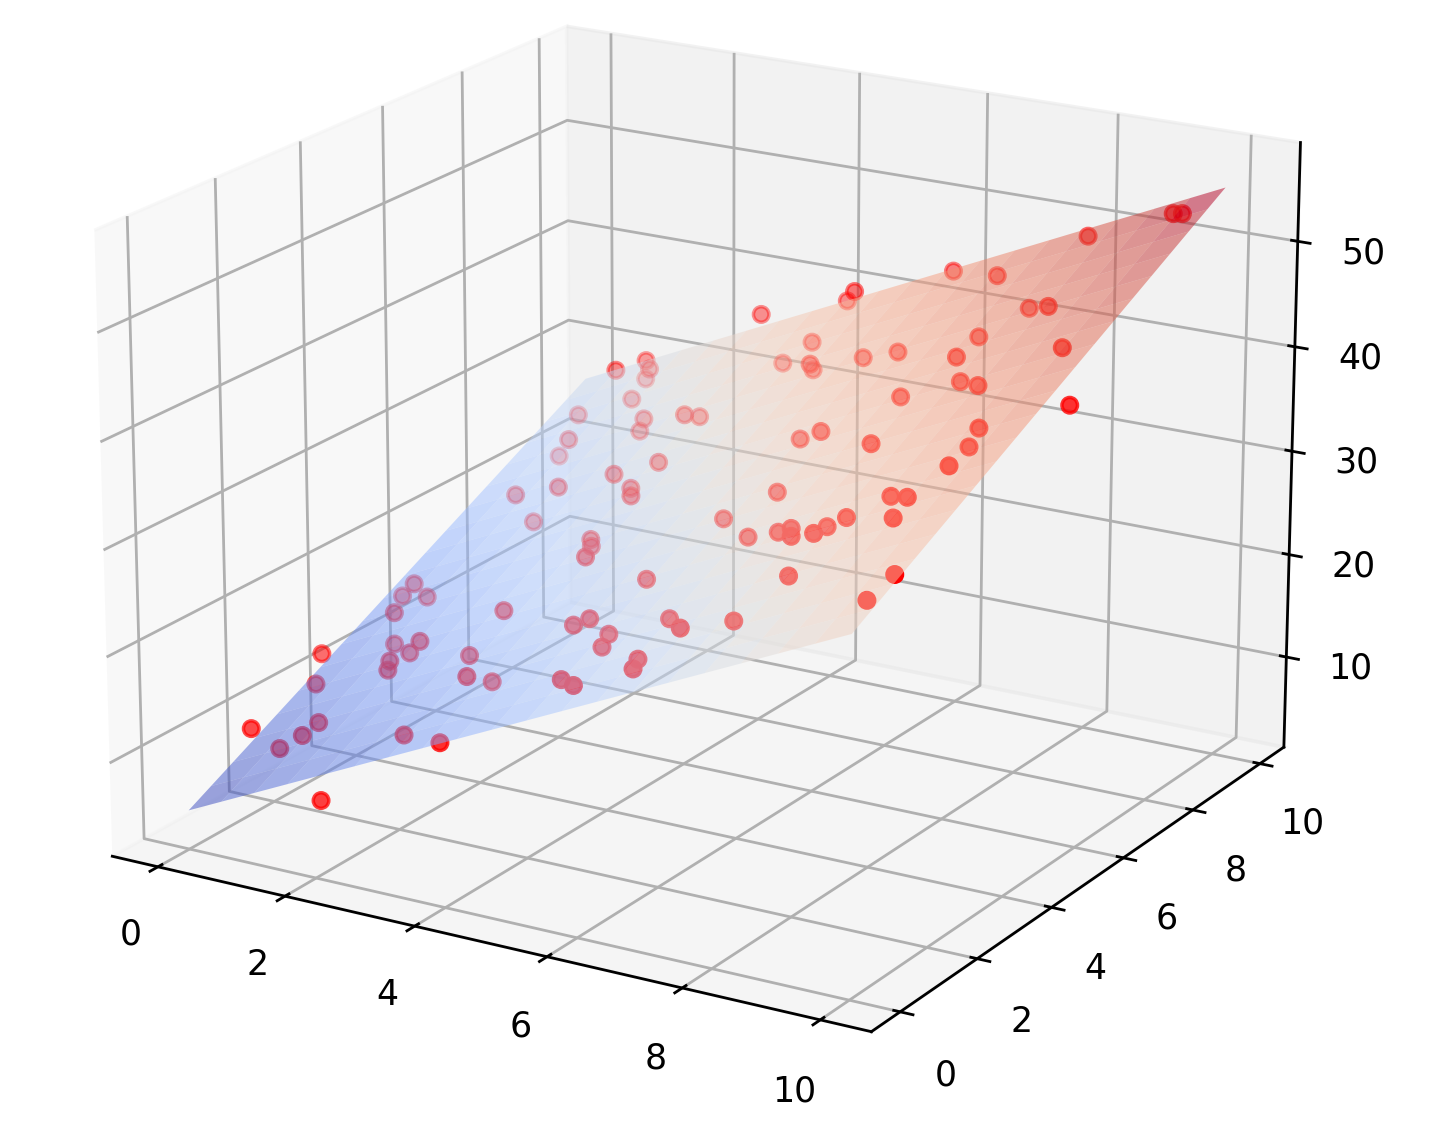
补充 「线性」的准确含义是对参数线性,不是「画出来必须是一条直线」。比如 $\hat{y} = w_1 x + w_2 x^2 + b$——它对 $x$ 是一条抛物线,但对参数 $(w_1, w_2, b)$ 仍是线性组合,所以仍属于线性模型。「多项式回归」就是给特征造平方项、交叉项后再做线性回归:曲线来自特征的变换,模型本身还是线性的。
典型应用场景:GDP 预测(投资、消费、出口 → 增速)、广告效果评估(各渠道投入 → 销售额)、药物剂量研究(剂量 → 生理指标)、产品质量控制(温度、压力 → 强度)、气候建模(排放量 → 气温)。
补充 线性回归适合「关系大体是线性的、要解释每个因素的影响」的场景。关系明显是弯曲的(比如剂量过大会中毒、效果掉头向下)时,直线描述不了,需要非线性的模型。
2. 核心直觉
直觉一:拉一根橡皮筋。 把点撒在图上,线性回归就是在点云里拉一根有弹性的直线,让它「总体上」从点群中间穿过去——不追求穿过每一个点(那是死记硬背每个样本),只追求离所有点整体最近。
直觉二:系数是旋钮。 学出 $\hat{y} = 2.87x + 41.45$ 后,模型就完全可解释:$x$(学习时长)每多 1 小时,预测成绩加 2.87 分;不学习时的基准分是 41.45。每个 $w$ 就是一个「特征旋钮」,拧多少、往哪拧,一目了然——这就是线性回归可解释性的来源。
直觉三:「最好的一条线」= 竖直偏差平方和最小。 预测线和真实点之间有一段段竖直的差距(下图红线段),叫残差——「最好」指的是让所有残差的平方和最小:
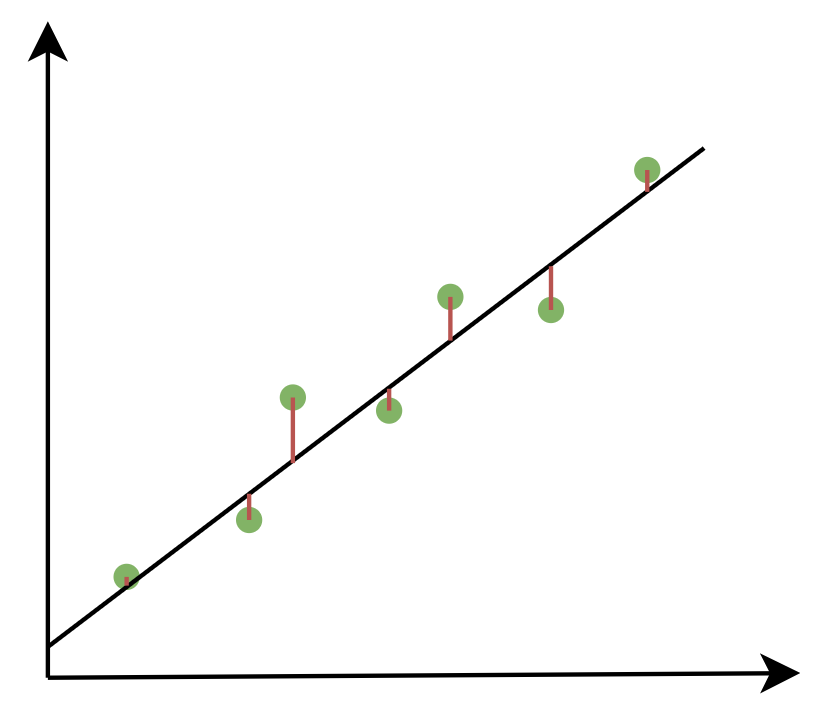
补充 为什么量「竖直距离」而不是「垂直距离」?因为我们只关心预测 y 时错了多少——x 是已知条件不算误差。竖直残差恰好是 $y_i - \hat{y}_i$,平方求和就是下一节的损失函数。
3. 数学表达 / 公式
3.1 损失函数:均方误差(MSE)
把「总体偏差最小」写成公式——对 n 个样本,损失函数取均方误差:
$$J(w, b) = \frac{1}{n}\sum_{i=1}^{n}\big(y_i - \hat{y}i\big)^2 = \frac{1}{n}\sum{i=1}^{n}\big(y_i - (w x_i + b)\big)^2$$
| 符号 | 含义 |
|---|---|
| $y_i$ | 第 $i$ 个样本的真实值 |
| $\hat{y}_i = w x_i + b$ | 第 $i$ 个样本的预测值 |
| $n$ | 样本个数 |
基于均方误差最小化来求解的方法叫最小二乘法——几何上就是「让所有样本到直线的竖直距离(欧氏距离)平方之和最小」。
为什么用平方? 三条理由:① 处处可导,方便求梯度;② 是凸函数——只有一个碗底,找到的最小值必是全局最优;③ 平方会放大离群的大误差,让模型优先修正明显的错配(代价是对异常值敏感)。若异常值太多,可以换绝对误差(MAE)当损失,只是零点不可导、求解麻烦些。
3.2 手算一次:3 个点拟一条线
最小化 $J(w,b)$ 有公式解(下节推导)。先直接用结论感受一下——最小二乘解为:
$$w = \frac{\sum_{i}(x_i-\bar{x})(y_i-\bar{y})}{\sum_{i}(x_i-\bar{x})^2} \qquad b = \bar{y} - w\bar{x}$$
取 $x=[1,2,3]$、$y=[3,5,7]$:
- 均值:$\bar{x}=2$,$\bar{y}=5$;偏差 $dx=[-1,0,1]$,$dy=[-2,0,2]$
- $w = \dfrac{(-1)(-2)+0+(1)(2)}{1+0+1} = \dfrac{4}{2} = 2$
- $b = 5 - 2\times2 = 1$
得到 $\hat{y} = 2x + 1$。代回去检验:预测值 $[3,5,7]$ 与真实值完全一致,损失 $J=0$——数据本来就在这条直线上,解析解一步命中。
3.3 为什么平方损失「名正言顺」(了解)
一个统计学上的背书:假设真实关系是 $y = wx + b + \varepsilon$,其中噪声 $\varepsilon$ 服从均值为 0 的正态分布(测量误差大多如此)。那么每个 $y_i$ 就服从以 $wx_i+b$ 为中心的正态分布,全体样本的似然函数(「这组参数下,看到手头数据的概率」)是:
$$L = \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi\sigma^2}} \exp!\left(-\frac{(y_i - f(x_i))^2}{2\sigma^2}\right)$$
取对数(连乘变连加),最大化对数似然时,唯一随 $w,b$ 变化的项是 $-\frac{1}{2\sigma^2}\sum(y_i - f(x_i))^2$——最大化它等价于最小化平方和。
结论:只要误差近似正态分布,最小二乘就是统计学意义上的最优估计(极大似然估计)。这解释了为什么平方损失是回归的默认选择,而不是随手拍的。
4. 模型是怎么训练出来的?
「训练」就是最小化 $J(w,b)$。三条路线,殊途同归(损失是凸的,最优解唯一):
4.1 路线一:解析解
对 $J(w,b)$ 分别求偏导、令导数为 0、解方程组,就得到 3.2 节用过的公式。拿贯穿全课程的真实数据走一遍——10 个「每周学习时长 → 数学成绩」样本:
- $x = [5,8,10,12,15,3,7,9,14,6]$,均值 $\bar{x}=8.9$
- $y = [55,65,70,75,85,50,60,72,80,58]$,均值 $\bar{y}=67$
- 算两个求和:$\sum dx,dy = 393.0$,$\sum dx^2 = 136.9$
- $w = 393.0 / 136.9 \approx 2.87$,$b = 67 - 2.87\times8.9 \approx 41.45$
得到 $\hat{y} = 2.87x + 41.45$:每多学 1 小时约提 2.9 分。
4.2 路线二:正规方程(矩阵版解析解)
多元时把公式写成矩阵形式。给 $X$ 补一列全 1(与截距相乘),最优参数一步算出:
$$w = \left(X^\top X\right)^{-1} X^\top y$$
前提是 $X^\top X$ 可逆(满秩)。特征不多时它又快又准;特征上万时求逆的代价约为维数的三次方,就轮到路线三。
4.3 路线三:梯度下降
解析解算不动时,用迭代逼近。先把 MSE 对参数的梯度写出来(对矩阵形式 $J = \frac{1}{n}|Xw - y|^2$ 用链式法则):
$$\nabla J = \frac{2}{n} X^\top (Xw - y)$$
直觉核对:$(Xw - y)$ 是残差向量——「预测比真实低的地方,梯度就把参数往上推」,合理。完整代码:
1 | import numpy as np |
迭代收敛后 beta 稳定在 $[41.45,\ 2.87]$——与解析解一致,互为验证。把 $(b, w)$ 平面上的损失等高线和下降轨迹画出来:
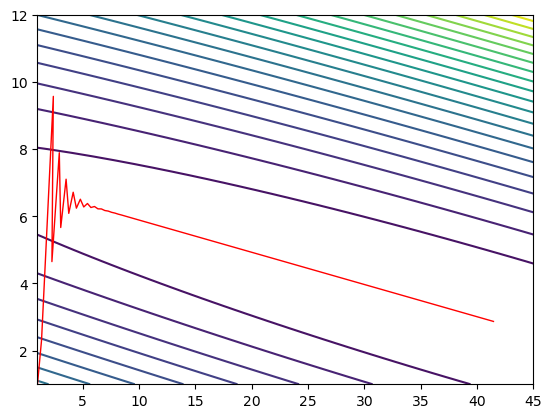
注意轨迹前期疯狂锯齿:两个特征尺度悬殊(时长 3~15,截距列恒为 1),等高线又扁又斜,负梯度方向来回横跳——这正是「训练前要做特征缩放」的直观证据。
4.4 三条路线怎么选
| 路线 | 适用 | 特点 |
|---|---|---|
| 解析解 / 正规方程 | 特征数不多(几百上千以内) | 一步到位、精确;求逆贵 |
| 梯度下降 | 特征多、数据大 | 通用可扩展;要调学习率 |
| 线性回归专属好消息 | —— | MSE 对参数是凸函数,没有局部极小的担忧;但凸性不等于「一定收敛到位」——学习率过大仍会发散、特征尺度悬殊仍会收敛极慢、停止条件太松仍会欠收敛 |
5. Python / sklearn 怎么实现?
5.1 最小例子:学习时长 → 成绩
1 | from sklearn.linear_model import LinearRegression |
predict([[11]]) 的内部只有一行算术:$2.87 \times 11 + 41.45 \approx 73.03$——下图里那个红色的点就是它:
fit / predict 内部(线性回归版):
fit(X, y):用解析解解出 $w$、$b$,存进coef_和intercept_;predict(X):取出参数,计算X @ coef_ + intercept_,参数不再变化。
注意 LinearRegression 不是转换器,没有 transform——它不改变数据,只产出参数。
5.2 想用梯度下降时
同一个模型换一个求解器而已:
1 | from sklearn.linear_model import SGDRegressor |
易错
SGDRegressor默认自带 L2 正则化(penalty="l2"),优化目标与普通最小二乘并不完全相同——想用它复现「梯度下降版 OLS」,必须显式penalty=None并先缩放特征;否则「两条路线殊途同归」的说法就不成立了。
6. 完整案例:广告投放效果预测
任务:广告主在 TV / Radio / Newspaper 三个渠道投钱,预测能带来多少销售额(Sales)。数据集来自 Kaggle 的 Advertising 数据集。
| 列 | 含义 | 单位 |
|---|---|---|
| TV / Radio / Newspaper | 各渠道投放金额 | 千元 |
| Sales | 销售额 | 百万元 |
1 | import pandas as pd |
怎么读结果:
- 两条路线的系数和 MSE 应当非常接近——凸损失只有一个碗底,只要都收敛,就该殊途同归;
- 标准化后系数便于横向比较:同一把尺子下,哪个渠道的 $|w|$ 大,说明该渠道与销售额的线性关联更强——结论通常是 TV 最大、Radio 次之、Newspaper 最小。严谨地说这只是「参考性的相对重要性」:它仍受共线性、编码方式影响,且是相关性而非因果效应;
- 拿到模型后,给一组新投放方案就能
predict出预期销售额,用于预算分配。
7. 优缺点与适用场景
优点:
- 简单、训练快,系数可解释(每个特征的影响一目了然);
- 损失是凸函数,全局最优有保证;
- 有解析解,小数据上一步到位。
缺点与对策:
- 只能刻画线性关系——关系弯曲时拟合不足;
- 对异常值敏感(平方放大)——可换 MAE 或先处理离群点;
- 特征多重共线性(特征间高度相关)时系数估计不稳定——加 L2 正则化(岭回归);
- 特征很多时容易过拟合——加 L1/L2 正则化(Lasso / Ridge)。
补充 经典线性回归的几条假设:① 特征与目标的关系对参数线性;② 误差均值为 0、相互独立且方差相同(同方差);③ 「误差服从正态分布」主要影响统计推断(置信区间、显著性检验),做点预测时并不是必须满足的条件。
8. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 一元 vs 多元线性回归 | 特征只有 1 个 vs 多个;几何上是找直线 vs 找超平面 |
| MSE 当损失 vs 当指标 | 同一个公式两个角色:训练时是最小化的目标,评估时是打分的尺子 |
| LinearRegression vs SGDRegressor | 同一个模型、不同求解器:前者解析解,后者梯度下降,凸损失下结果应一致 |
| 标准化前 vs 后的系数 | 量纲不同不可直接比大小;标准化后才能拿 $ |
| 相关关系 vs 因果关系 | 回归系数只说明「同涨同跌的相关性」,不代表「因为 x 才有 y」——比如冰淇淋销量与溺水人数正相关,锅是夏天 |
| fit_intercept 的取舍 | 特征全为 0 时目标值本身有意义(如基准分)就保留截距;数据已中心化时可去掉 |
| 残差 vs 误差 | 残差是样本上「真实 − 预测」的可计算量;误差是理论上的随机噪声,只能假设不能观测 |