逻辑回归
30 秒先懂
逻辑回归名字里带「回归」,干的是分类的活:它对「正类几率(odds)的对数」建立线性回归,再经 sigmoid 翻译成概率,超过阈值判正类。
它是二分类的默认起点模型——和线性回归共用「模型 + 损失 + 求解」的整套框架,只换了两块积木:输出端加一个 sigmoid,损失函数从 MSE 换成对数损失。
1. 它解决什么问题?
任务:预测样本属于某个类别的概率——邮件是不是垃圾邮件、交易是不是欺诈、病人是否患病。
为什么不能直接拿线性回归做分类? 线性回归的输出 $wx + b$ 是 $(-\infty, +\infty)$ 上的任何数,而分类标签只有 0 和 1:
- 输出 3.7、-2.4 这样的数,没法解释成「属于正类的概率」(概率必须在 0~1);
- 更糟的是拟合方向错乱:一个离群正样本会把直线猛地往上拽,把本来分对了的负样本压过界——分类任务里 MSE 的「最小化竖直偏差」根本不是我们想要的。
解决方式出奇地简单:**在输出后面接一个 sigmoid 函数,把任意实数压到 (0, 1)**:
$$P(y=1 \mid x) = \sigma(w^\top x + b), \qquad \sigma(z) = \frac{1}{1 + e^{-z}}$$
输出一个概率 $p$,再和阈值(默认 0.5)比较:$p > 0.5$ 判正类,否则判负类。
典型应用场景:信用评分(违约/不违约)、欺诈检测、垃圾邮件识别、广告点击预测、医学诊断、情感分析(正面/负面)。
2. 核心直觉
直觉一:sigmoid 是个「概率翻译器」。 线性部分 $z = w^\top x + b$ 先算出一个证据分数——分数越高,说明特征越支持「这是正类」;sigmoid 再把分数翻译成概率。它的形状是 S 形曲线:
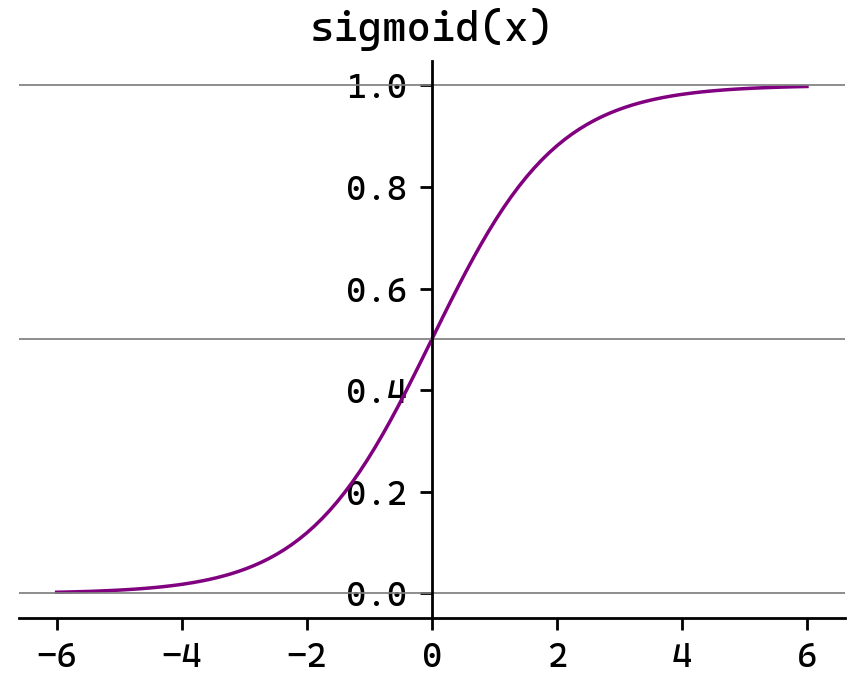
读图三要点:$z = 0$ 时输出恰好 0.5;$z$ 越大越接近 1、越负越接近 0,但永远到不了 0 或 1;整个函数单调递增——证据越足,概率越大,从不回头。
手算一次:
| $z$ | $\sigma(z)$ | 含义 |
|---|---|---|
| $-2$ | $\dfrac{1}{1+e^{2}} \approx 0.12$ | 证据强烈指向负类 |
| $0$ | $0.5$ | 五五开 |
| $+2$ | $\dfrac{1}{1+e^{-2}} \approx 0.88$ | 证据强烈指向正类 |
直觉二:决策边界是一条直线。 概率等于 0.5 的位置恰好是 $z = 0$,也就是 $w^\top x + b = 0$——在特征空间里这是一条直线(超平面)。所以逻辑回归本质上是线性分类器:sigmoid 只负责「报概率」,划分世界的仍然是那条线性边界。
3. 数学表达 / 公式
3.1 sigmoid 及其导数
$$\sigma(z) = \frac{1}{1 + e^{-z}} \qquad \sigma’(z) = \sigma(z)\big(1 - \sigma(z)\big)$$
导数用函数自身表达——算过 $\sigma(z)$,导数就是一次乘法。这个性质让梯度计算非常便宜,也是它在神经网络里长期当激活函数的原因。
3.2 关键视角:逻辑回归真正「回归」的是 log-odds
这是理解「为什么它叫逻辑回归」的钥匙。把 $p = \sigma(z)$ 反解出来:
$$p = \frac{1}{1+e^{-z}} ;;\Rightarrow;; \frac{p}{1-p} = e^{z} ;;\Rightarrow;; \ln\frac{p}{1-p} = w^\top x + b$$
逐个认识新符号:
| 符号 | 名字 | 含义 |
|---|---|---|
| $\dfrac{p}{1-p}$ | 几率(odds) | 正类概率是负类概率的多少倍。$p=0.8$ 时 odds = 4,「是正类的把握是不是正类的 4 倍」 |
| $\ln\dfrac{p}{1-p}$ | 对数几率(log-odds / logit) | 几率取对数,把 (0,1) 上的概率映到 $(-\infty,+\infty)$ |
所以逻辑回归的准确读法是:特征与「正类几率的对数」之间存在线性关系——这是一个如假包换的回归模型,回归的对象是 log-odds,只不过预测时再经 sigmoid 翻译回概率。名字里的「回归」由此而来。
系数也因此有了精确的解读:特征 $x_j$ 每增加 1 个单位,正类几率变为原来的 $e^{w_j}$ 倍。
手算一次:某特征系数 $w_j = 0.7$,则 $e^{0.7} \approx 2$——该特征每加 1 个单位,正类的几率大约翻倍(注意是几率翻倍,不是概率翻倍:$p$ 从 0.33 → 0.5 只涨 0.17,但从 0.8 → 0.89 只涨 0.09——概率越接近 1,同样「几率翻倍」带来的概率涨幅越小,这正是 sigmoid 曲线越来越平的原因)。
3.3 损失函数:对数损失(二元交叉熵)
为什么不能用 MSE? 除了「分类误差不该量竖直距离」,还有个数学硬伤:MSE 套上 sigmoid 后不是凸函数——碗底有好几个,梯度下降可能卡在半山腰。得换一个既是概率自洽、又是凸的损失。
对数损失(Log Loss,即二元交叉熵)对单个样本定义为:
$$L(y, p) = -\big[, y \ln p + (1 - y)\ln(1 - p) ,\big]$$
| 符号 | 含义 |
|---|---|
| $y$ | 真实标签(0 或 1) |
| $p$ | 模型给出的正类概率 $\sigma(z)$ |
它其实是「两种情况合一」:$y=1$ 时只剩 $-\ln p$,$y=0$ 时只剩 $-\ln(1-p)$。直觉:只看你真实属于的那一类的概率给得够不够高,给得越低罚得越狠。
手算一次(设真实标签 $y = 1$,看模型在不同 $p$ 下的损失):
| 模型输出 $p$ | 损失 $-\ln p$ | 解读 |
|---|---|---|
| 0.9 | 0.105 | 自信且正确,轻罚 |
| 0.5 | 0.693 | 瞎猜,中等罚 |
| 0.1 | 2.303 | 自信地犯错,重罚 |
| 0.01 | 4.605 | 极度自信地犯错,罚到肉疼 |
对比 MSE 同场景最多罚 1 分左右($(1-0.01)^2 \approx 0.98$),对数损失对「自信的错误」零容忍——这正是分类需要的性质。
它从哪来?极大似然。 全体样本的似然是「每个真实类别被模型赋予的概率」连乘:
$$L(w, b) = \prod_{i=1}^{n} p_i^{,y_i},(1-p_i)^{,1-y_i}$$
取对数变连加,再取负号变成「越小越好」,就得到了上面的对数损失——最小化交叉熵 = 最大化似然,和线性回归里「最小二乘 = 极大似然」如出一辙。
3.4 梯度(了解)
对对数损失求梯度,结果干净得出人意料:
$$\nabla = \frac{1}{n} X^\top \big(\sigma(Xw) - y\big)$$
和线性回归的梯度 $\frac{1}{n}X^\top(Xw - y)$ 形式完全相同——只是「残差」换成了「预测概率与真实标签之差」。之所以能化简成这样,靠的正是 $\sigma’(z) = \sigma(1-\sigma)$ 这个性质。好消息:对数损失 + sigmoid 组合是凸函数,梯度下降找到的必然是全局最优。
4. 模型是怎么训练出来的?
框架与线性回归完全一致:初始化参数 → 按负梯度迭代更新 → 收敛。区别只有损失函数换了,而 sklearn 里连迭代器都不用你操心——选个求解器即可:
| solver | 原理 | 适用 | 支持正则化 |
|---|---|---|---|
lbfgs(默认) |
拟牛顿法 | 中小数据,首选 | 仅 L2 |
newton-cg |
牛顿法 | 中小数据 | 仅 L2 |
liblinear |
坐标下降 | 小数据集 | L1 + L2 |
sag |
随机平均梯度 | 大数据集 | 仅 L2 |
saga |
改进的随机梯度 | 大数据集 | L1 + L2 + ElasticNet |
正则化相关的三个参数:
1 | model = LogisticRegression( |
易错
C的方向和 Lasso/Ridge 的alpha正好相反:alpha越大惩罚越强,C越大惩罚越弱。class_weight="balanced"用于类别不平衡(如欺诈检测),等效于把少数类的错误罚得更重。
训练完成后模型对象里保存了:coef_(各特征的系数,解读见 3.2 的 $e^{w_j}$ 倍规律)、intercept_(截距)。预测时有两种姿势:
predict(X):内部先算 $\sigma(z)$,再按阈值 0.5 切成类别,返回 0/1;predict_proba(X):不切阈值,直接返回每个样本的 $[P(y=0),\ P(y=1)]$,形状 (n, 2)、两列之和为 1——做阈值调整、画 ROC 时用它。
补充
predict_proba给出的是「模型估计的概率」,不保证校准良好:所有预测 0.8 的样本里,未必真有约 80% 是正类。需要可靠概率(如风险定价)时要另行做概率校准,初学阶段记住这句话即可。
5. Python / sklearn 怎么实现?
用 6 个样本的最小例子过一遍接口:
1 | from sklearn.linear_model import LogisticRegression |
真实任务的特征不会只有一个,下面进入两个完整案例。两个案例都使用 Pipeline 把预处理和模型绑在一起——好处(防泄漏、防漏步骤、保存完整)在 KNN 一篇已经详细演示过,这里直接采用。
6. 案例一:心脏病预测(二分类)
任务:用 13 项体检指标(年龄、性别、胸痛类型、静息血压、胆固醇、空腹血糖、静息心电图、最大心率、运动性心绞痛、ST 下降、ST 斜率、主血管数量、地中海贫血)预测是否患有心脏病。
1 | import pandas as pd |
怎么读结果:
score返回的是准确率。想看漏诊情况,要换 Recall(查全率)视角——医疗场景漏诊代价远高于误报;- 胸痛类型这类无序类别必须独热编码:若直接用 0/1/2/3,模型会误以为「类型 3 比类型 1 大 3 倍」,而类别之间并没有大小关系。这里保留了完整独热编码(不 drop 首列):逻辑回归虽可 drop 防共线,但配合正则化时不 drop 更省心,两做法都合理;
- 学完系数后按 3.2 的方式解读:某个特征的 $w$ 每加 1(标准化后的一单位),患病几率变为 $e^{w}$ 倍。
7. 多分类:OvR 与 Softmax
逻辑回归天生是二分类器,扩展到多分类有两条路。
7.1 一对多(OvR,One-vs-Rest)
做法:C 个类别就训练 C 个独立的二分类器,第 c 个分类器把「类别 c」当正类、其余全部当负类。预测时让所有分类器各报一个概率,取最高者。
手算一次:3 分类(猫/狗/鸟),三个分类器对同一个样本分别输出「是我这一类的概率」:
1 | 猫分类器:0.2 狗分类器:0.7 鸟分类器:0.3 |
- 优点:简单直观,类别不多时很好用;
- 缺点:C 大时训练 C 个模型开销大;每个分类器见到的正负样本比例悬殊。
1 | from sklearn.multiclass import OneVsRestClassifier |
7.2 Softmax 回归(多项逻辑回归)
做法:只训练一个模型,给它 C 组系数、一次算出 C 个分数 $z_1 \dots z_C$,再用 softmax 函数把 C 个分数归一化成概率分布:
$$P(y = c \mid x) = \frac{e^{z_c}}{\sum_{k=1}^{C} e^{z_k}}$$
手算一次:3 类的分数 $z = [2,\ 1,\ 0.5]$:
- 各自取指数:$e^2 = 7.39$,$e^1 = 2.72$,$e^{0.5} = 1.65$,总和 $= 11.76$
- 归一化:$[0.63,\ 0.23,\ 0.14]$——和恰好为 1
指数的作用是放大差距:分数领先一点的类,概率被拉开一大截。
| OvR | Softmax | |
|---|---|---|
| 模型数量 | C 个 | 1 个 |
| 类别间关系 | 各自为政 | 一次性输出互斥的概率分布 |
| 计算量 | 类别多时训练慢 | 每次预测要对所有类求指数 |
| 结果一致性 | 可能多个分类器概率接近 | 更一致 |
1 | model = LogisticRegression() # 多分类问题上,支持 multinomial 的求解器会自动优化 |
版本提示 旧版 sklearn 需要手动写
multi_class="ovr"/"multinomial"来切换两种策略,该参数在新版本中已弃用:多分类默认由支持 multinomial 的求解器直接优化 softmax 损失;确需 OvR 时用OneVsRestClassifier包一层。博客代码建议固定 sklearn 版本,以写作时的官方文档为准。
补充 Softmax 的配套损失是「多类交叉熵」:$-\ln P(y=c\mid x)$,即只看真实类那一路的概率给得高不高——和对数损失是同一个思想的多分类版。
8. 案例二:手写数字识别(10 分类)
任务:识别手写数字 09。Digit Recognizer 数据集:每张图 28×28 像素,展平成 784 个灰度值(0255),train.csv 第一列是标签:
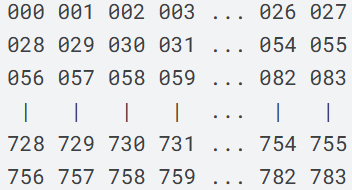
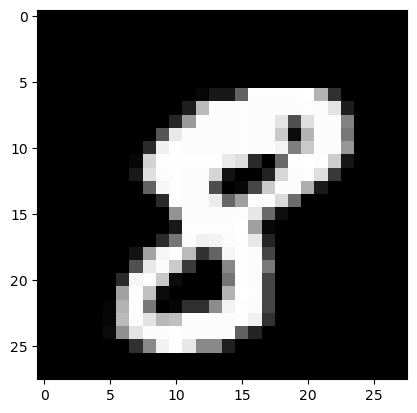
784 个特征 + 10 个类别——正好用 Softmax 多分类。这次把归一化和模型放进同一条 Pipeline,后面会看到这样做的直接好处:
1 | import pandas as pd |
怎么读结果:一个 200 多年前的数学工具(最小二乘)+ 一个线性模型,在 784 维的手写数字上就能拿到 90% 以上的准确率——线性模型的下限决定了它永远是第一个该试的基线。而 Pipeline 的价值在最后一步显形:新样本直接进 pipe.predict,归一化自动完成——如果模型和缩放器分开保存,这一步极容易漏掉 transform,拿原始 0255 像素去喂在 01 数据上训练的模型,预测必然出错。
9. 优缺点与适用场景
优点:
- 直接输出概率,方便按业务调整阈值和代价;
- 系数可解释($e^{w_j}$ 的几率倍数解读);
- 损失是凸函数,训练稳定、全局最优有保证;
- 训练快,是工业界二分类的默认基线。
缺点与对策:
- 决策边界是线性的——特征和类别之间是非线性关系时拟合不动;对策:特征工程(交叉、多项式特征)或换非线性模型;
- 特征很多时容易过拟合——默认 L2 正则化,必要时换 L1 做特征选择;
- 类别极不平衡时只看准确率会误判——用
class_weight="balanced"、换 Recall/F1 视角。
10. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 逻辑回归 vs 线性回归 | 前者分类(输出概率),后者回归(输出数值);共用「线性 + 求解」框架,换的是输出函数和损失 |
| 「线性」的对象 | 逻辑回归对 log-odds 线性,不是对概率线性——这正是它叫回归的原因 |
| sigmoid vs 决策边界 | sigmoid 是输出空间的概率曲线;决策边界是特征空间里 $w^\top x + b = 0$ 的直线——逻辑回归是线性分类器 |
| MSE vs 对数损失 | 分类任务用对数损失:概率自洽、凸、重罚自信的错误;sigmoid + MSE 非凸且语义错位 |
| predict vs predict_proba | 前者返回阈值切好的类别,后者返回原始概率——调阈值、画 ROC 必须用后者 |
| 概率 vs 校准概率 | predict_proba 的输出是模型估计的概率,不保证「预测 0.8 的样本里真有 80% 为正」 |
| C vs alpha | 都是正则化参数但方向相反:alpha 越大罚越强,C 越大罚越弱 |
| OvR vs Softmax | C 个二分类器各报各的概率 vs 一个模型输出互斥的概率分布 |
| 阈值 0.5 | 默认值不是铁律——类别不平衡或代价敏感时,按业务调阈值(配合 ROC/精确率召回率权衡) |