KNN(K 近邻)
30 秒先懂
KNN(K-Nearest Neighbors,K 近邻):要判断一个新样本的类别,就看离它最近的 K 个邻居里谁是多数派——物以类聚。
它和前面两个模型思路完全不同:不假设任何函数形式、不训练任何参数,是理解「机器学习不只有『拟合一条线』」的最佳样本。这一篇还会第一次正式用上 Pipeline——把预处理和模型绑在一起,一次性解决数据泄漏、CV 内预处理、模型保存三件事。
1. 它解决什么问题?
既有分类(邻居投票)也有回归(邻居平均),都属于监督学习。核心思想一句话:
给定一个新样本,计算它与训练集中所有样本的距离,找出最近的 K 个,用这 K 个邻居的类别(或数值)来预测它。
和线性/逻辑回归相比,KNN 的特别之处在于对数据没有任何假设——不要求关系是线性的,决策边界可以弯出任意形状,数据长什么样就学成什么样。
典型场景:推荐系统里「找和你行为最相似的 K 个用户」、异常检测(离所有簇都很远的点可疑)、小数据集上的快速基线模型。
2. 核心直觉
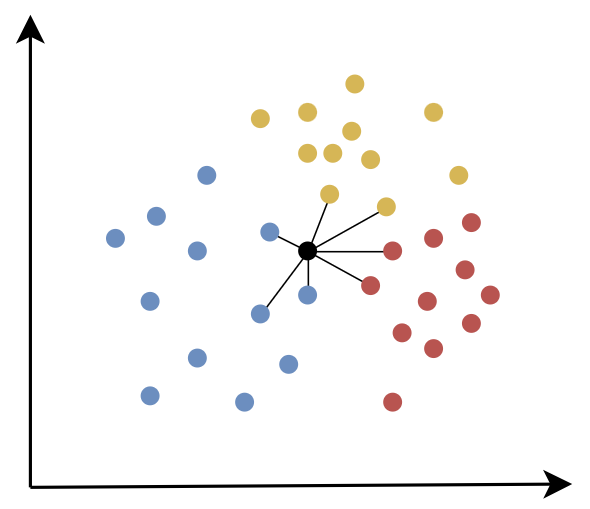
直觉一:近朱者赤。 下图中黑色是新样本,三个颜色是三个类——不需要任何公式,肉眼就能判断它属于蓝色:因为离它最近的邻居几乎都是蓝色的。
走一遍完整流程(手算)。二维平面上有 5 个样本:正类三个 (2,2)、(4,2)、(3,4),负类两个 (8,8)、(7,9)。新样本 x = (3,3),用欧氏距离,取 K=3:
| 邻居 | 距离计算 | 距离 | 排名 |
|---|---|---|---|
| (3,4) 正 | $\sqrt{0+1}$ | 1.00 | ① |
| (2,2) 正 | $\sqrt{1+1}$ | 1.41 | ② |
| (4,2) 正 | $\sqrt{1+1}$ | 1.41 | ③ |
| (8,8) 负 | $\sqrt{25+25}$ | 7.07 | ④ |
| (7,9) 负 | $\sqrt{16+36}$ | 7.21 | ⑤ |
最近 3 个邻居全是正类 → 3 票对 0 票,判为正类。预测做完了:算距离、排序、投票——这就是 KNN 的全部。
直觉二:K 是「视野范围」的旋钮。
| K 取值 | 行为 | 风险 |
|---|---|---|
| K = 1 | 只看最近 1 个邻居,边界弯弯曲曲 | 对噪声极度敏感 → 过拟合 |
| K = 全部样本 | 所有人投票,永远预测多数类 | 完全忽略局部特征 → 欠拟合 |
| 适中的 K(如 5~15) | 平滑又保留局部结构 | 通常最好,K 是超参数 |
K 过小 = 过拟合、K 过大 = 欠拟合——这对概念在 KNN 的 K 上第一次有了具体的旋钮。二分类任务常从奇数 K 开始试(偶数 K 更容易平票),但这只是经验,不是硬规定。
3. 数学表达 / 公式
3.1 投票与平均
分类:K 个邻居多数表决:
$$\hat{y} = \operatorname*{arg,max}{c} \sum{i \in N_K(x)} \mathbb{1}(y_i = c)$$
含义:统计 K 个邻居 $N_K(x)$ 中每个类别 $c$ 出现的票数,取票数最多的类别。($\mathbb{1}$ 是指示函数,邻居属于类别 $c$ 时取 1。)
回归:不做投票,直接取 K 个邻居标签的平均值。
补充 进阶版是加权投票:离得越近的邻居票越重(权重常取距离的倒数)——远处邻居「只见其声」,近处邻居「一锤定音」。sklearn 里
weights="distance"即是;类别不平衡时它也比等权投票更稳。
3.2 四种距离度量
距离是 KNN 的命根子——「最近」全靠它定义。
欧氏距离(直线距离,最常用)——两点间线段的长度:
$$d(x, y) = \sqrt{\textstyle\sum_{i=1}^{n}(x_i - y_i)^2}$$
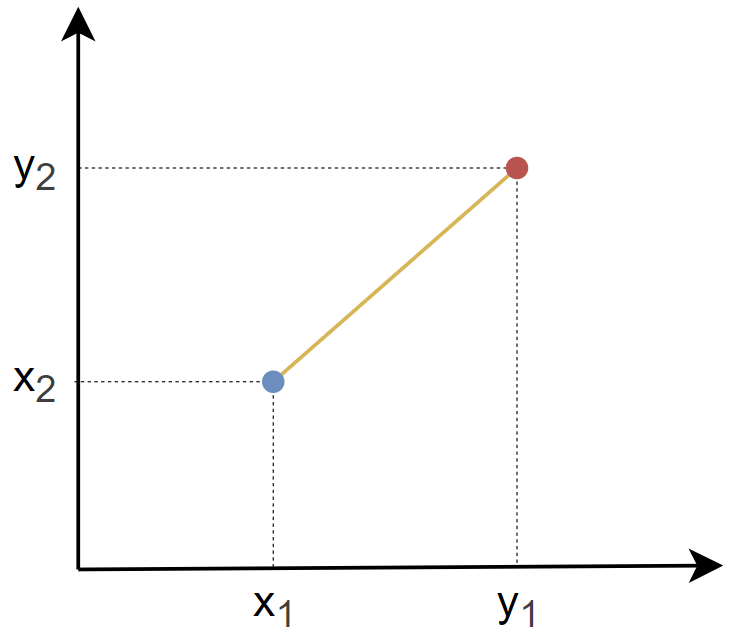
手算:$(1,2)$ 与 $(4,6)$:$\sqrt{(1-4)^2+(2-6)^2} = \sqrt{9+16} = 5$(正好是勾股定理的 3-4-5 三角形)。
曼哈顿距离(城市街区距离)——各坐标差绝对值之和:
$$d(x, y) = \textstyle\sum_{i=1}^{n}\vert x_i - y_i \vert$$
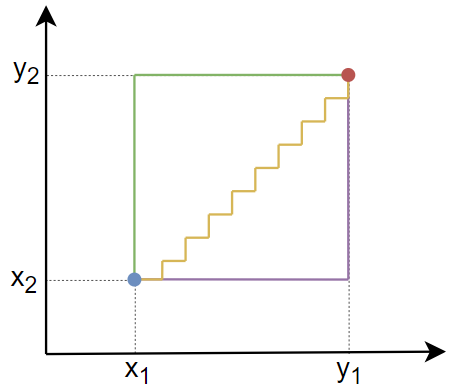
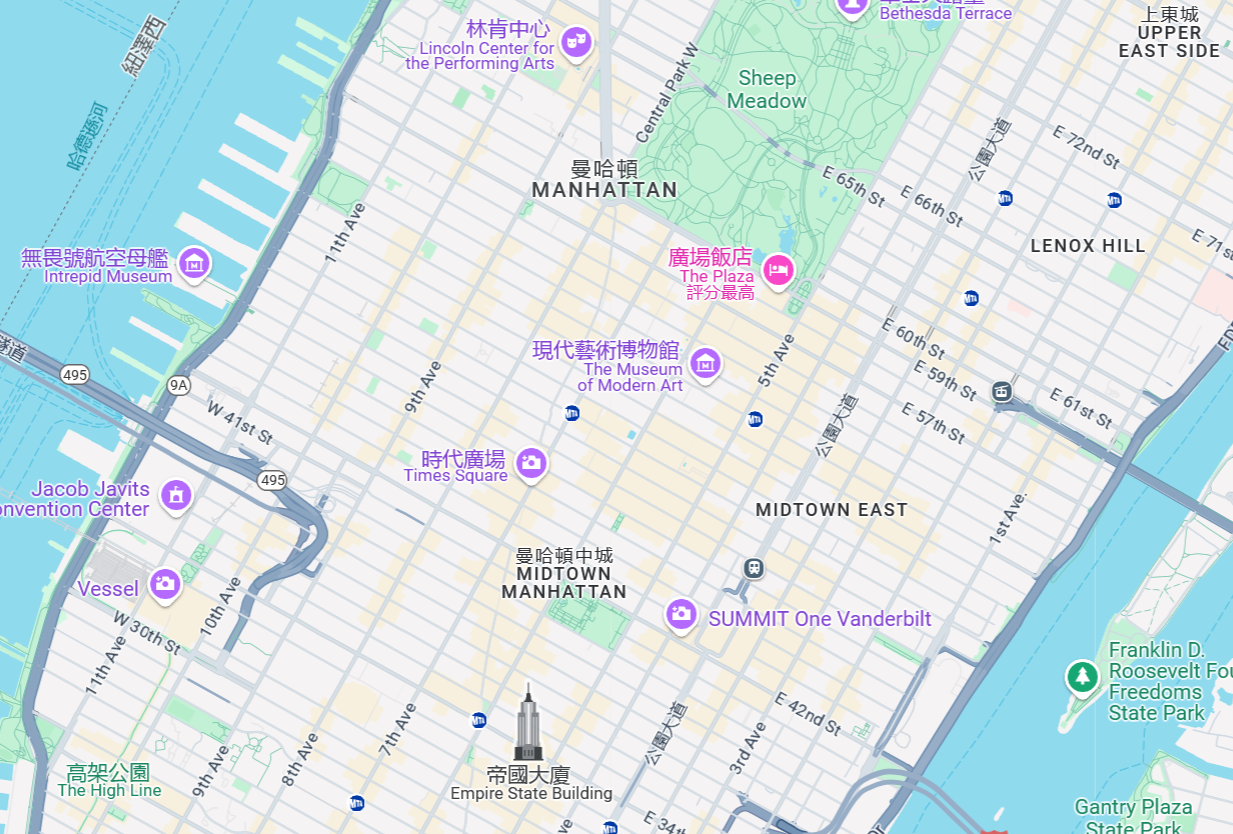
手算:$\vert 1-4\vert + \vert 2-6\vert = 3 + 4 = 7$。名字来自纽约曼哈顿:街道是规则网格,车只能横开竖开不能穿楼,行驶距离就是「横向差 + 纵向差」:
切比雪夫距离——各坐标差绝对值的最大值:
$$d(x, y) = \max_i \vert x_i - y_i \vert$$
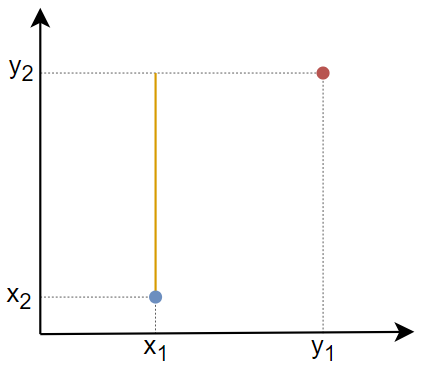
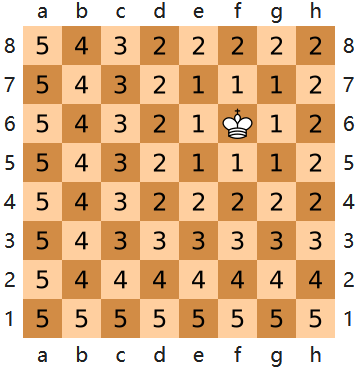
手算:$\max(\vert 1-4\vert, \vert 2-6\vert) = \max(3, 4) = 4$。类比国际象棋:国王横、竖、斜都能走,从一格到另一格的最少步数就是两格坐标差的较大值——下图中国王到每个格子的数字就是切比雪夫距离:
闵可夫斯基距离——前三种的统一公式,$p$ 是可调参数:
$$d(x, y) = \left(\textstyle\sum_{i=1}^{n}\vert x_i - y_i \vert^p\right)^{1/p}$$
| 参数 | 退化为 | 记忆 |
|---|---|---|
| $p = 1$ | 曼哈顿距离 | 一次方:各维度一视同仁累加 |
| $p = 2$ | 欧氏距离 | 平方:大差异被放大 |
| $p \to \infty$ | 切比雪夫距离 | 只剩最大的那个差异 |
$p$ 越小,对多个维度的差异越敏感;$p$ 越大,越只看最大的维度差异。sklearn 默认用的就是闵可夫斯基距离且 $p=2$(即欧氏距离)。
补充 怎么选:连续数值特征、无特殊结构 → 欧氏(默认);特征是「路径/计数」类、想避免大值被平方放大 → 曼哈顿;只关心「最差的那一项」→ 切比雪夫。连续特征与类别特征混合时,简单欧氏距离未必合理(可了解 Hamming、Gower 距离)。拿不准就用默认欧氏,把精力留给调 K。
4. 模型是怎么训练出来的?
答案可能出乎意料:KNN 没有「训练」过程。
fit(X, y) 做的事情只有一件——把训练数据存下来(并建立索引结构)。没有参数要学、没有梯度要算、没有损失要优化。真正的计算全部发生在 predict 时:
1 | predict(新样本) |
这类「把计算从训练挪到预测」的模型叫懒惰学习(Lazy Learning);线性回归那类「训练时算完、预测时只做乘加」的叫急切学习(Eager Learning)。代价挪了个位置:
| 训练 | 预测 | |
|---|---|---|
| 急切(线性回归) | 慢(解方程/迭代) | 极快(一次乘加) |
| 懒惰(KNN) | 极快(存数据/建索引) | 慢(和全训练集算距离) |
补充 两点工程常识:① sklearn 的 KNN 用 KD 树、Ball 树等索引加速「找最近邻居」,因此**新增训练样本后通常需要重新
fit**(重建索引),它并不是严格意义的在线增量模型;② 特征维度很高(成百上千维)时这些索引会退化——高维空间里所有点彼此距离都差不多远,「最近」失去意义(维度灾难对 KNN 的精准打击)。
5. Python / sklearn 怎么实现?
1 | from sklearn.neighbors import KNeighborsClassifier, KNeighborsRegressor |
常用参数:
| 参数 | 含义 | 默认 |
|---|---|---|
n_neighbors |
K 值(最重要的超参数) | 5 |
weights |
投票权重:uniform 等权 / distance 距离倒数加权 |
uniform |
metric / p |
距离度量:默认闵可夫斯基 p=2(欧氏) |
minkowski, p=2 |
6. KNN 上场前,必须先做特征缩放
为什么 KNN 对特征尺度极度敏感? 因为距离是各维度差直接相加的——量纲大的特征会一个人霸占整个距离,其他特征形同虚设。
手算一次。三个客户:A(25 岁,月收入 3 万)、B(28 岁,月收入 3.1 万)、C(26 岁,月收入 8 万),算欧氏距离的平方(收入以「千元」计):
$$d^2(A, B) = \underbrace{(25-28)^2}{\text{年龄}=9} + \underbrace{(30-31)^2}{\text{收入}=1} = 10$$
$$d^2(A, C) = \underbrace{(25-26)^2}{\text{年龄}=1} + \underbrace{(30-80)^2}{\text{收入}=2500} = 2501$$
收入项的贡献是年龄项的几百倍——找「最近邻居」时年龄几乎不起作用。而且这不是造数据:收入 3 万8 万、年龄 2080,收入项天然比年龄项大三个数量级。解法就是缩放:
| 归一化 MinMaxScaler | 标准化 StandardScaler | |
|---|---|---|
| 做法 | 压到固定区间(默认 [0,1]) | 均值 0、标准差 1 |
| 对异常值 | 敏感 | 仍会被拉偏(极端时用 RobustScaler) |
| 缩放后效果 | 每个特征对距离的贡献被拉回同一量级 | 同左 |
1 | from sklearn.preprocessing import MinMaxScaler, StandardScaler |
一句话总结:逻辑回归要不要缩放看优化效率,KNN 要不要缩放是生死问题——不缩放,距离就是量纲最大的那个特征的独角戏。
7. 正式认识 Pipeline:把预处理和模型绑在一起
在做案例前,先解决一个所有模型都会踩的坑。目前我们的习惯写法是:
1 | x_train = preprocessor.fit_transform(x_train) # ① 先对整个训练集做预处理 |
①② 分开写有三个隐患:
- 预处理学到的统计量(均值、类别名单)来自整个训练集——一旦后面接交叉验证/网格搜索,每一折验证折的信息其实已经泄漏进了预处理;
- 预测新样本时容易忘记 transform(拿原始 0~255 像素去喂在归一化数据上训练的模型,预测必然出错);
- 保存模型时容易只存了模型、忘了预处理器。
解法是 sklearn 的 Pipeline(管道):把所有步骤串成一条流水线,fit 时从前往后依次执行,predict 时自动复用前面步骤学到的统计量:
1 | from sklearn.pipeline import Pipeline |
后面网格搜索一节会看到它最大的价值:接进 GridSearchCV 后,交叉验证的每一折都会只在该折的训练部分重新 fit 预处理器——泄漏问题从结构上被消灭。
8. 完整案例:心脏病预测
任务:1025 条病人体检记录、13 个特征(年龄、性别、胸痛类型、静息血压、胆固醇、空腹血糖、静息心电图、最大心率、心绞痛、ST 下降、ST 斜率、主血管数量、地中海贫血),预测是否患有心脏病。
加载后的数据长这样:
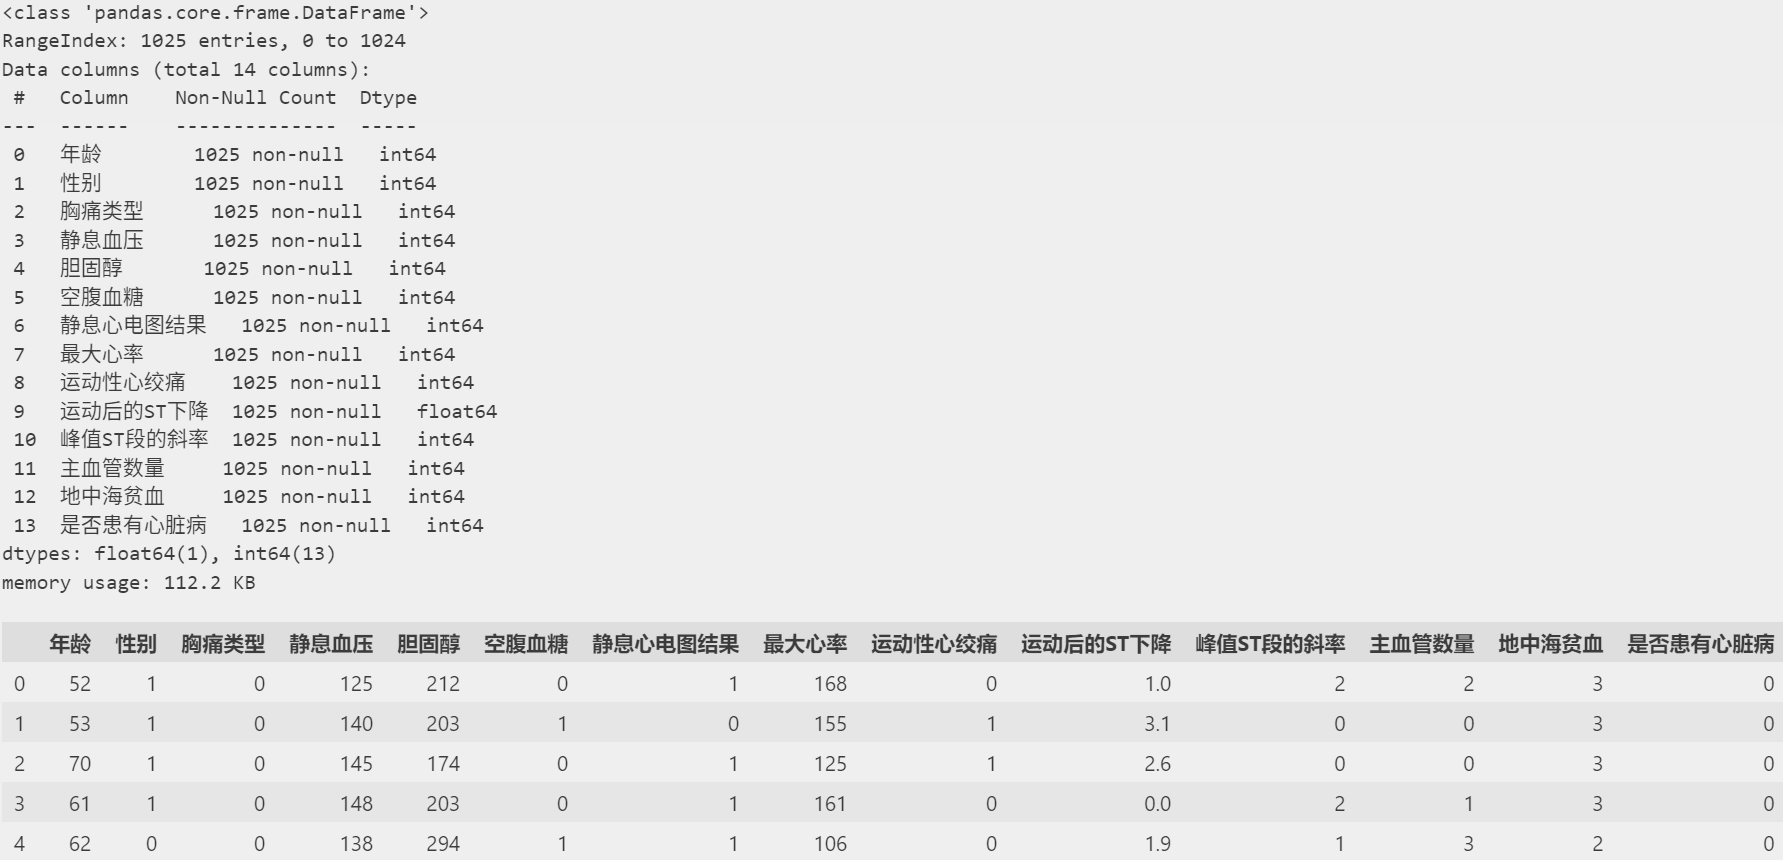
1 | import pandas as pd |
8.1 类别特征为什么必须独热编码
胸痛类型取值 0/1/2/3,是四个没有大小关系的类别。若直接喂给 KNN,距离计算会得出「类型 1 和类型 2 的差异 = 类型 1 和类型 3 的差异的一半」这种荒谬结论——编码方式决定了距离,距离决定了 KNN 的一切。独热编码把每个类别变成一列 0/1:
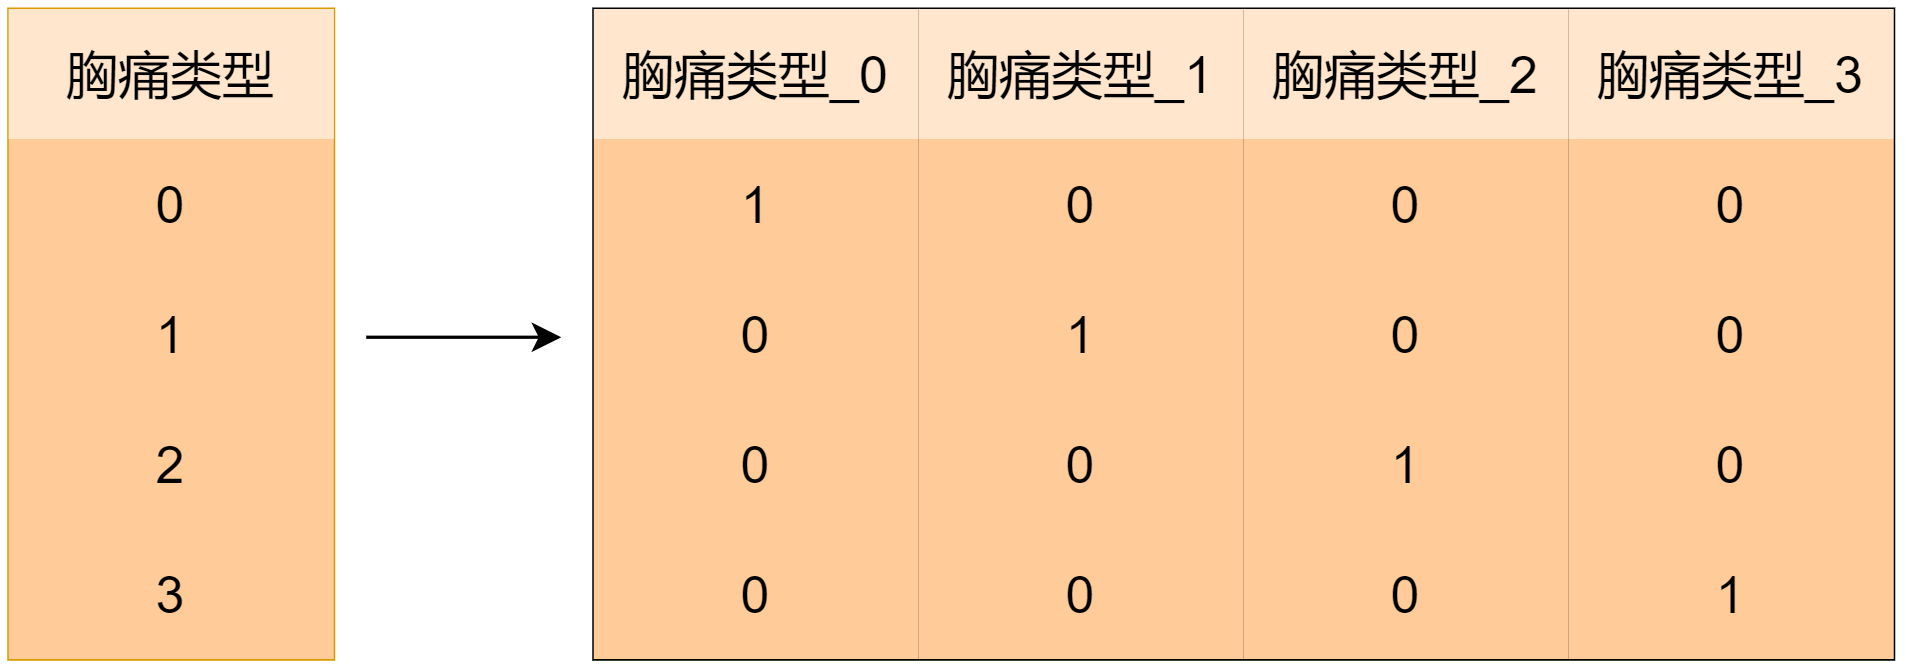
8.2 关键细节:KNN 的独热编码不要 drop=”first”
线性模型里用 drop="first" 防多重共线性是常见做法。但对 KNN 这类基于距离的模型,drop 第一列是错误的——它会破坏类别之间的距离对称性。
手算一次。某特征有 A/B/C 三类。完整独热编码:
1 | A = [1, 0, 0] B = [0, 1, 0] C = [0, 0, 1] |
三类两两之间的欧氏距离**全部等于 $\sqrt{2}$**——完全对称,模型认为三个类别平等。
如果 drop 掉 A 列:
1 | A = [0, 0] B = [1, 0] C = [0, 1] |
$$d(A,B) = 1 \qquad d(A,C) = 1 \qquad d(B,C) = \sqrt{2}$$
本来平等的三个类别,被人为制造出了不同距离(B 和 C 被推远了)。KNN 的预测全靠距离,这种失真是实质性的。所以规则是:
| 模型 | 独热编码建议 | 原因 |
|---|---|---|
| 线性/逻辑回归等 | 可以 drop="first" |
防完全共线性,让系数可解 |
| KNN、K-means 等距离模型 | 保留完整编码 + handle_unknown="ignore" |
保持类别间距离对称 |
handle_unknown="ignore" 的作用:预测时遇到训练集没见过的类别不报错,整行编为全 0(恰好是「基准类别」的编码,语义自洽)。
8.3 模型的保存与加载
有了 Pipeline,保存变得非常省心——预处理器和模型一起保存,新样本直接丢原始特征即可:
1 | import joblib |
易错 如果只保存
knn,新样本预测时就必须手动复刻整条预处理链(同一个 StandardScaler 的均值、同一个 OneHotEncoder 的类别名单)——少一步或用错统计量,预测就是错的。要存就存整条 Pipeline。
9. 超参数调优:网格搜索 + Pipeline
问题来了:K 取 3 是拍脑袋的。取 5 会不会更好?——手动一个个试既低效,又容易在单一划分上「调到过拟合」。网格搜索(Grid Search)+ 交叉验证是标准解法:外层遍历参数组合,内层交叉验证评估。
这里正是 Pipeline 的高光时刻。如果先把整个训练集 fit 好预处理器、再交给 GridSearchCV,那么每一折的验证数据其实已经参与了缩放器的均值/类别名单的计算——交叉验证内部的数据泄漏,调出来的分数虚高。把 Pipeline 整体交给 GridSearchCV,每一折就会自动「在该折训练部分重新 fit 预处理器」:
1 | from sklearn.model_selection import GridSearchCV |
- 参数名里的
knn__是 Pipeline 步骤名和参数名的连接写法(步骤名__参数名); - 每一折内部自动完成:该折训练部分 fit 预处理器 → transform → fit KNN → 在验证部分评估;
- K=1~9、5 折共 45 次训练——贵,但换来的结论可靠。
易错
best_score_是交叉验证的分数,用来选参数;模型最终的真实水平,必须用没参与过任何调参决策的测试集再评一次——测试集从头到尾只许出场这一次。
10. 优缺点与适用场景
优点:
- 简单直观,几乎零学习成本;
- 无参数训练过程,实现成本低;
- 决策边界可以任意弯曲,不假设任何数据分布。
缺点与对策:
- 预测慢:每个样本都要和全训练集算距离——KD 树加速或换急切模型;
- 维度灾难:高维下距离失效——先降维或特征选择;
- 对噪声敏感(K 小时)——调大 K 或用
weights="distance"; - 必须缩放特征、要存全部训练数据(内存开销);
- 类别不平衡时投票偏向多数类——调 K、用距离加权、必要时重采样,评估换 Recall/F1 视角。
适用:中小规模、低维、需要快速基线或「相似度」本身就有业务含义的场景。
11. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| KNN 的 K vs K-means 的 K | 前者是投票时数几个邻居;后者是聚类算法 K-means 的簇心个数,两个 K 互不相干 |
| 惰性学习 vs 急切学习 | KNN 训练快预测慢(存数据);线性模型训练慢预测快(解参数) |
| K 过小 vs K 过大 | 过拟合(边界弯曲、跟噪声走)vs 欠拟合(一律预测多数类) |
| 独热编码 drop vs 不 drop | 线性模型可 drop 防共线;距离模型(KNN/K-means)保留完整编码保距离对称 |
| 提前 fit 预处理器 vs 放进 Pipeline | 前者会让验证折信息泄漏进均值/类别名单;Pipeline 让每折内部重新 fit |
| 等权 vs 加权投票 | uniform 一人一票;distance 近邻话语权大,K 大时更稳 |
| best_score_ vs 测试集分数 | 前者选参数用(交叉验证平均分),后者才是最终成绩;测试集只出场一次 |