感知机(Perceptron)
30 秒先懂
感知机:接收多个输入信号,加权求和后与阈值比较,超过就输出 1(神经元被激活),否则输出 0——一个最简单的二分类器,也是神经网络的「细胞」。
这一篇不训练任何模型,而是亲手给参数,让感知机学会与门、与非门、或门;然后撞上它天生做不到的事(异或门),再亲眼看着「叠加层」如何破局。整个过程就是神经网络的迷你预演。
1. 它解决什么问题?
感知机是一个二分类模型:接收多个输入信号,输出一个只有 0、1 两种取值的信号。下图是一个接收两个输入的感知机:
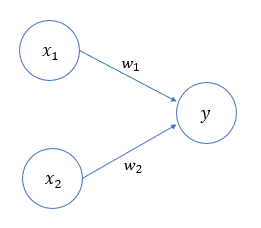
- $x_1, x_2$:输入信号;$y$:输出信号(0 或 1);
- $w_1, w_2$:权重,控制每个信号的重要性——权重越大,对应输入话语权越大;
- ○ 是神经元(节点):把传来的信号加权求和,总和超过某个界限值(阈值)就输出 1,称为神经元被激活。
它能解决一大类「按条件判断」的问题。本篇用三个经典问题检验它:与门、与非门、或门——数字电路的基本零件,也是「能不能被一条线分开」的试金石。
2. 核心直觉
直觉一:感知机是一场「加权投票 + 及格线」。 每个输入是一张选票,权重是票的分量,加权和是总票数;阈值是及格线——过线输出 1(激活),不过线输出 0。
直觉二:权重和偏置分工不同。
- 权重 $w$:控制每个输入信号有多重要;
- 偏置 $b$:调整神经元被激活的难易程度——$b$ 越大越容易被激活(门槛越低)。
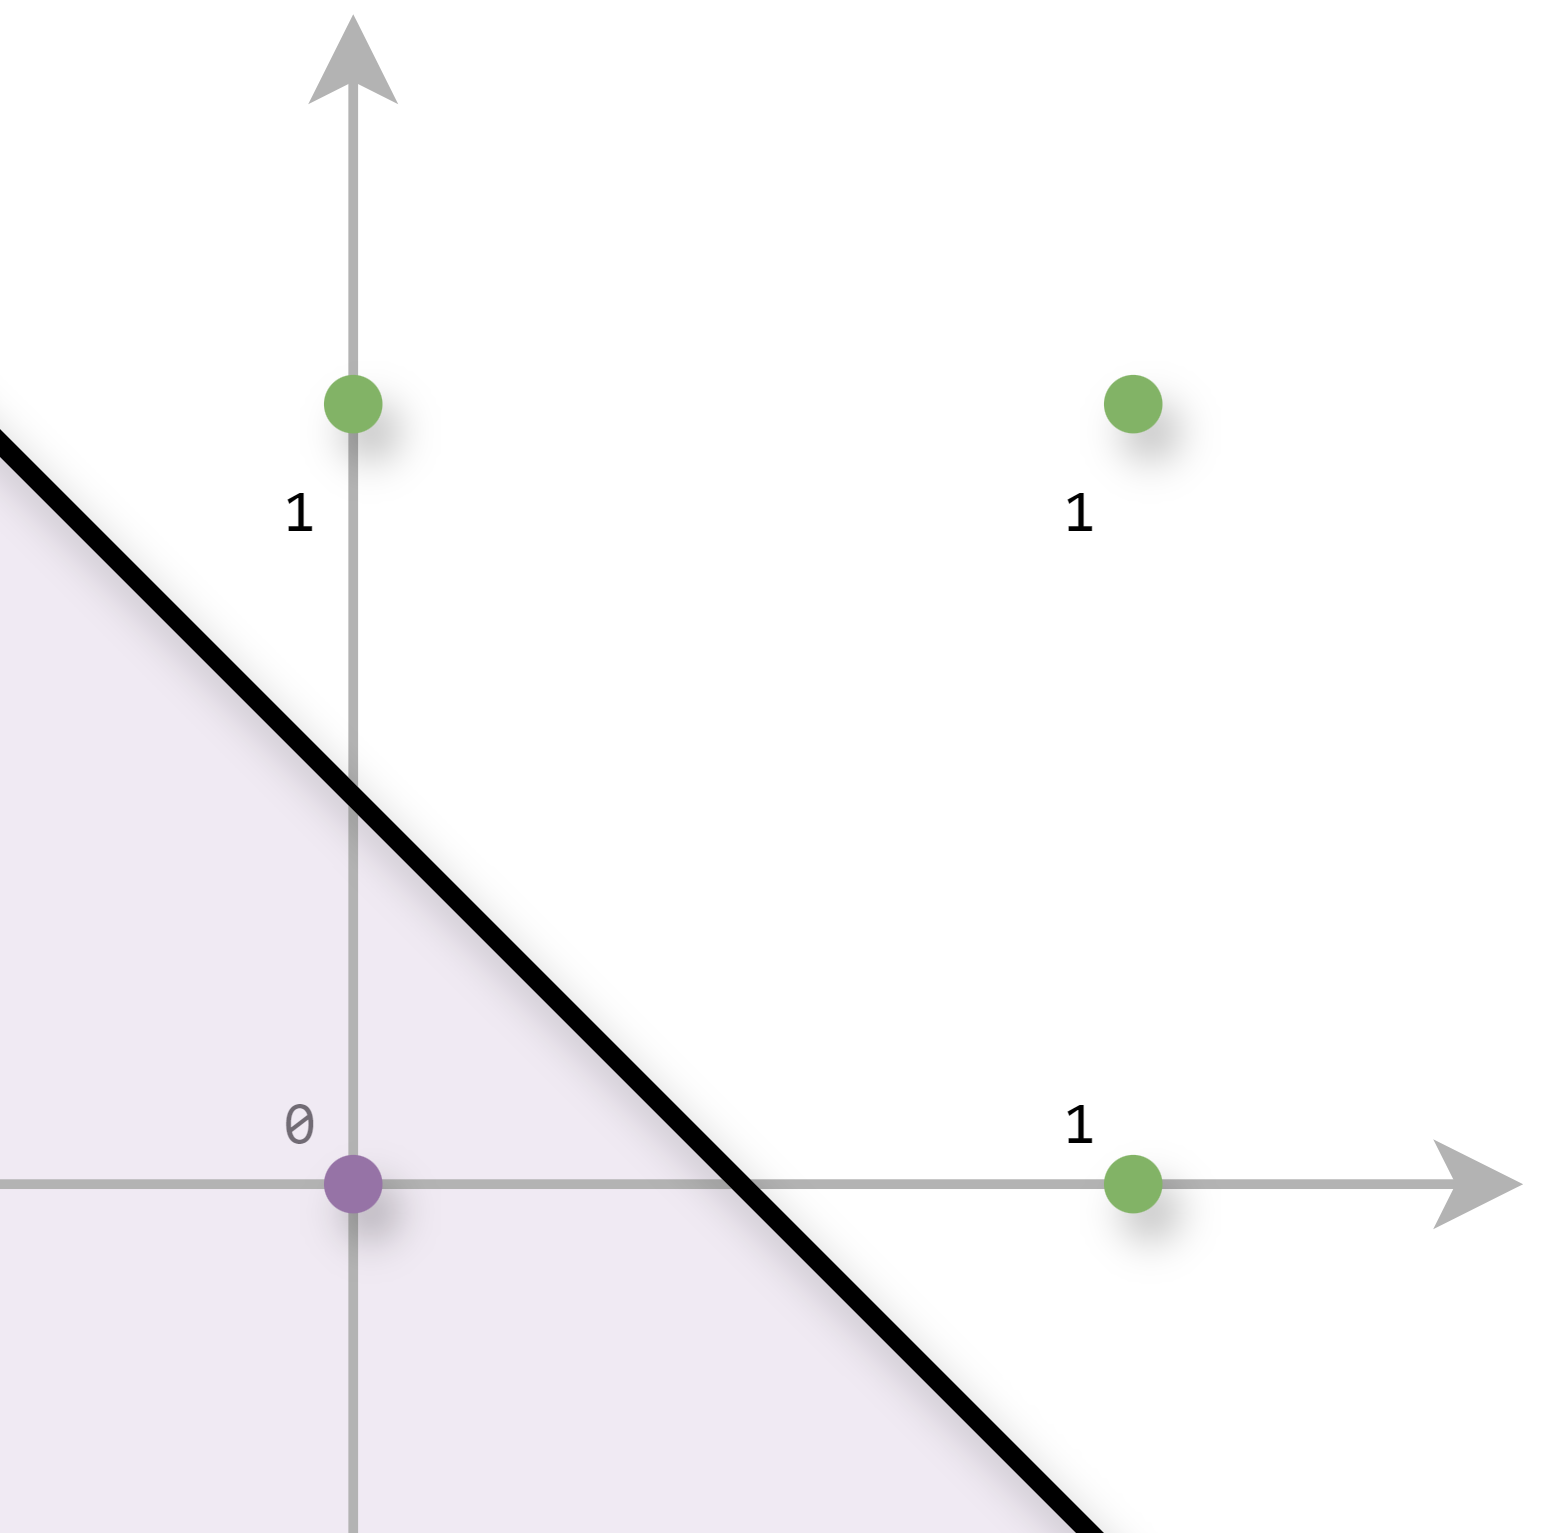
直觉三:单层感知机 = 一条直线切空间。 加权和大于 0 的区域和小于 0 的区域,被直线 $w_1x_1 + w_2x_2 + b = 0$ 一分为二——一边输出 1,一边输出 0。这个「只能切直线」的性质,决定了它后天的一切能耐与不能耐。
3. 数学表达 / 公式
把「加权总和超过阈值 θ 就输出 1」写成式子:
$$y = \begin{cases} 1, & w_1 x_1 + w_2 x_2 \ge \theta \ 0, & w_1 x_1 + w_2 x_2 < \theta \end{cases}$$
把 $\theta$ 移到左边(令 $b = -\theta$),得到更常用的形式:
$$y = \begin{cases} 1, & w_1 x_1 + w_2 x_2 + b \ge 0 \ 0, & w_1 x_1 + w_2 x_2 + b < 0 \end{cases}$$
$b$ 就是偏置。注意 $b$ 和 $w_1, w_2$ 的地位不同:$w$ 乘在输入上,$b$ 是常驻的「底分」。
手算一次:用 $(w_1, w_2, b) = (0.5, 0.5, -0.7)$ 实现与门(两个输入都是 1 才输出 1):
| $x_1$ | $x_2$ | 加权和 $0.5x_1 + 0.5x_2 - 0.7$ | 输出 |
|---|---|---|---|
| 0 | 0 | $-0.7$ | 0 |
| 1 | 0 | $-0.2$ | 0 |
| 0 | 1 | $-0.2$ | 0 |
| 1 | 1 | $+0.3$ | 1 |
四个输入全部符合与门真值表。直觉核对:只有两个「1」的票加在一起($0.5+0.5=1.0$)才能越过及格线 $0.7$——与门要的就是这种「全票通过」。
| $x_1$ | $x_2$ | 与门 | 与非门 | 或门 |
|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 0 |
| 1 | 0 | 0 | 1 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 1 | 1 | 0 | 1 |
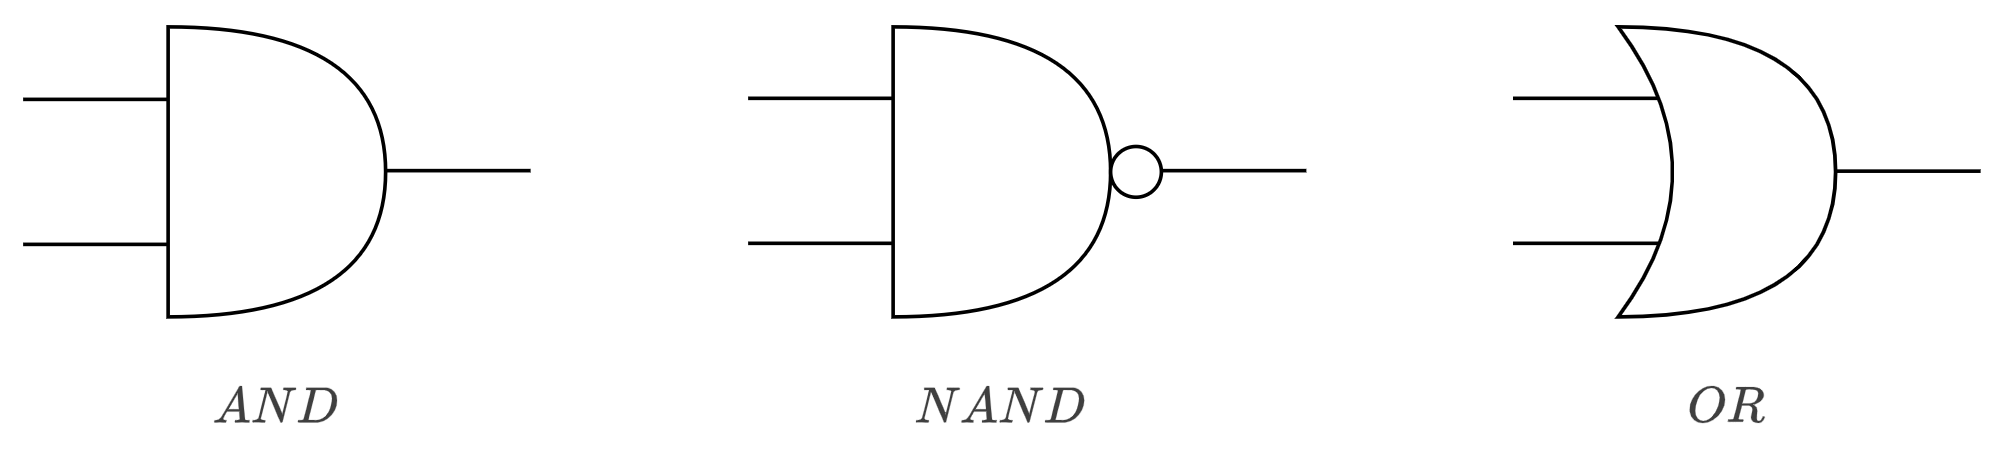
与非门(NAND)就是把与门的输出整个反过来——参数只需全部取反:$(-0.5, -0.5, 0.7)$。或门(OR)只要求「有一票就过」:$(0.5, 0.5, -0.2)$——及格线从 0.7 降到 0.2,单张 0.5 的票加上偏置就能过线。
4. 模型是怎么训练出来的?
本篇为了让每个参数的含义看得见摸得着,先采用手工配置:满足与门真值表的参数有无穷多组——$(0.5, 0.5, -0.7)$ 可以,$(0.7, 0.6, -0.9)$ 也可以,人工挑一组即可。与非门、或门同理,三组参数放在一起看:
| 门 | $w_1$ | $w_2$ | $b$ |
|---|---|---|---|
| 与门 AND | 0.5 | 0.5 | −0.7 |
| 与非门 NAND | −0.5 | −0.5 | 0.7 |
| 或门 OR | 0.5 | 0.5 | −0.2 |
4.1 真正的感知机学习算法
手工配置只是教学手段——感知机作为机器学习算法,自有它的训练规则。设学习率为 $\eta$,每遇到一个被错分的样本,就修正一次参数:
$$w \leftarrow w + \eta,(y - \hat{y}),x \qquad b \leftarrow b + \eta,(y - \hat{y})$$
| 情形 | $y - \hat{y}$ | 修正动作 |
|---|---|---|
| 真实 1,预测 0(漏报正类) | $+1$ | $w$ 向该样本的 $x$ 方向挪一步——把边界往「把这个点划进正类」推 |
| 真实 0,预测 1(误报) | $-1$ | 反方向推——把边界挪离这个负样本 |
| 预测正确 | $0$ | 参数不动 |
手算一次:设当前 $w = (0.2, -0.4)$、$b = 0$、$\eta = 0.1$。来一个正样本 $(3, 4)$:加权和 $= 0.2\times3 + (-0.4)\times4 + 0 = -1.0 < 0$,预测 $\hat{y} = 0$——错分。修正:
$$w = (0.2,\ -0.4) + 0.1 \times 1 \times (3,\ 4) = (0.5,\ 0.0) \qquad b = 0 + 0.1 = 0.1$$
边界被朝这个正样本的方向拉动了一步。反复遍历训练集、遇错就修,直到(数据允许的话)不再有错分样本。三点说明:
- 收敛定理:若数据线性可分,感知机学习算法在有限步内必能找到一个分开两类的超平面;若数据线性不可分(XOR),修正会永远震荡下去——这正预告了下一节的结论;
- 它不是梯度下降:阶跃函数非 0 即 1、几乎没有梯度可用——感知机规则是「错误驱动的修正」,不是「对激活函数求导」;
- 预测正确就不更新——参数只在犯错时移动,错了才学。
带着这条规则再看下一节:XOR 不是「学习算法没学好」,而是单层感知机这个模型类根本表达不了 XOR——无论怎么学、学多久,一条直线都切不开那四个点。
补充 三个门的结构完全相同,唯一的区别是参数取值。这暗示了一件了不起的事:感知机是「同一台机器,换参数换人格」——既然参数能决定行为,那么「让机器自动找参数」(训练)就是理所当然的下一步,这正是神经网络的学习要干的事。
5. Python / sklearn 怎么实现?
先按直觉的「阈值版」实现与门:
1 | def AND(x1, x2): |
换成「权重 + 偏置」形式,并用 NumPy 向量化(与非门、或门只差参数):
1 | import numpy as np |
6. 感知机的局限:异或门(XOR)
异或门:两个输入不一样时输出 1,一样则输出 0:
| $x_1$ | $x_2$ | 异或门 XOR |
|---|---|---|
| 0 | 0 | 0 |
| 1 | 0 | 1 |
| 0 | 1 | 1 |
| 1 | 1 | 0 |
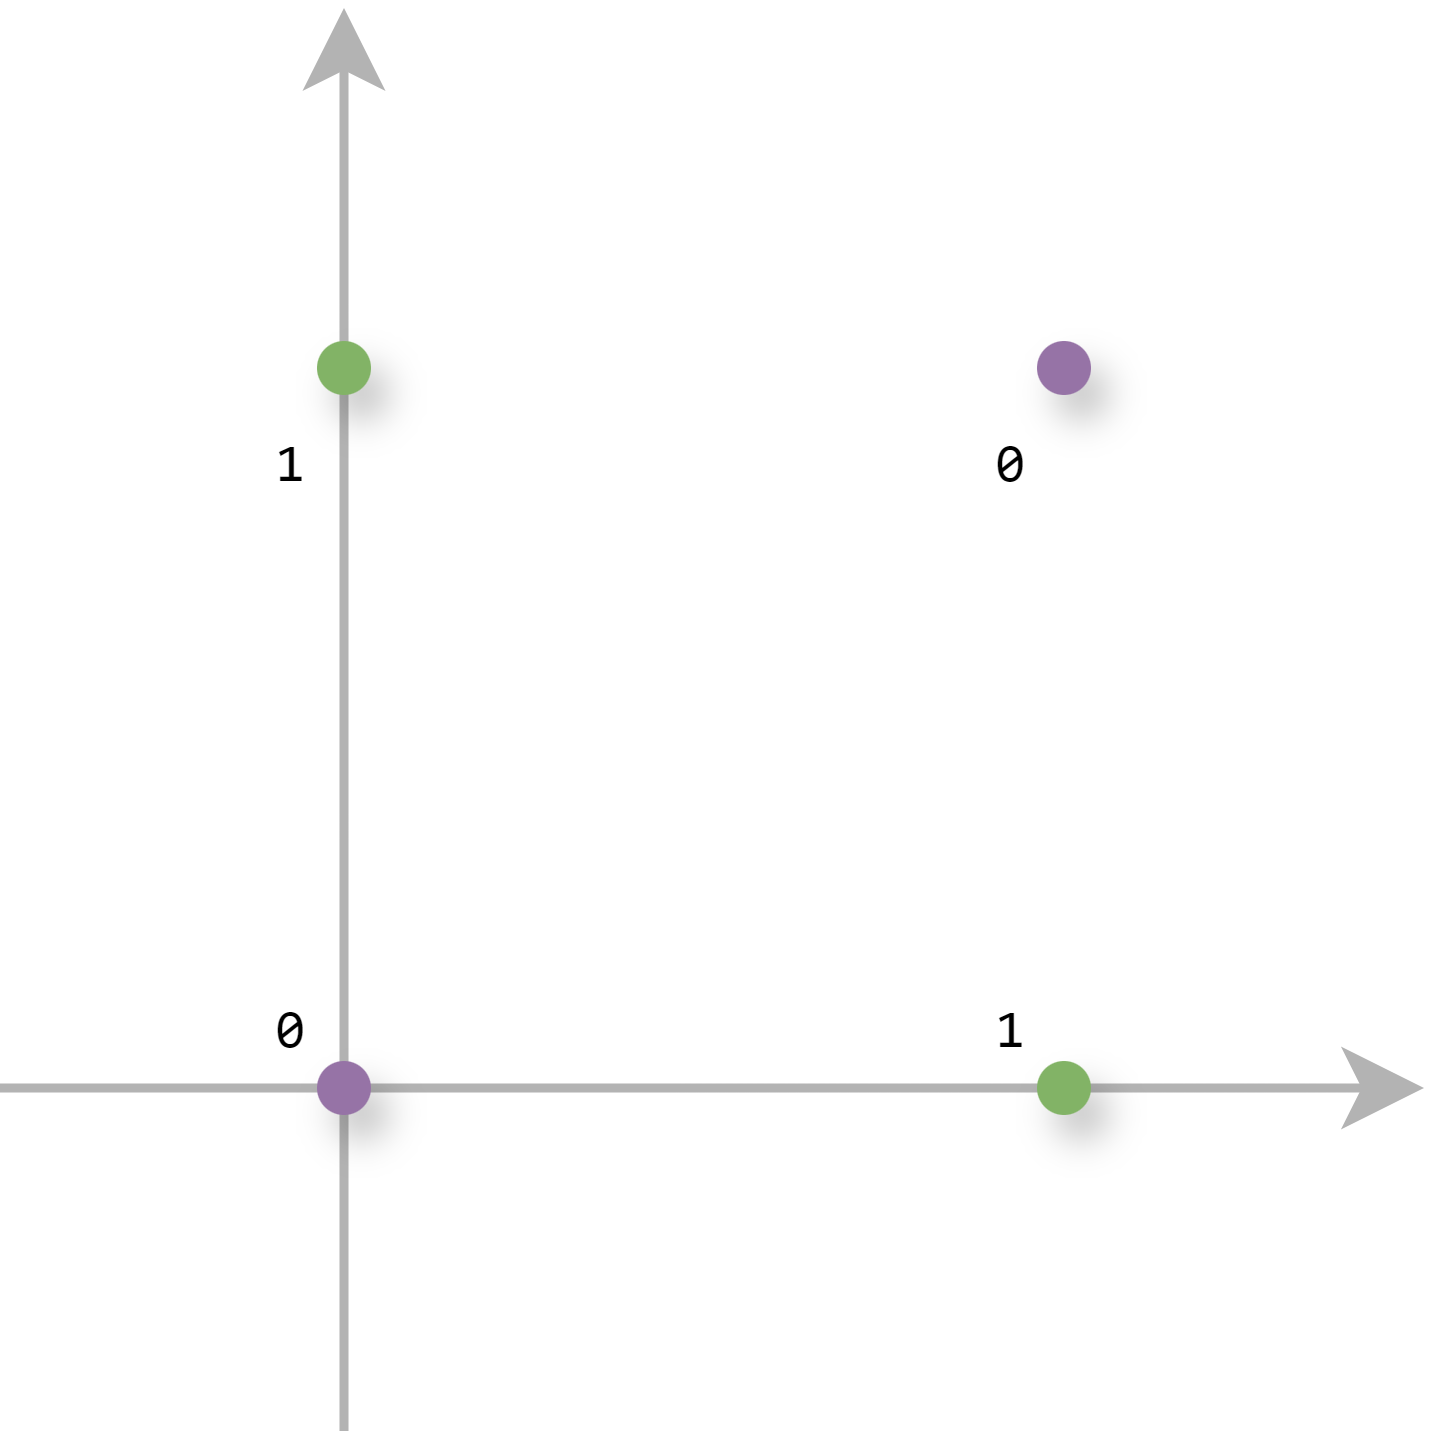
试着沿用上面的套路——你会发现无论怎么调参数都配不出来。为什么?画出几何图就明白了。
或门把平面切成两个半空间(直线一侧输出 1,另一侧输出 0):
把异或门的四个点画到坐标上:(0,0) 和 (1,1) 是 0,(1,0) 和 (0,1) 是 1——两类点对角交错,任何一条直线都无法把它们分开:
但把「直线」这个限制去掉就可以——用一条弯曲的线就能圈出 1 的区域:
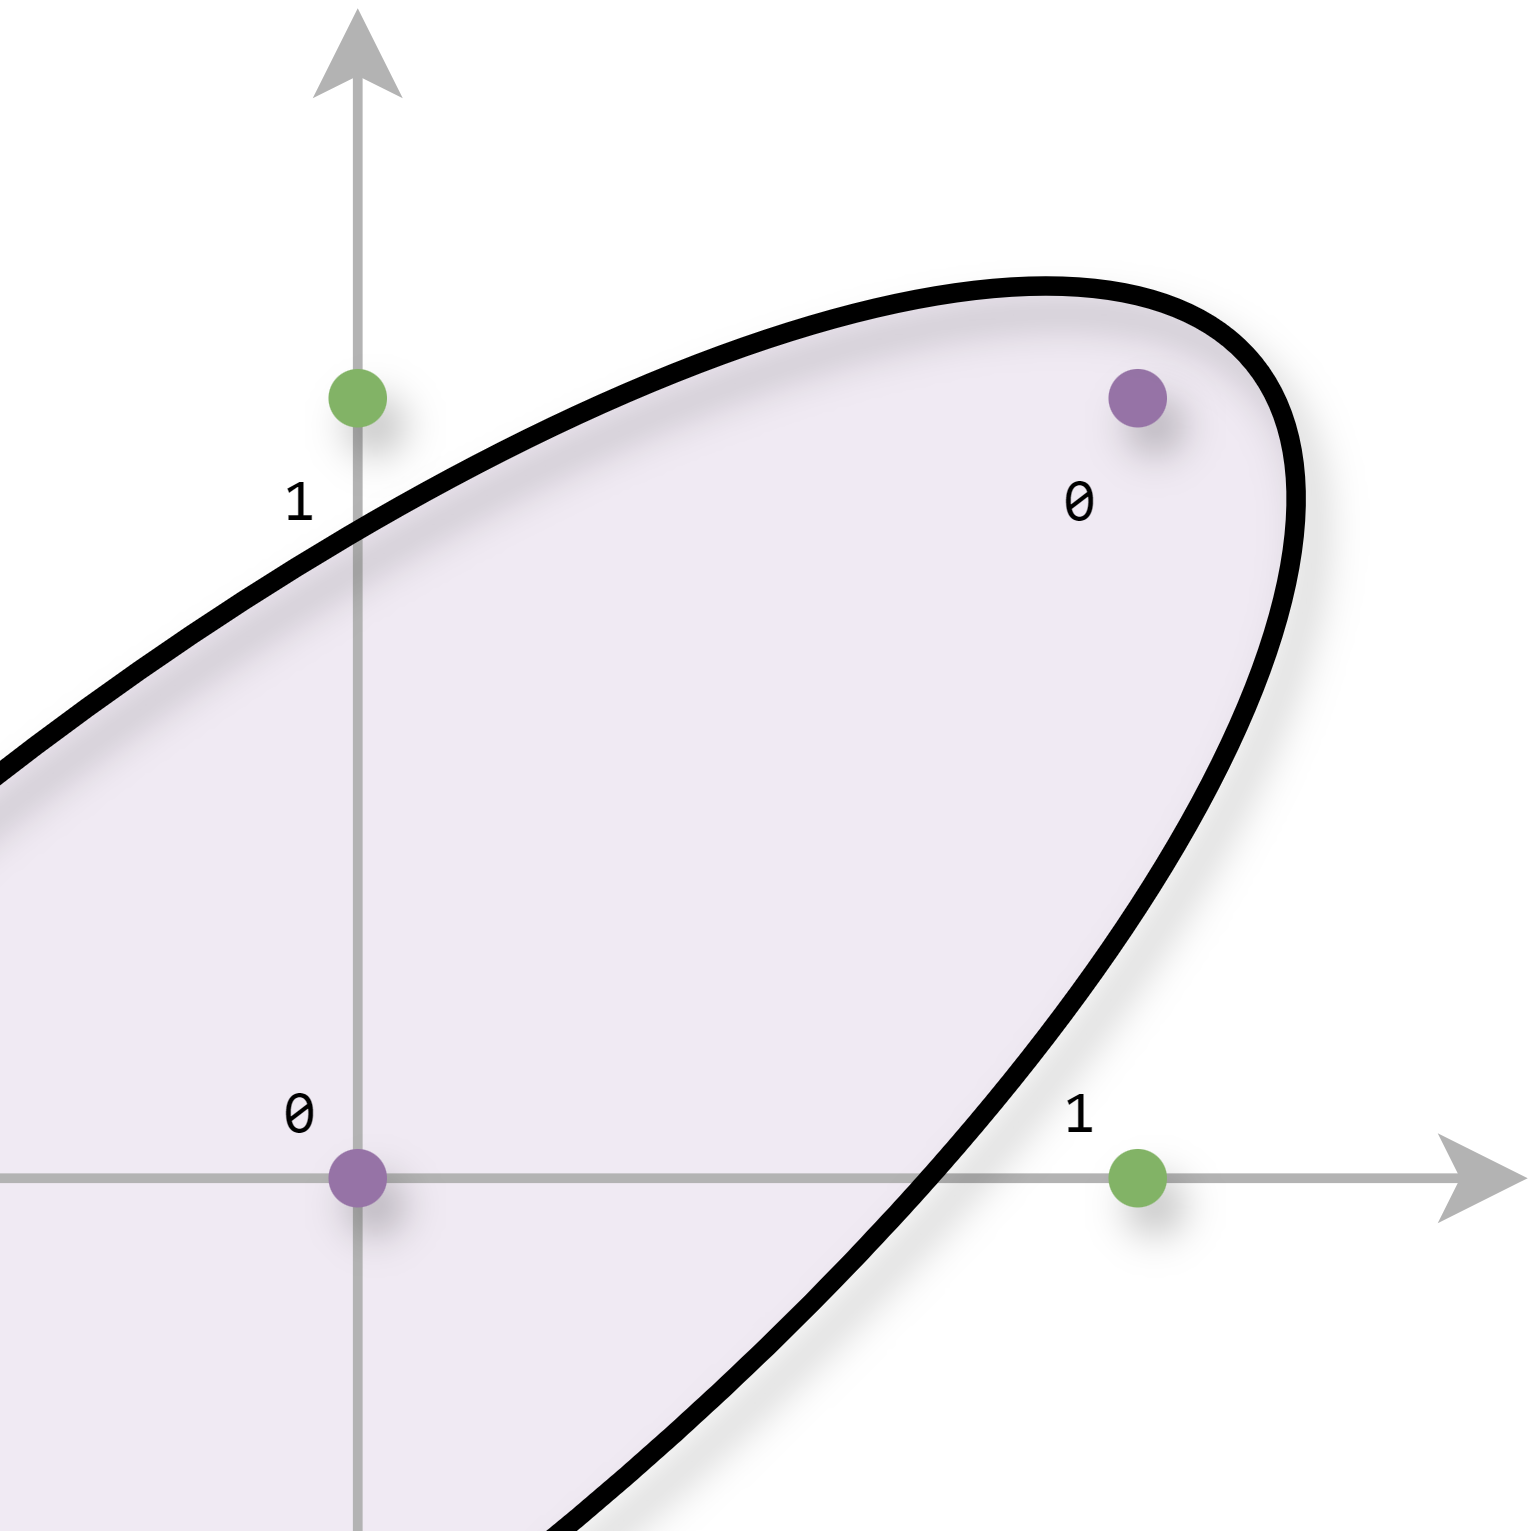
结论:单层感知机只能表示由一条直线划分的空间(线性空间);曲线划分的非线性空间它无能为力。而 XOR 恰好是一个非线性问题——不是参数没调好,是模型的表达能力到顶了。
7. 多层感知机:叠加层破局
单层不行,叠两层呢? 把已造好的零件组合起来——与非门、或门先各来一个,输出再接一个与门:
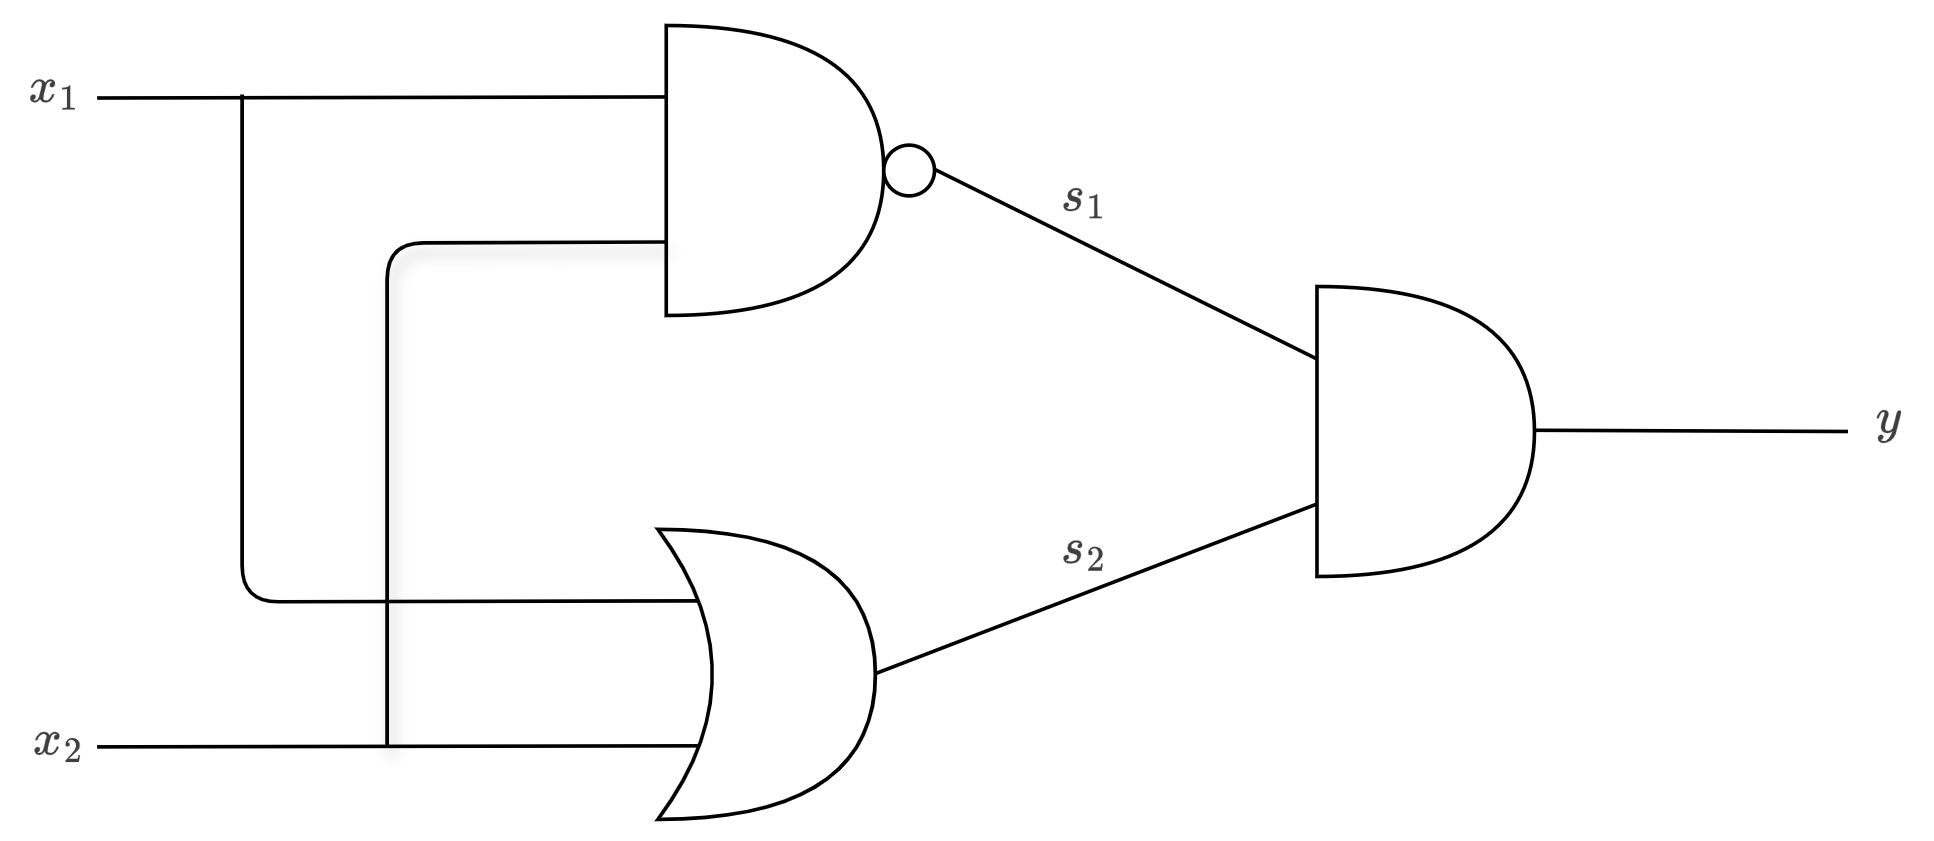
验证真值表:
| $x_1$ | $x_2$ | $s_1 = \text{NAND}$ | $s_2 = \text{OR}$ | $y = \text{AND}(s_1, s_2)$ |
|---|---|---|---|---|
| 0 | 0 | 1 | 0 | 0 |
| 1 | 0 | 1 | 1 | 1 |
| 0 | 1 | 1 | 1 | 1 |
| 1 | 1 | 0 | 1 | 0 |
完全符合异或门。代码上,XOR 只是三个已有函数的组合:
1 | def XOR(x1, x2): |
用感知机的画法表示这个结构——信号分三层流动:
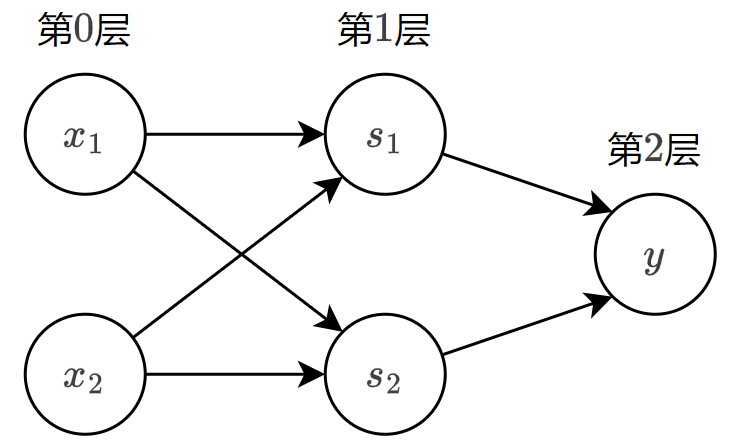
- 第 0 层(输入层)的两个神经元接收输入,发给第 1 层;
- 第 1 层(隐藏层)的两个神经元加工后再发给第 2 层;
- 第 2 层(输出层)给出最终结果。
两层各自只画直线,接力起来却能画出曲线围出的非线性空间——这就是「叠加层」的威力。 neurons(神经元)的个数不变、每个单元依旧简单,但层数让表达能力发生了质变。
8. 从感知机到神经网络
把本篇的收获连成一句话:
感知机 = 加权求和 + 阈值激活;单层只会线性切分,多层叠加就能表示远比直线复杂的非线性关系——带非线性激活、足够宽的前馈网络,在一定条件下可以任意精度逼近连续函数(但「能表示」不等于「训练一定能找到那组参数」)。
从这个起点再往前走半步,就是神经网络:
- 把「阶跃激活」(非 0 即 1)换成平滑的激活函数(如 sigmoid、ReLU),输出从「是/否」变成连续值,梯度才能流动;
- 把「手工配参数」换成「用损失函数 + 反向传播自动学参数」;
- 把层数和神经元数加厚——深度学习。
感知机是一切神经网络的原点:它简单到可以在一页纸里讲清楚,又完整地埋着「层」「权重」「偏置」「激活」这四个核心概念。
9. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 权重 vs 偏置 | 权重管「每个输入多重要」;偏置管「激活多容易」,是常驻的底分 |
| 感知机 vs 逻辑回归 | 都是线性边界;激活函数一个是阶跃(0/1),一个是 sigmoid(概率) |
| 单层 vs 多层感知机 | 单层只能线性切分;两层叠加即可表示非线性(XOR 的解法) |
| 与非门 vs 与门取反 | 同一件事:参数全部取反即可,结构与与门完全相同 |
| 线性可分 vs 非线性可分 | 一条直线能分开 = 线性可分(与门/或门);对角交错分不开 = 非线性(XOR) |
| 层数 vs 神经元个数 | 决定表达能力质变的是「层数」;单层加再多神经元仍是一条直线切分 |