决策树与集成学习
30 秒先懂
决策树:把「猜答案」变成一连串 if-else 提问(年龄 > 30 吗?收入 > 1 万吗?……),按信息增益自动挑出最有信息量的问题依次问下去。集成学习:把很多个模型投票/接力,三个臭皮匠顶个诸葛亮。
本篇(原文档标注【了解】)分两部分:先讲透单棵决策树的原理与防过拟合的剪枝,再看把树组合起来的三种集成套路,重点落地 AdaBoost 与随机森林。
第一部分:决策树
1. 它解决什么问题?
决策树(Decision Tree)是一种基于树形结构的分类与回归算法:根据一系列条件判断逐步划分数据、缩小范围,最终得出预测。它由四部分组成:
- 根节点:树的起点,包含所有数据;
- 内部节点:一个特征上的判断条件(如「年龄 > 30?」);
- 分支:判断条件的每种结果;
- 叶节点:最终的分类/回归结果。
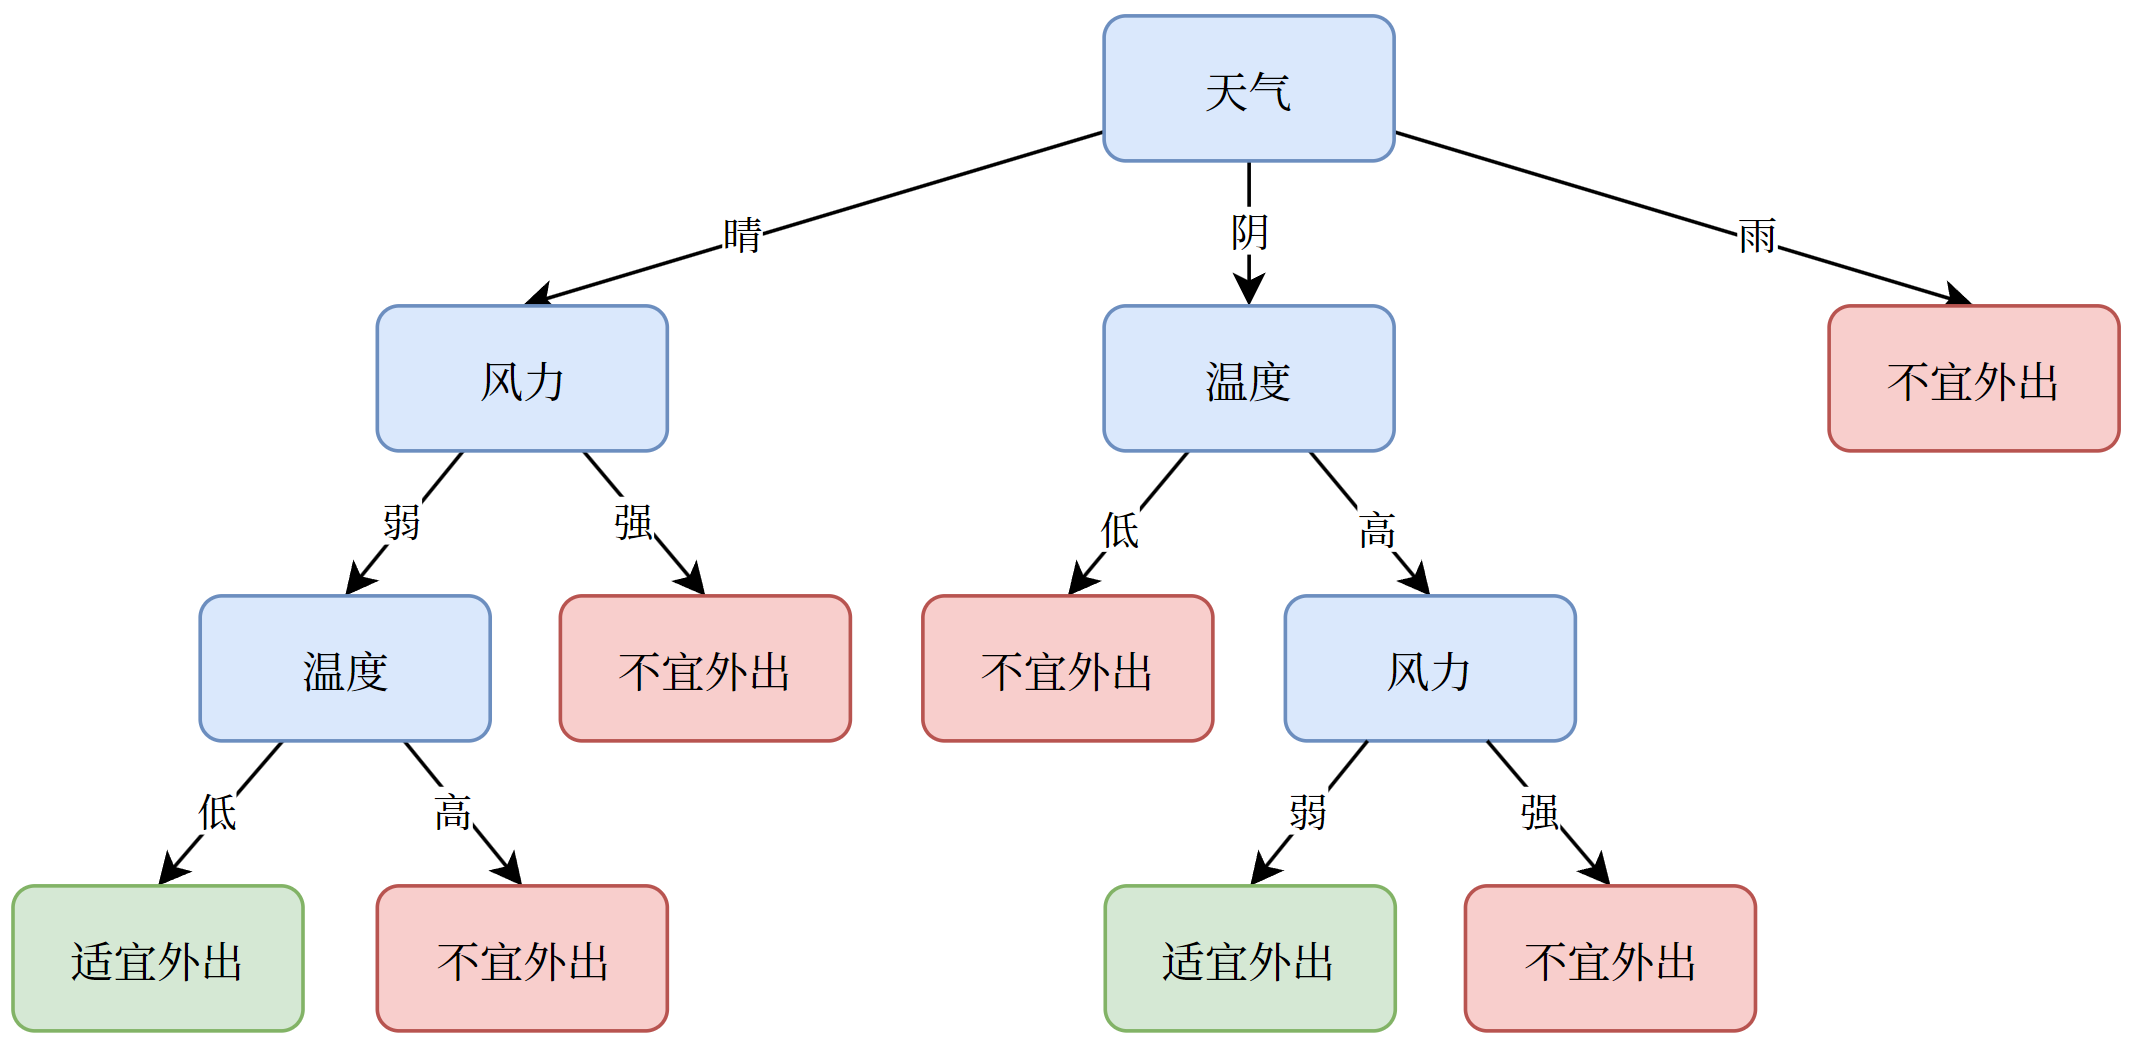
它的杀手锏是可解释性:每个预测都能还原成一条「因为……所以……」的规则链,是业务方最爱问「为什么」的场景(风控、医疗)里最吃香的模型。
2. 核心直觉
直觉一:决策树就是「20 个问题」游戏。 猜一个人是谁,聪明的问法是先问「是男的吗」(一刀切掉一半可能),而不是先问「是张三吗」(猜中概率极小)。好问题 = 问完之后局面更「确定」的问题——决策树就是把「挑最值得问的问题」自动化。
直觉二:每次划分 = 特征空间里切一刀。 每个节点按某特征的某个取值把数据一分为二,整个树相当于用许多超平面把特征空间切成一块块小区域,每块区域一个预测结果。
机器怎么知道哪个问题「值得问」? 需要给「不确定性」一个数值——这就是信息熵。
3. 数学表达 / 公式
3.1 信息熵:不确定性的度量
设样本集合中第 $k$ 类样本占比 $p_k$,集合的信息熵为:
$$H(D) = -\sum_{k=1}^{K} p_k \log_2 p_k$$
手算一次:
- 抛硬币(一半正一半反):$H = -(0.5 \log_2 0.5 + 0.5 \log_2 0.5) = 1$(最不确定);
- 全是正类:$H = -(1 \times \log_2 1) = 0$(毫无悬念);
- 10 个样本 6 正 4 负:$H = -(0.6 \times 0.737 + 0.4 \times 1.322) \approx 0.971$。
熵越大越乱,熵越小越纯。 划分数据的目标就是让熵降下来。
3.2 信息增益与 ID3
用特征 $A$ 把数据集 $D$ 划分后,划分后各子集的加权平均熵叫条件熵 $H(D|A)$。两者之差就是信息增益:
$$Gain(D, A) = H(D) - H(D|A)$$
熵降了多少,特征 A 就带来了多少信息。 ID3 算法在每个节点上选信息增益最大的特征划分。
手算一次:10 个样本(6 正 4 负),$H(D) = 0.971$。特征 A 把数据分成两组:
- A=1:4 个样本,4 正 0 负 → $H = 0$(纯了!);
- A=0:6 个样本,2 正 4 负 → $H = -(\frac{1}{3}\log_2\frac{1}{3} + \frac{2}{3}\log_2\frac{2}{3}) \approx 0.918$;
- 条件熵 $H(D|A) = \frac{4}{10} \times 0 + \frac{6}{10} \times 0.918 = 0.551$;
- **增益 $= 0.971 - 0.551 = 0.420$**——一刀下去,不确定性砍掉近一半,A 是好问题。
ID3 的毛病:信息增益偏爱「取值多的特征」。极端例子:拿「样本 ID」划分,每个 ID 一组、每组纯得不能再纯,增益最大——但对新样本毫无用处。C4.5 用信息增益率校正:用增益除以特征自身的熵,给「取值多」打折扣。
3.3 基尼指数与 CART
CART( Classification And Regression Tree)用另一个纯度指标——基尼指数:随机抽两个样本类别不同的概率:
$$Gini(D) = 1 - \sum_{k=1}^{K} p_k^2$$
手算(6 正 4 负):$1 - (0.36 + 0.16) = 0.48$。越纯越小,和熵同向。CART 是二叉树:每个特征与每个切分点都试一遍,选基尼指数下降最多的一刀。CART 也能做回归(回归树):切分后用子区域均值当预测值,选「平方误差最小」的切法——即最小二乘回归树。
| 算法 | 划分准则 | 树形 |
|---|---|---|
| ID3 | 信息增益 | 多叉 |
| C4.5 | 信息增益率 | 多叉 |
| CART | 基尼指数 / 平方误差 | 严格二叉 |
4. 决策树的生成与剪枝
生成流程(递归):① 全部数据放根节点 → ② 选最优特征划分成子集 → ③ 子集已基本分对则设为叶节点,否则继续选特征划分 → ④ 递归到无法划分(没有特征可用 / 已足够纯)为止。
生成只顾「训练集分得对」,容易长成巨树——把每个样本的细节都背下来(过拟合)。剪枝主动修剪树冠:
- 预剪枝:生长过程中提前踩刹车——限制最大深度、节点最少样本数、最大叶节点数等。省算力,但停得太早可能欠拟合;
- 后剪枝:先长满,再自底向上评估:裁掉某个子树、把父节点变成叶节点后,若验证集表现不降甚至更好,就剪。代价复杂度剪枝(CCP)、减少误差剪枝(REP)是代表方法。
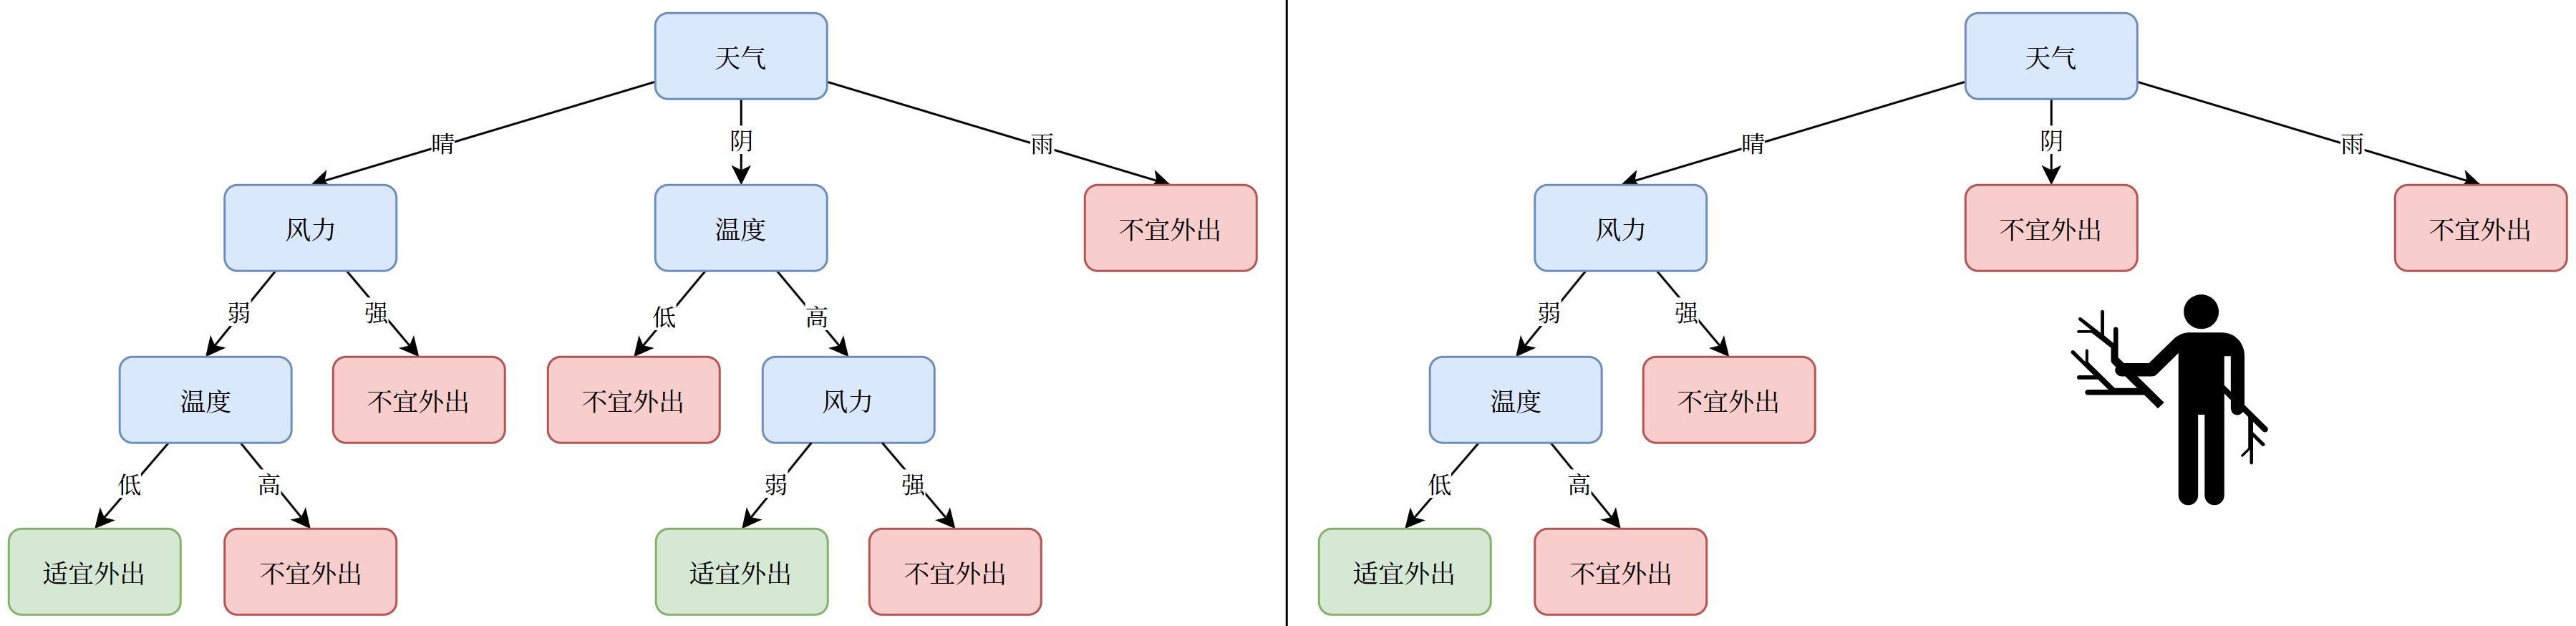
补充 一句话记住分工:生成只考虑局部最优(当前这一刀切最好),剪枝考虑全局最优(整棵树泛化最好)。
5. Python / sklearn 怎么实现?(补充)
1 | from sklearn.tree import DecisionTreeClassifier, DecisionTreeRegressor, plot_tree |
max_depth/min_samples_leaf/ccp_alpha(CCP 剪枝强度):预剪枝与后剪枝的旋钮,都用交叉验证调;- 回归用
DecisionTreeRegressor,叶节点输出子区域均值。
补充 两点:① 决策树不需要特征缩放——它只关心「特征值大于还是小于切分点」,单调变换不改变排序,这与 KNN/SVM 形成鲜明对比;②
feature_importances_基于「不纯度下降」,天然偏爱取值多、连续、切分机会多的特征,把它当参考即可——更稳妥的验证是sklearn.inspection.permutation_importance(打乱某个特征、看性能掉多少)。
第二部分:集成学习
6. 集成学习:三个臭皮匠
思路:单个模型各有偏差,把多个模型按某种策略组合起来,整体往往更强。只含同种模型的集成叫同质集成(如全是决策树,个体称基学习器);混搭不同模型叫异质集成。
三大经典套路:
| 套路 | 怎么组合 | 代表 | 主攻 |
|---|---|---|---|
| Boosting 提升 | 串行:后一个模型专门补前一个的错,最后加权表决 | AdaBoost、GBDT、XGBoost、LightGBM | 降偏差 |
| Bagging 自助聚合 | 并行:有放回采样出多个子数据集,各训一个独立模型,投票/平均 | 随机森林 | 降方差 |
| Stacking 堆叠 | 多个不同模型先预测,把预测值当新特征,再训一个「元模型」汇总 | —— | 融合各家之长 |
警告(Stacking 专属) 训练元模型时,基模型的预测必须来自交叉验证的袋外预测(OOF),不能用基模型在自己训练样本上的预测——后者是「自己给自己打工的成绩」,元模型会被严重误导(数据泄漏)。
补充 为什么 Bagging 降方差、Boosting 降偏差?Bagging 训出一群「独立又略不同」的模型,平均后各自的随机波动互相抵消(方差↓);Boosting 一路纠错,把「总体方向偏了多少」逐步修正(偏差↓)。
7. AdaBoost
出发点:一个「比瞎猜略好」的弱学习器(比如只看一个特征的决策树桩——单层决策树)遍地都是;已证明弱可学习与强可学习是等价的——能不能把一群弱者拼成一个强者?
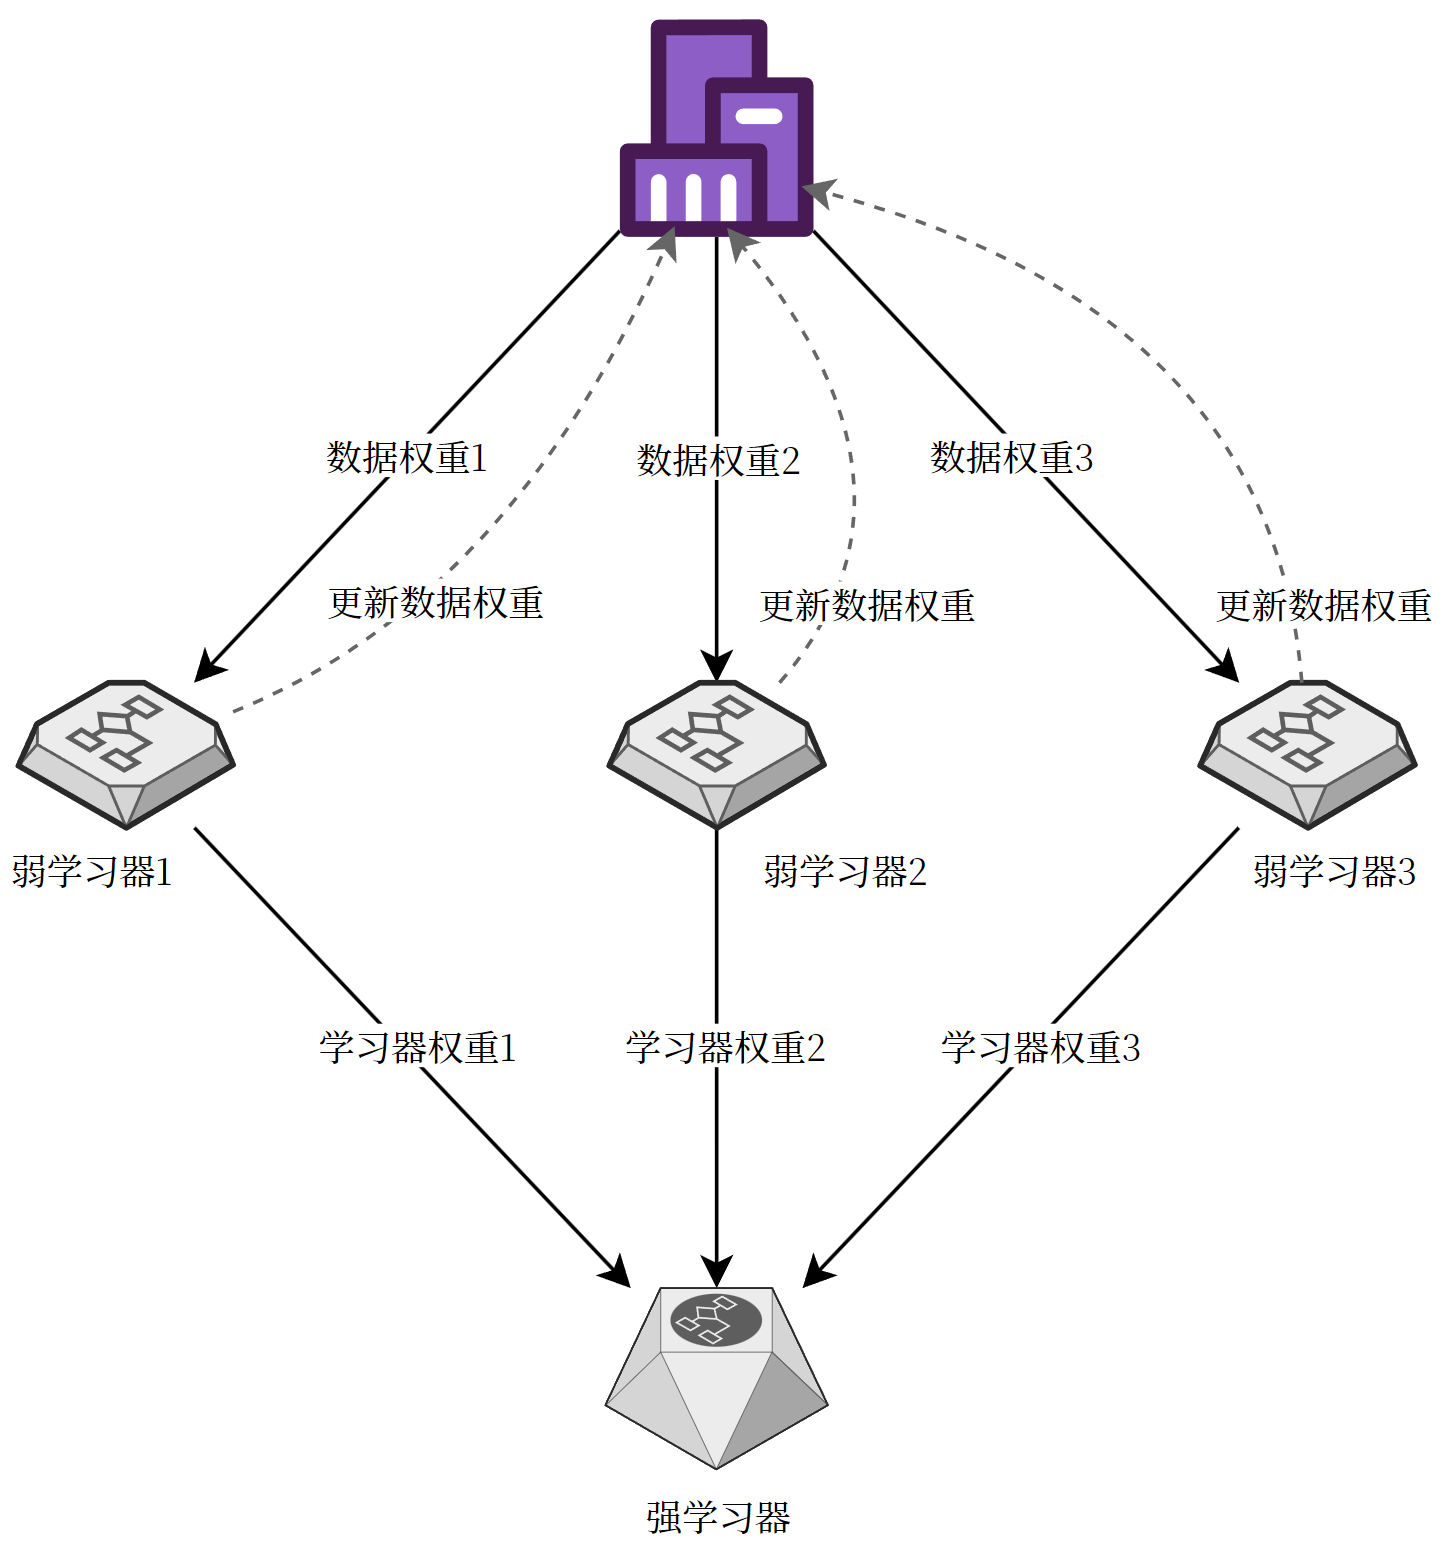
AdaBoost(Adaptive Boosting,自适应提升)的做法——两套权重联动:
- 初始化:每个样本权重相等;
- 训练一个弱分类器,计算它的错误率 $\varepsilon_m$;
- 提高被它分错的样本权重——下一轮弱学习器被迫专攻这些「钉子户」;
- 给这个分类器定发言权 $\alpha_m = \frac{1}{2}\ln\frac{1-\varepsilon_m}{\varepsilon_m}$——错得越少话语权越大;
- 重复 M 轮,最后按 $\alpha_m$ 加权表决所有弱分类器。
手算一次发言权:某轮错误率 $\varepsilon = 0.25$,则 $\alpha = \frac{1}{2}\ln\frac{0.75}{0.25} = \frac{1}{2}\ln 3 \approx 0.55$;若某轮 $\varepsilon = 0.5$(等于瞎猜),$\alpha = 0$——这轮白练,没有发言权。
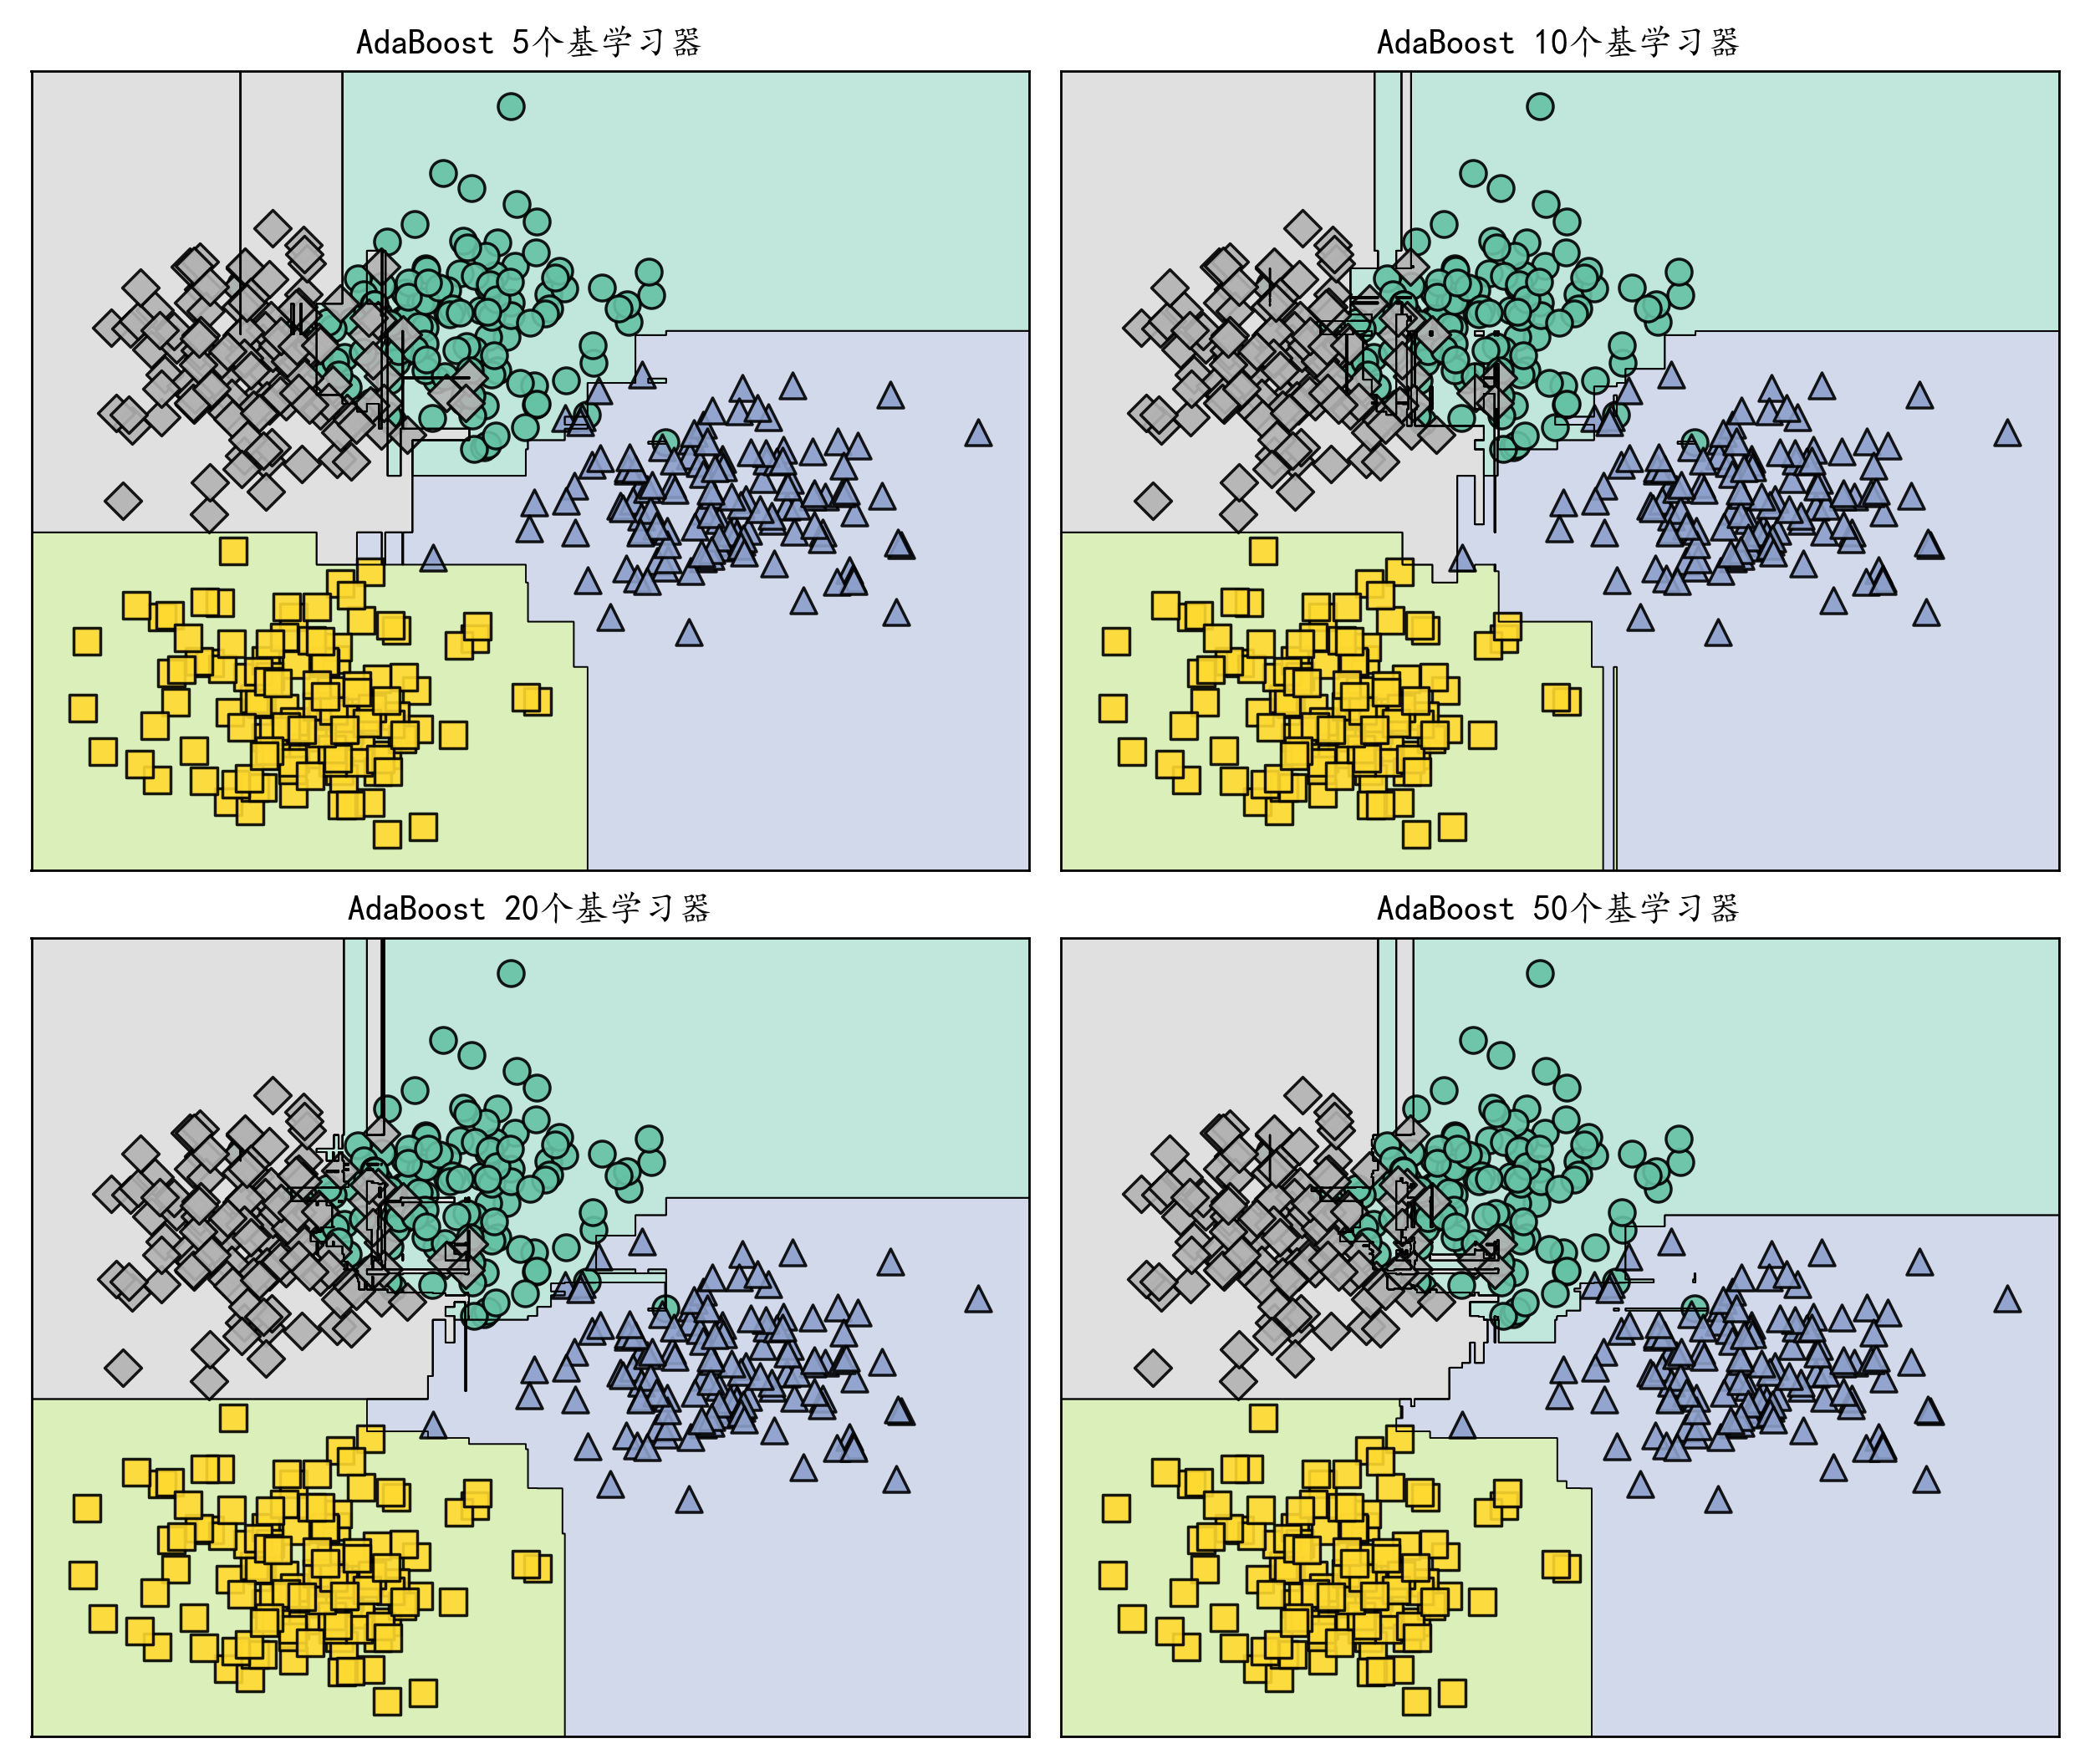
基学习器数量越多边界越稳:
警告 AdaBoost 对噪声和错标签敏感:它一轮轮提高「被分错样本」的权重,如果那个样本本身就是标注错误,模型会一直追着这个噪声跑——数据噪声较大时宜减少轮数、降低学习率,或换更稳健的变体。
8. 随机森林
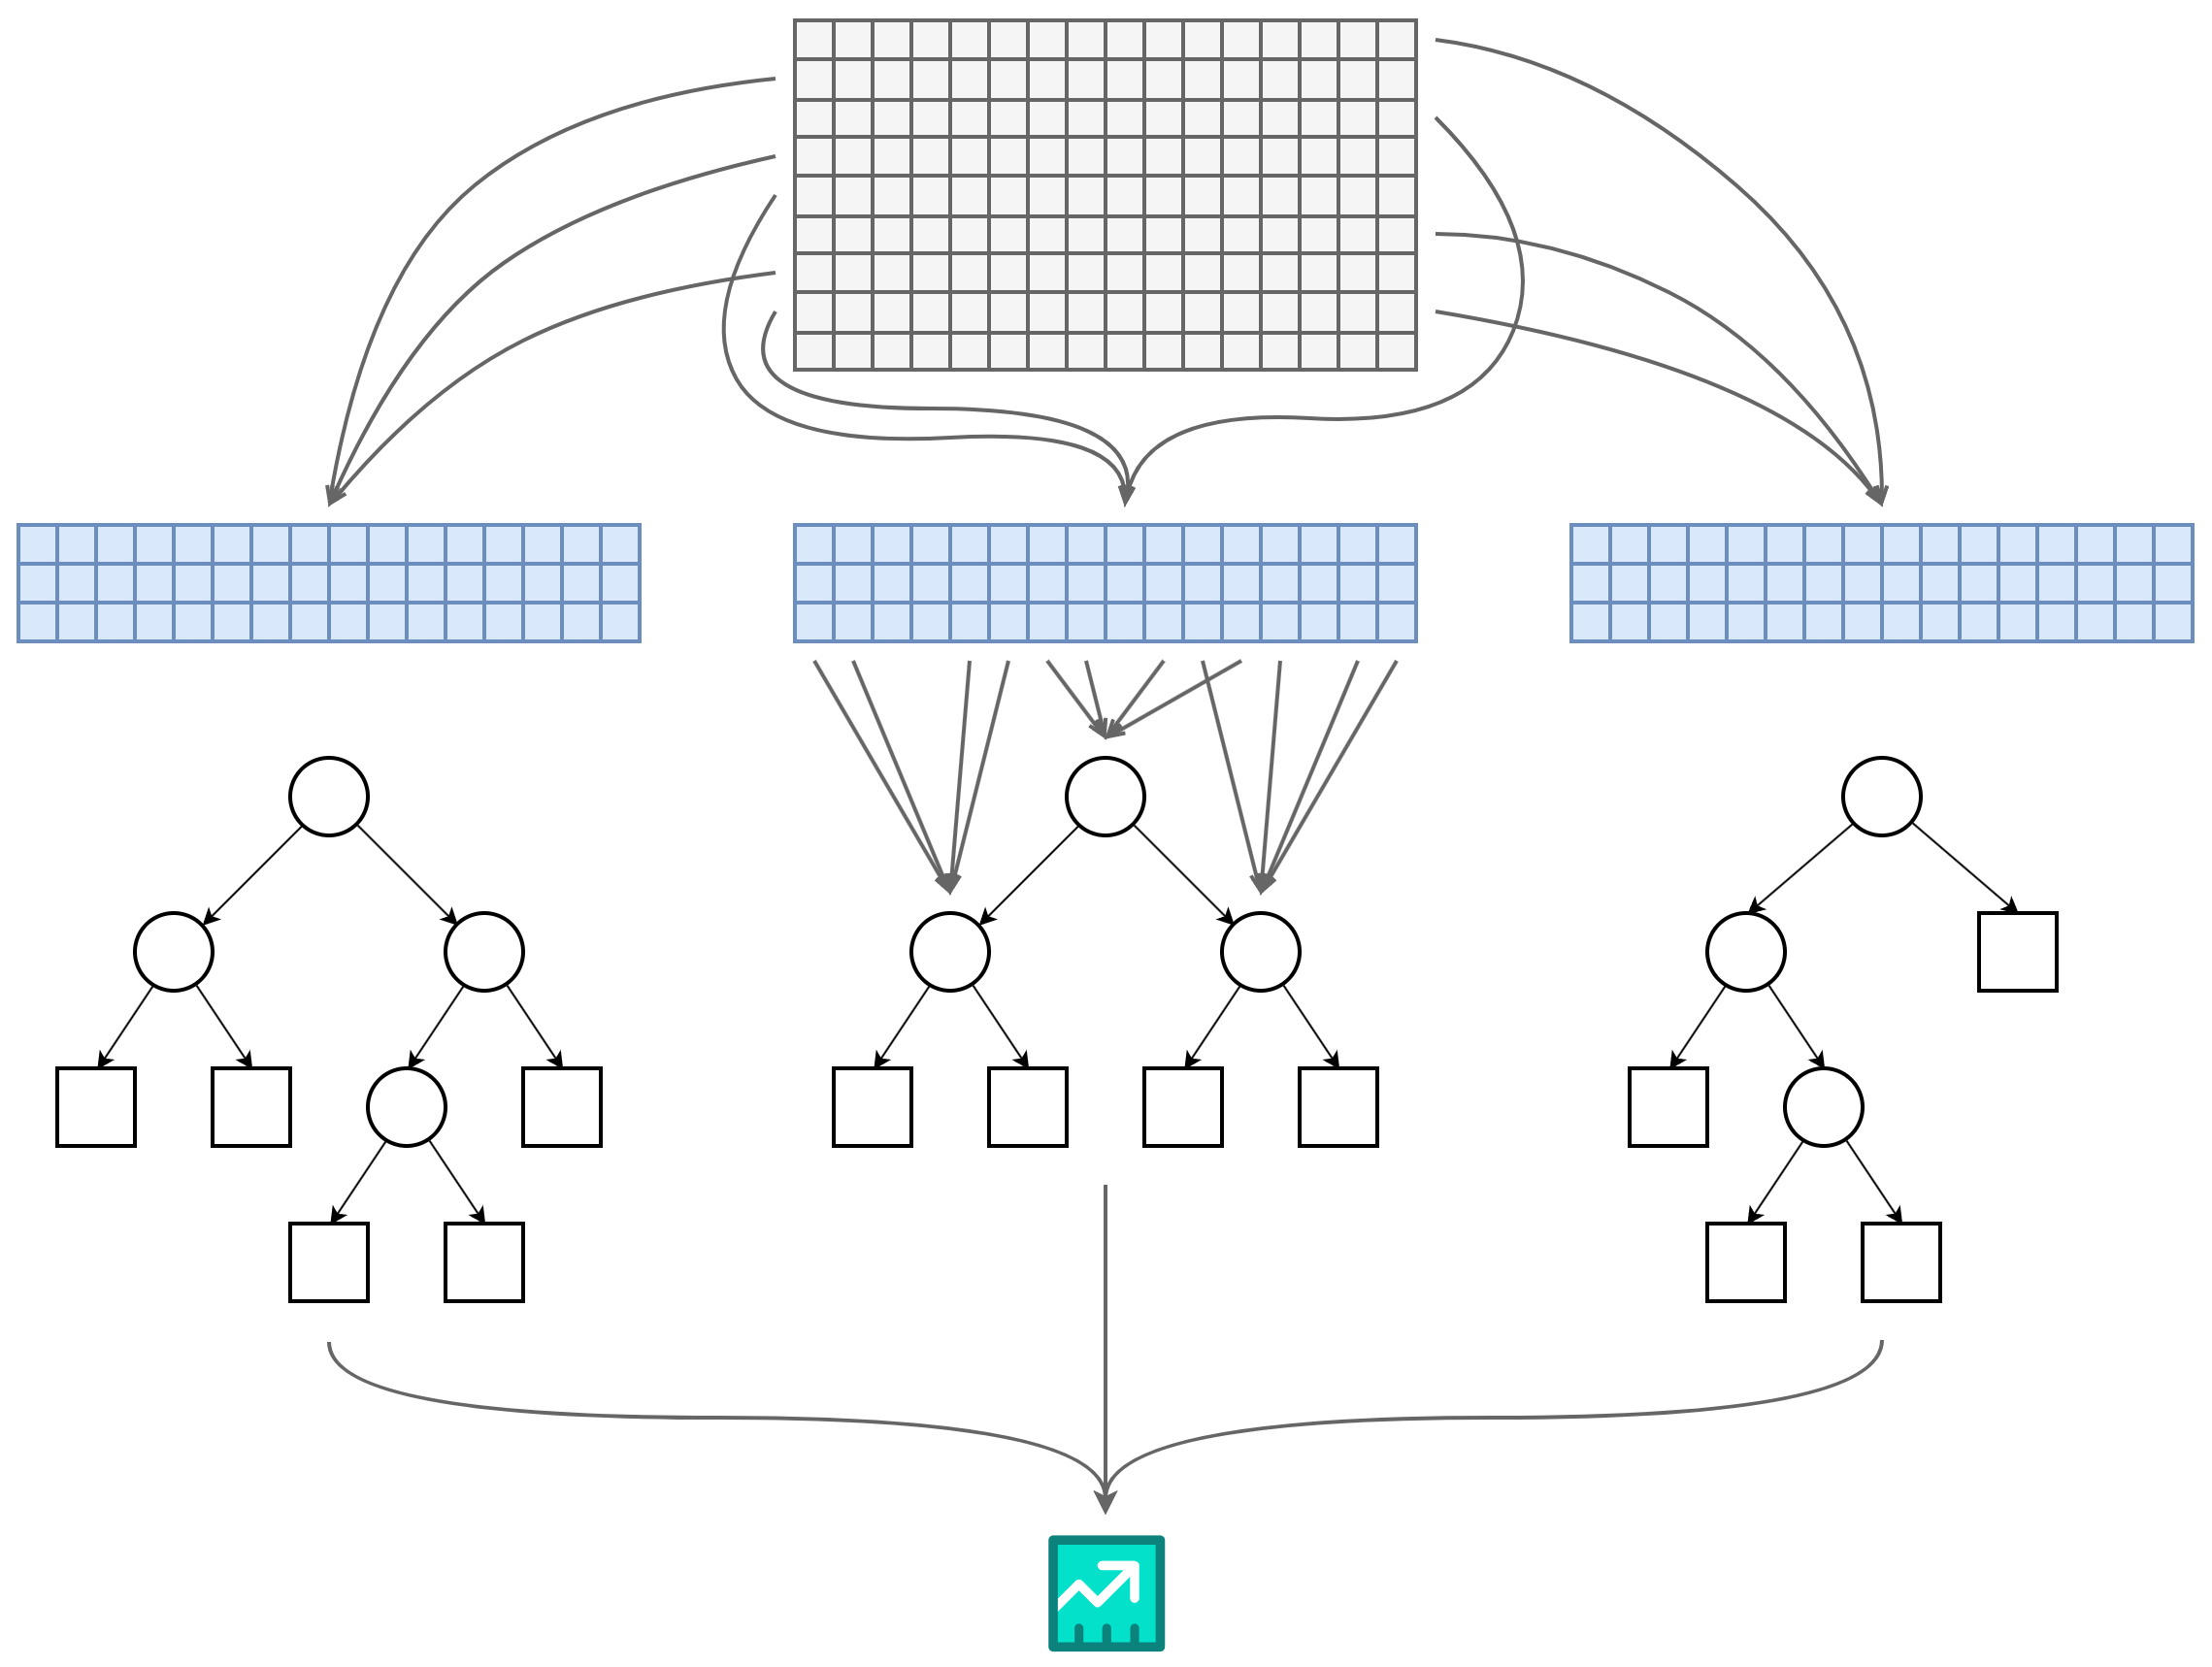
随机森林 = Bagging + 决策树 + 再加一层随机:
- 样本随机(Bagging 的老规矩):有放回采样,每棵树见到的数据都略不同;
- 特征随机(森林的独家配方):每个节点分裂时,先从全部特征里随机抽一个子集(常用 $\sqrt{d}$ 个),再从这个子集里挑最优特征。
手算感受:100 个特征的节点,每次分裂只在随机抽出的 10 个里挑——强特征不一定每棵树都用得上,逼着每棵树「换个角度看问题」,树与树差异被进一步拉开。
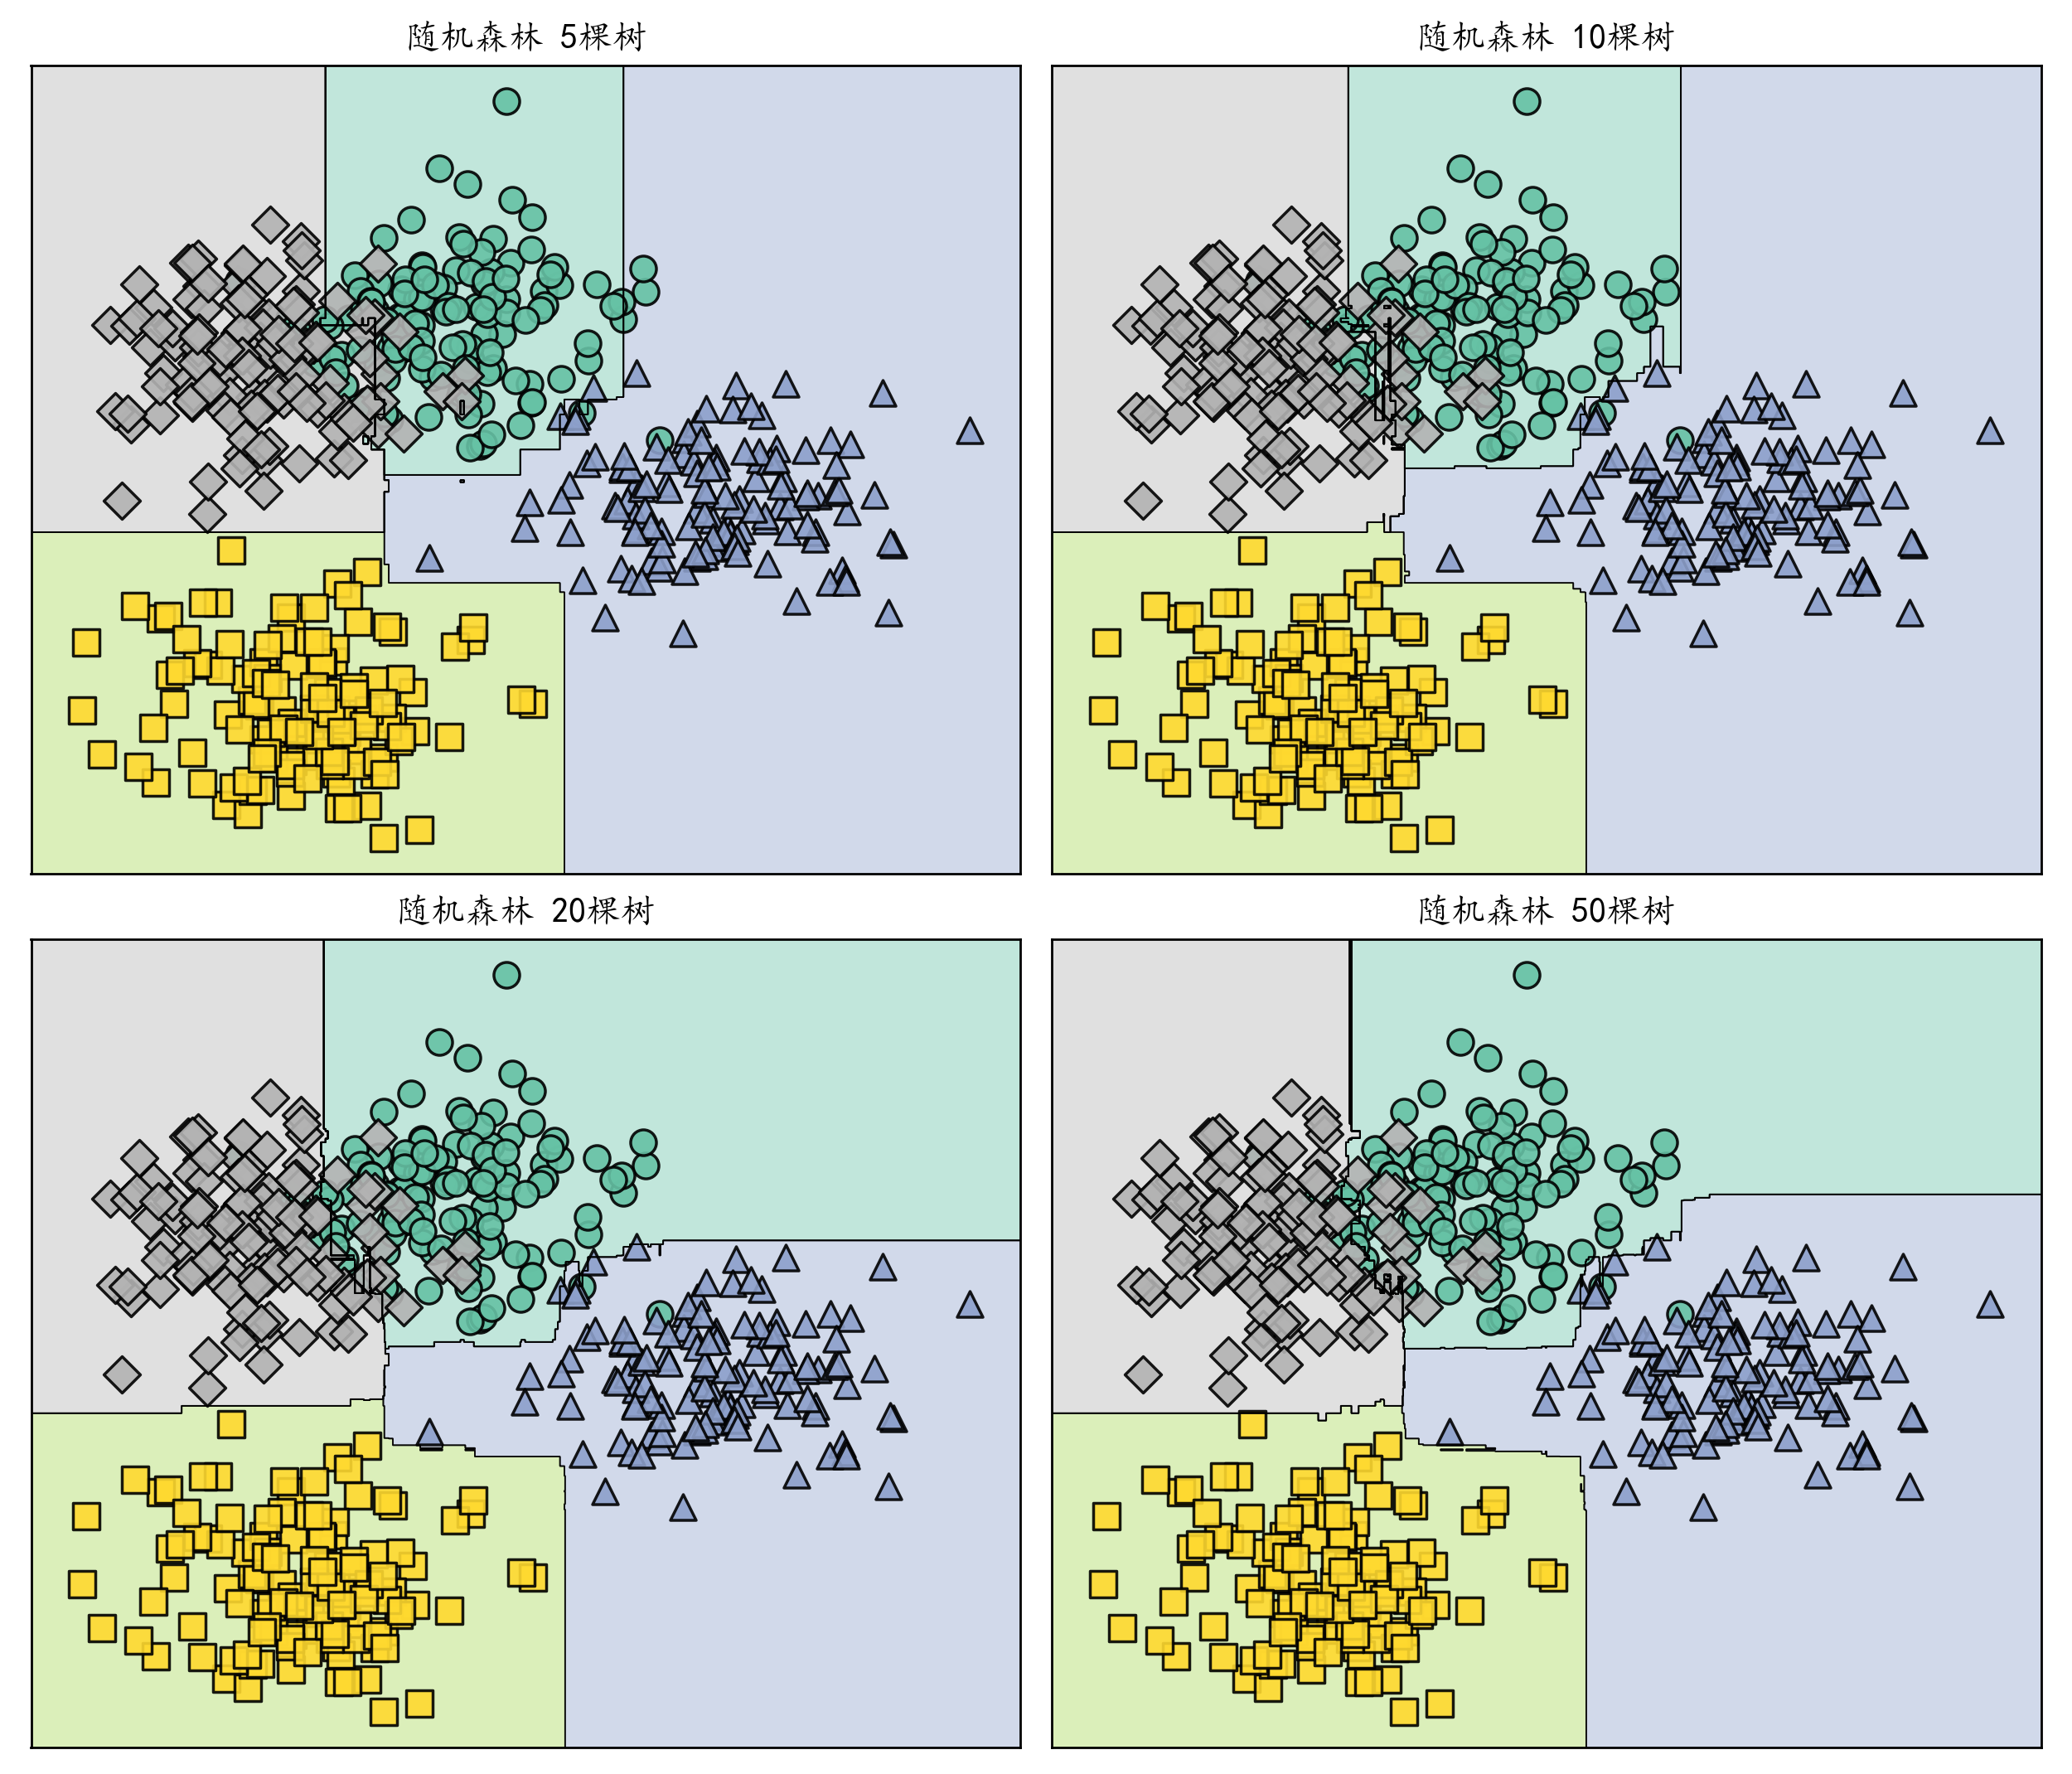
树越多,投票结果越稳定:
补充 OOB(袋外估计):自助采样时每棵树约有三分之一样本没被抽到(袋外样本),它们正好可以当这棵树的「内部验证集」——
oob_score=True就能免费得到一个泛化估计,不必再单独划验证集。
为什么双重随机反而更强?Bagging 的多样性只来自样本扰动,森林还多了特征扰动——基学习器之间差异越大,投票抵消错误的能力越强,泛化性能越好。随机森林简单易用又性能强大,被誉为「代表集成学习技术水平的方法」。
1 | from sklearn.ensemble import RandomForestClassifier, AdaBoostClassifier |
9. 易混淆点
| 易混对 | 一句话区分 |
|---|---|
| 信息熵 vs 基尼指数 | 都是「不纯度」尺子:熵带对数、基尼是概率平方;CART 用基尼,ID3/C4.5 用熵系 |
| 信息增益 vs 增益率 | 增益偏爱取值多的特征(ID 号陷阱);增益率 = 增益 ÷ 特征自身熵,C4.5 的修正 |
| 预剪枝 vs 后剪枝 | 生成时踩刹车(快、可能欠拟合)vs 长满再回剪(效果好、更耗时) |
| Bagging vs Boosting | 并行独立投票降方差 vs 串行纠错加权降偏差 |
| 随机森林 vs 普通Bagging | 森林 = Bagging + 每次分裂再随机抽特征子集,多样性来自双重扰动 |
| 决策树桩 vs 完整决策树 | 只有 1 层分裂的「残废树」,AdaBoost 默认的弱学习器 |
| 特征重要性 vs 相关系数 | 重要性来自「该特征参与划分的次数与质量」,不表示因果方向 |